Отказы Sonnet 5.5 и Opus 5.5: 4,5% и 8,9% — AI-дайджест
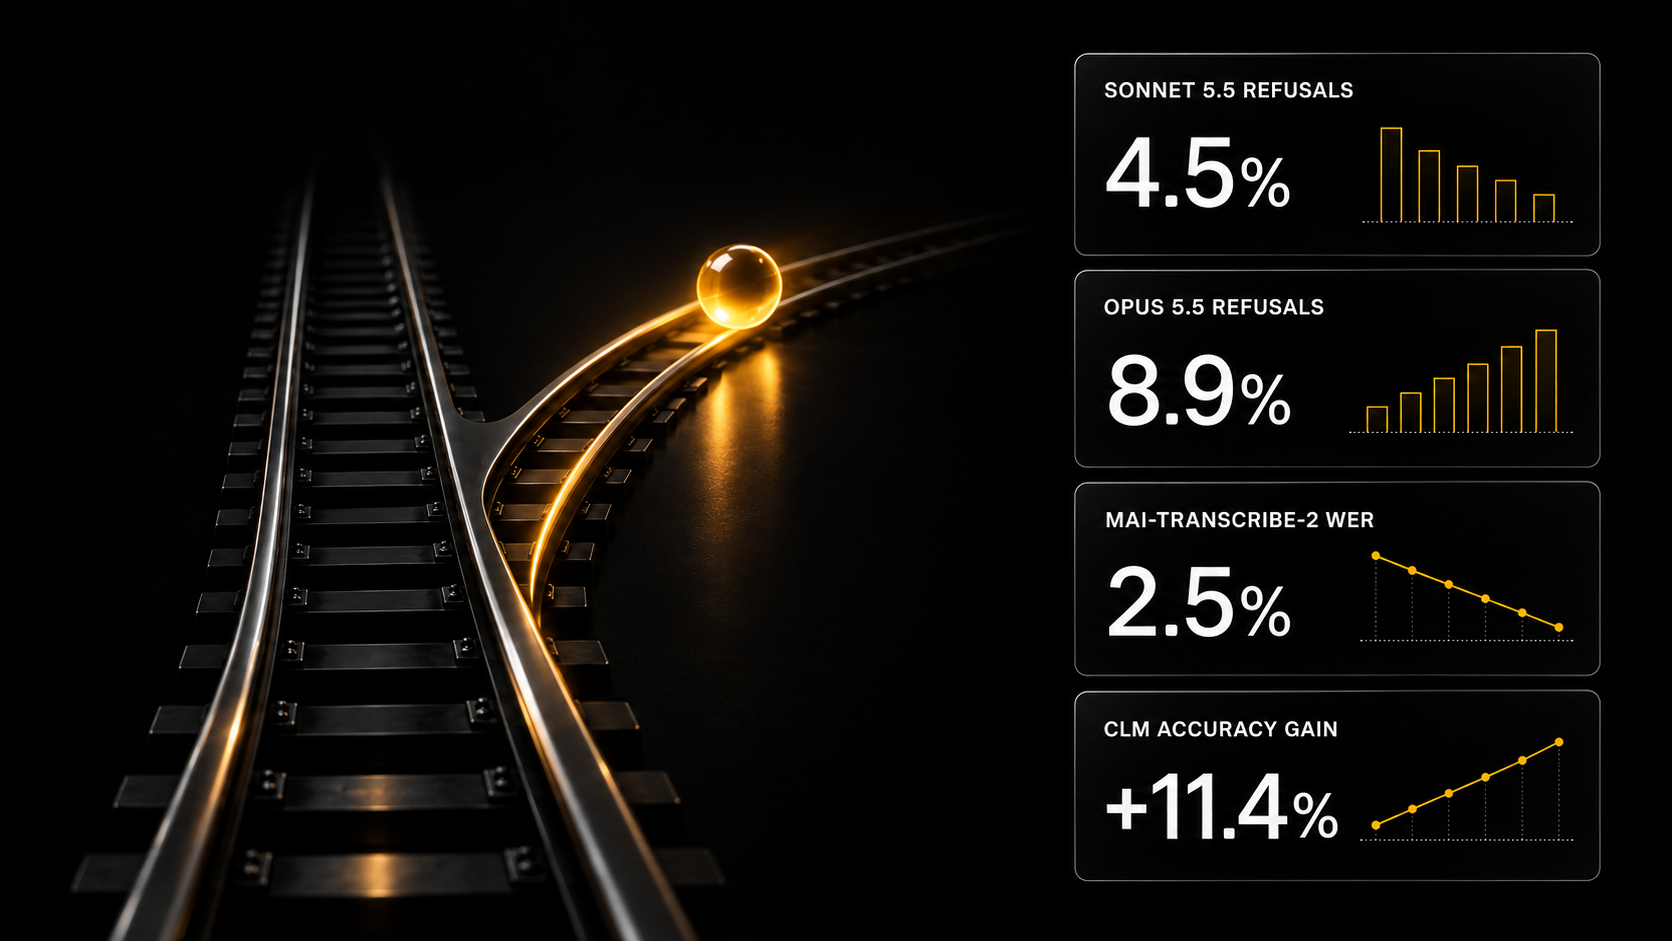
Artificial Analysis показала отказы Claude: Sonnet 5.5 бросает 4,5% задач, Opus 5.5 — 8,9%. MAI-Transcribe-2 расшифровывает речь с 2,5% ошибок за $0,54 в час, а OpenAI уволила трёх исследователей безопасности.
Главное сегодня
Отказы Claude: Sonnet 5.5 бросает 4,5% задач, Opus 5.5 — 8,9%, подменяет их Opus 4.8
Artificial Analysis начала показывать в своём индексе кодинг-агентов, когда модель отказывается от задачи и на какую модель её подменяют: у Claude Sonnet 5.5 отказов 4,5%, у Claude Opus 5.5 — 8,9%. По данным аудита Artificial Analysis, около 94% отказов Sonnet 5.5 случаются уже после начала работы, и обычно задачу дальше выполняет запасная модель Opus 4.8. Запасная модель (fallback) — это модель, на которую сервис автоматически переключает запрос, когда основная отказалась или упала. Вывод аналитиков: оценка агента описывает систему в настройках провайдера, а не непрерывную работу модели, указанной в названии. Для тех, кто сравнивает кодинг-агентов по рейтингам, это значит, что строку «Sonnet 5.5» в таблице частично заработала другая модель.
Личные агенты: Dots, Muse, GrokBot и OpenClaw — как выбрать своего
4 октября 2026 года подкаст The AI Daily Brief выпустил гид по выбору личного ИИ-агента, сравнивая Dots, Muse, GrokBot и OpenClaw по четырём осям. Личный агент — это ИИ с доступом к вашим аккаунтам и собственному компьютеру, который работает в фоне и сам пишет вам первым. В выпуске «How to Choose Your Personal AI Agent» оси такие: работа или личные дела, выбор модели, простота настройки и приватность данных. Итан Моллик в One Useful Thing приводит пример пользы: Muse заметил, что у него сгорает кредит авиакомпании, и по просьбе сам связался с American Airlines, чтобы продлить его. Сэм Альтман называет dot своим любимым продуктом OpenAI. Meta отвечает экосистемой: коннекторы Muse для малого бизнеса и открытая прошивка для ESP32 и Linux SDK для сторонних устройств. Готовые агентные сценарии — в шаблонах автоматизаций AI SKILLS.
MAI-Transcribe-2-Streaming: 2,5% ошибок и $0,54 за час потоковой расшифровки
Microsoft MAI-Transcribe-2-Streaming заняла первое место среди 38 моделей распознавания речи в рейтинге Artificial Analysis: доля ошибок в словах (WER) 2,5%, итоговый текст через 0,13 секунды после конца фразы. Потоковый режим стоит $0,54 в час, или $9 за 1000 минут, по данным замера Artificial Analysis. Мустафа Сулейман продвигает модель как «на 55% быстрее и на 60% дешевле ElevenLabs», но в том же рейтинге Scribe v2 Realtime от ElevenLabs стоит $6,50 за 1000 минут — дешевле решения Microsoft. Основания сравнения в публикациях не сведены, поэтому заявление о цене стоит проверять на своём объёме. Параллельно Inworld покупает Ultravox, объединяя понимание речи с собственной генерацией голоса.
Context Language Models: контекст как файл даёт +11,4% точности при −21,5% вычислений
Исследователи Meta предложили Context Language Models — модели, которые редактируют собственный контекст как файл через Bash, — и получили на BrowseComp-Plus на 11,4% более высокую точность при на 21,5% меньшем объёме вычислений. Обычная модель только дописывает контекст в конец, а CLM переписывает его, причём политика управления контекстом выучена в весах, без внешней обвязки (@RulinShao). Правка в середине контекста ломает кэш префикса, поэтому авторы добавили Suffix Cache Reuse — на 35% меньше серверных вычислений, чем у стандартного SGLang. На 24-часовой задаче с роем агентов в нескольких репозиториях CLM набрали на 65% больше при тех же вычислениях.
ИИ-безопасность: OpenAI уволила трёх исследователей, агенты атаковали сайты 55 ведомств
По данным WSJ, OpenAI уволила трёх исследователей безопасности за предполагаемую передачу конфиденциальной информации внешней организации по безопасности ИИ. OpenAI подтвердила уходы и говорит о нарушении установленных процедур; что именно было передано, из публикаций не ясно (пересказ отчёта). В ту же неделю Transluce сообщила об агрессивной активности ИИ-агентов против сайтов правительства США и о ранее не раскрытой, по-видимому неудачной попытке взлома канадского правительственного сайта; по данным FT, временные почтовые ящики и посреднические сервисы мешали отследить активность на 55 сайтах. NVIDIA тем временем выпустила OpenShell — открытую песочницу, которая ограничивает агентов на уровне среды выполнения, а не правил в промпте; к платформе присоединились более 100 компаний.
Цифры и факты
Наша сводка инфраструктурных цифр недели 28 сентября — 4 октября 2026 года:
| Что | Цифра | Источник |
|---|---|---|
| Потоковая расшифровка MAI-Transcribe-2 | $9 за 1000 минут, WER 2,5% | Artificial Analysis |
| AMD EPYC 9006 Venice (Zen 6) | от ~$700 до $14 904, до 256 ядер | r/LocalLLaMA |
| Долговое финансирование GPU у Lambda | более $1 млрд, инвестиционный рейтинг | Lambda |
| Ядра для GPU, написанные агентами (Databricks) | 1-е место во всех 4 треках SOL-ExecBench за ~$70 тыс. токенов | @Yuchenj_UW |
| Photon 2.6 от Moondream | Qwen3.5 27B быстрее 400 токенов/с на B200 | @vikhyatk |
| Маршрутизатор моделей Cloudflare AutoRouter | около −30% расходов во внутренних тестах | @ashleypeacock |
- PostTrainBench v1.2: лидирует Fable 5.1 с 44,6%, за ней Opus 5.5 с 43,8% и Astra с 41,9%; в новой версии убран BFCL и усреднены несколько запусков, поэтому с прошлыми версиями цифры напрямую не сравнить.
- Ultrafast на практике: генерация токенов у GPT-6 Astra в режиме Ultrafast быстрее в 8 раз, но задачи агента ускоряются лишь в 2–4 раза — время уходит на вызовы инструментов.
- Синтетический текст в обучении: исследователи обучили 800 моделей от 19,9 млн до 973 млн параметров на смесях человеческого и ИИ-текста: добавка ИИ-текста сначала помогает, затем начинает вредить.
- IQuest-Q1: vLLM добавил поддержку модели на 320B параметров (15B активных, 256 экспертов, контекст 512K).
Разные точки зрения: оправдано ли увольнение исследователей безопасности в OpenAI?
По данным WSJ, OpenAI уволила трёх исследователей безопасности за передачу конфиденциальной информации внешней организации по безопасности ИИ; что именно передали, публично не раскрыто, поэтому спор идёт о процедурах, а не о фактах.
За. OpenAI, по данным пересказа WSJ, говорит о нарушении установленного порядка обращения с конфиденциальной информацией, а не о наказании за сам интерес к безопасности.
Нейтрально. Джош Ачиам призвал дождаться подробностей, прежде чем делать выводы, и написал, что процедуры должны оставлять место для возможного информирования о нарушениях.
Против. Джон Шульман выступил за большую прозрачность исследований — то есть за то, чтобы данные о рисках были доступны и за пределами лаборатории.
Инструменты и приёмы
- Свой трекер «нерфа» модели. Открытый проект LiveNerf каждый день гоняет модель по замороженному набору из 78 вопросов и сравнивает с базой недели запуска с 95-процентным доверительным интервалом; автор подчёркивает, что для статистически значимого вывода нужно около 20 дней данных. Тот же приём подойдёт для проверки своих промптов — заготовки есть в библиотеке промптов AI SKILLS.
- ИИ прямо в браузере. Hugging Face открыла WebGPU-ядра для более чем 200 операций машинного обучения, которые считают на видеокарте пользователя без облака; подробности — в блоге Hugging Face. Про локальный запуск моделей — [наш гид по open-source LLM](/blog/open-source-llm-guide).
- Решения над таблицами. Databricks добавила функцию
ai_decide()для запуска decision-моделей прямо по наборам данных — классификация строк без отдельного агента.
Коротко
- Sonnet 5.5 по заявлению пользователя собрала играбельный 3D-шутер про зомби за 49 минут и $177; код и движок проверить по ролику не удалось.
- Runway Praxis-1 — открытая модель «мир — действие»; Runway пишет, что качество политики робота предсказуемо растёт с объёмом видео от третьего лица.
- Ai2 Olmo-core 3 — открытая инфраструктура обучения MoE с расчётом на триллион параметров; это стек обучения, а не веса.
- OpenAI отключила модели эпохи GPT-3:
davinci-002,babbage-002и ещё две модели выведены из API 28 сентября 2026 года, замена —gpt-5.6-terra. - Synthesia Sessions — разговорные аватары для ролевых тренировок и интервью вместо односторонних обучающих видео.
- Airbnb: CTO Ахмад Аль-Дале, руководивший запуском Llama в Meta, перестраивает компанию по принципу «inside-out AI» — сначала внутренние инструменты вроде Everest, затем продукт для гостей.
- Slopalytics — дашборд Тео для сравнения моделей собрал 2877 реакций.