Как заставить персонажа говорить: разбор Lip Sync без съёмки
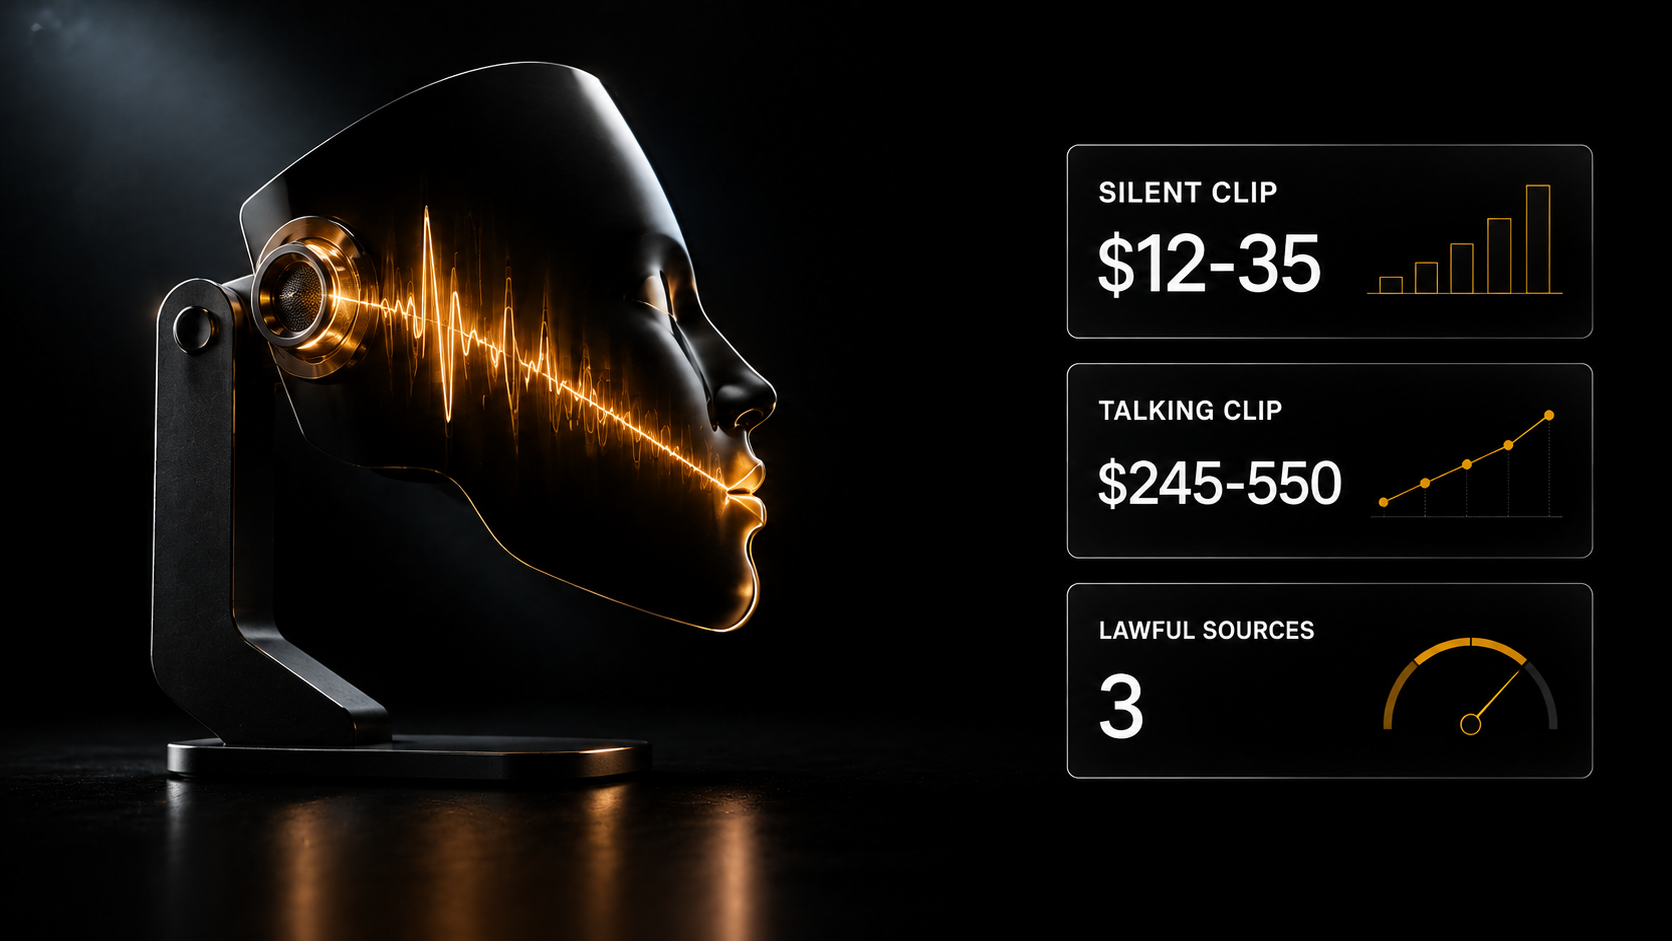
Молчащая картинка и говорящий кадр — разные категории работы: первая стоит десятки долларов, вторая сотни. Ниже что нужно на входе, где технология подводит на длинной речи и эмоциях, и три законных источника лица для коммерческой работы.
Молчащая картинка и говорящий кадр — разные категории работы: первая стоит десятки долларов, вторая сотни. Ниже что нужно на входе, где технология подводит на длинной речи и эмоциях, и три законных источника лица для коммерческой работы.
Коротко, если нет времени
Молчащая картинка и говорящий кадр — разные категории работы: первая стоит десятки долларов, вторая сотни.
Lip Sync — это синхронизация губ с озвучкой, и на входе ему нужны три вещи. Каждая влияет на результат сильнее, чем выбор модели.
Технология подводит на длинной речи и сильных эмоциях — знать это надо до того, как брать заказ.
Отдельная генерация даёт один кадр: ролик собирается цепочкой, где кадр, озвучка и синхронизация идут шагами.
Разрыв в цене по рынку виден на цифрах: изображение поштучно — $12–35, короткий ролик — $18–45, ИИ-видео под ключ — $245–550.
Себестоимость известна до нажатия: Lip Sync — $0.12–1.50 за генерацию, озвучка и музыка — $0.12–1.80.
Права на лицо важнее технологии: это единственный вопрос, который решает, можно ли вообще сдавать работу клиенту.
Молчащий персонаж — это половина работы
Вы научились генерировать людей. Кадр красивый, лицо держится, свет живой.
А заказчику нужен ролик, где человек говорит. Отзыв о товаре, объяснение услуги, приветствие на лендинге.
И тут выясняется, что молчащая картинка и говорящий кадр — разные категории работы. Первая стоит десятки долларов, вторая — сотни.
Разберём, как это устроено, где граница и что нужно на входе.
Что такое Lip Sync простыми словами
Синхронизация губ с озвучкой. Вы даёте изображение или видео с человеком и звуковую дорожку — модель заставляет персонажа произносить этот текст, попадая губами в звук.
Ключевое: это не генерация видео с нуля. Кадр уже есть. Модель добавляет ему движение рта и мимику под конкретную речь.
Отсюда главное следствие: качество результата упирается в качество исходника. Плохой кадр говорящим лучше не станет.
Что нужно на входе для липсинка
Три вещи, и каждая влияет на результат сильнее, чем выбор модели.
1. Кадр с лицом
Что нужно: лицо крупно и целиком в кадре, анфас или лёгкий поворот, рот видно полностью, ничего его не перекрывает.
Что ломает результат: сильный поворот головы, рука у лица, крупные очки с бликом, борода, скрывающая линию губ, слишком мелкое лицо в кадре.
Проверка простая: если вы сами с трудом видите губы на исходнике, модель тоже не справится.
2. Звуковая дорожка
Что нужно: чистая речь без фонового шума, ровный темп, внятная артикуляция.
Что ломает: музыка на фоне, эхо помещения, слишком быстрая речь, наложенные голоса.
Дорожку можно записать самому, взять готовую озвучку или сгенерировать — в Gen AI есть озвучка и клон голоса.
3. Соответствие длины
Речь и кадр должны совпадать по длительности. Тридцать секунд звука на пятисекундном ролике — это либо обрезка, либо продление, и то и другое надо предусмотреть заранее.
Где технология подводит
Честно, потому что от этого зависит, что можно брать в работу.
Долгая речь. Чем длиннее фрагмент, тем заметнее накапливается рассинхрон и однообразие мимики. Короткие реплики работают надёжнее длинных монологов.
Эмоции. Модель попадает в звук, но не всегда в интонацию. Гнев, ирония, сомнение читаются слабо — лицо остаётся ровным при любом содержании речи.
Профиль и движение. Чем сильнее голова повёрнута или движется, тем хуже результат.
Мелкая мимика. Живой человек при разговоре двигает бровями, щурится, кивает. Синтетический — в основном ртом. Именно это выдаёт результат чаще, чем сама синхронизация.
Что из этого следует практически: Lip Sync хорош для коротких реплик крупным планом. Для трёхминутного монолога с эмоциями — пока нет.
Как это собирается в цепочку
Отдельная генерация — это один кадр. Рабочий процесс выглядит иначе.
Полная цепочка: текст → озвучка → кадр с персонажем → синхронизация губ → сборка со звуком → готовый ролик.
Каждый шаг отдельно означает скачать-загрузить-скачать. Чтобы не собирать это руками, задачу можно отдать в Cerebrum: описываете ролик обычными словами, нужные модели Gen AI подбираются сами, оплата с баланса по факту, цена видна до запуска. То же делает коннектор AI SKILLS для Claude (тариф Full): в Claude описываете задачу — он генерирует кадры, видео и голос моделями Gen AI и монтирует ролик.
Почему говорящий кадр стоит дороже
Сравните с рынком. По моей выгрузке на 5 986 заказов за четыре месяца:
- Изображение поштучно — $12–35
- Короткий ролик — $18–45
- ИИ-видео под ключ — $245–550
- До $610 за готовый ролик по сдельной схеме
Разрыв между роликом и «под ключ» больше чем в десять раз, и он не про качество генерации. Во втором случае продаётся результат целиком: сценарий, озвучка, синхронизация, сборка, формат под площадку.
Говорящий персонаж — это то, что переводит вас из первой строки в четвёртую. Не потому, что технически сложнее, а потому, что закрывает задачу заказчика: ему нужен не кадр, а ролик, который можно поставить в рекламу.
Отдельно про самый массовый спрос: категория «ИИ-креаторы» стоит у 86% заказов ленты, и внутри неё ролики с человеком в кадре — самый частый запрос. Это ровно то, где говорящий персонаж и нужен.
Себестоимость говорящего ролика
Генерация оплачивается с кошелька по факту, цена видна до нажатия, при сбое деньги возвращаются.
Порядок величин: Lip Sync — $0.12–1.50 за генерацию в зависимости от модели, озвучка и музыка — $0.12–1.80, оживление кадра — от $0.17.
То есть себестоимость говорящего ролика измеряется единицами долларов при чеке в десятки и сотни. Главное — закладывать её в смету сразу.
Права на лицо: важнее технологии
Один вопрос, который решает, можно ли вообще сдавать такую работу клиенту.
Чужое лицо использовать нельзя. Ни знаменитость, ни человека со стока, ни фотографию из интернета. Это не про качество, а про то, что заказчик получит претензию, а вы — репутацию.
Три законных источника:
Ваше собственное лицо. Селфи, и вы герой рекламы.
Обученный персонаж. Постоянный герой с неизменной внешностью, который хранится в профиле и подставляется в любую генерацию.
Готовые аватары из галереи — десять персонажей под разные роли. Все сгенерированы нами, это не стоковые люди и не чужие лица, вопросов по правам не возникает.
Последний пункт для коммерческой работы решающий: вы можете отдать заказчику ролик и не думать о том, чьё лицо в кадре.
Что для липсинка есть на платформе
Gen AI — Lip Sync 13 моделей, оживление фото 84 модели, музыка и звук 19, клон голоса. Всё в одном разделе, оплата по факту.
Cerebrum — если не хотите собирать цепочку: описываете оффер и задачу, прикладываете ссылку на фото товара, получаете вертикальный ролик со звуком. Нужные модели Gen AI подбираются сами, оплата с баланса по факту.
Экспресс-курсы по видеомоделям — «Видео-нейросети 2.0» и «Google Veo 3» — тариф Plus, по $9 разово или за 1 000 очков опыта. В три бесплатных дня Basic не входят.
Регистрация бесплатная и открывает три дня Basic — ассистенты категории «Креатив», включая эксперта по анимации и видеомонтажу, и энциклопедию из 198 сервисов.
С чего начать сегодня
Одно действие. Возьмите своё селфи, запишите на телефон пятнадцать секунд чистой речи и прогоните через Lip Sync.
Пятнадцать секунд — не случайная длина: на ней технология работает уверенно, и вы сразу увидите реальное качество, а не идеальный демонстрационный пример.
Если результат годится — у вас появилась категория работ, которая стоит на порядок дороже статичных картинок.
Где брать голос и как собирать целиком
Синхронизация губ — предпоследний шаг. До неё нужен звук, после — сборка.
В Gen AI режим Lip Sync — 13 моделей, цена генерации $0.12–1.50.
Голос. В готовом шаблоне n8n «Ежедневная генерация коротких видео из таблицы» озвучку делает ElevenLabs — профессиональная дикция из текста. Это же решает вопрос длинных реплик: живая запись не нужна.
Сборка. В том же шаблоне Creatomate склеивает видеоряд и звук в один ролик. Шаблон продвинутый: Full, либо $9 разово, либо 1000 XP.
Готовое решение целиком
Готовые шаблоны n8n с говорящим аватаром: «Видеообзор веб-страницы с ИИ-аватаром» превращает страницу по ссылке в короткий ролик, а «Новостные видео с ИИ-аватаром HeyGen» — свежую новость в видео с говорящим аватаром. Для маркетологов, преподавателей и авторов личного бренда, которым нужны регулярные видео без съёмочной группы и студийного света.
Оба шаблона продвинутые: Full, либо $9 разово, либо 1000 XP.
Липсинк как режим платформы
Gen AI, режим «Lip Sync» — 13 моделей, от $0.12 до $1.50 за генерацию. Персонаж на фото или в видео начинает говорить нужный текст. Оплата с кошелька, цена видна до запуска.
Cerebrum — те же задачи словами: оживить фото, заставить персону говорить (четыре кадра на выбор, потом озвучка и липсинк), перенести движение из ролика-донора. Нужные модели Gen AI подбираются сами, оплата с баланса по факту, цена видна до запуска.
Голос. В Gen AI — клоны голоса MiniMax и Suno, диалоговый TTS до четырёх спикеров с разным темпом, акцентом и характером.
Разбор моделей — экспресс-курс «Видео-нейросети 2.0 — «Восток против Запада»» (Kling 3.0 и Seedance 2.0), $9, тариф Plus и выше: работа со start/end frame для бесшовных склеек и Multi-shot для многокадровых сцен.
Ассистенты, тариф Basic: Kling 3.0 Master-Mind, Промпты Seedance 2.0, Эксперт по видеомонтажу.
Скиллы под говорящую голову
Все шесть — продвинутые скиллы (Creator+, либо разово $9, либо 1000 XP); карточки и описания открыты всем.
- Липсинк и говорящее видео из фото — синхронизация губ, движений головы и мимики с дорожкой. Два режима: из одного фото и перезапись звука в готовом видео. Режим потока в этом скилле снимает ограничение на длину — то самое, на чём обычно ломаются длинные монологи (у моделей Lip Sync в Gen AI, о которых речь выше, трёхминутный монолог пока ненадёжен)
- Липсинк: разбор режимов и настроек — та же механика подробнее: сила привязки к аудио, разрешение, встроенная озвучка из текста вместо готового файла, диалог на два голоса
- Говорящий аватар: производство — про требования к исходному портрету и настройку тона речи. Большинство неудач начинается здесь, а не на генерации
- Аватары с липсинком и озвучкой — вторая реализация с акцентом на многоперсонажные сцены и жесты
- Подкаст с говорящими аватарами — если в кадре двое: персонажи, озвучка каждой реплики, склейка. Клипы генерируются по очереди, а не разом
- Аватар-продавец для видеорекламы — готовая раскадровка на пять сцен по пять секунд с параметрами света и синхронизацией. Образец того, как выглядит проработанное ТЗ на говорящий ролик
Оговорка, которая экономит день. Первые два требуют видеокарты от 16 гигабайт памяти и около тридцати гигабайт на диске под модели. Если такого железа нет, смотрите третий и четвёртый — они работают через облачные вызовы.
Что почитать дальше
Почему ИИ-персонаж выглядит пластиковым — что чинить в кадре до оживления.
Клон голоса вместо диктора — вторая половина говорящего ролика.
Ролик из фото товара — восемь готовых форматов.
Генерация видео ИИ — полный разбор моделей и промптов.