Gemini 3.8 Flash Cyber: 86,2% на CyberGym — AI-дайджест
Google выпустила специализированную модель для кибербезопасности, Meta показала Muse Spark 1.3 с обещанием открытых весов, Alibaba вывела Wan 3.0 в топ видеолидербордов, а два свежих исследования усомнились в том, что библиотеки скиллов помогают агентам так, как принято считать.
Главное сегодня
Google: Gemini 3.8 Flash Cyber закрывает 86,2% CyberGym при цене Flash
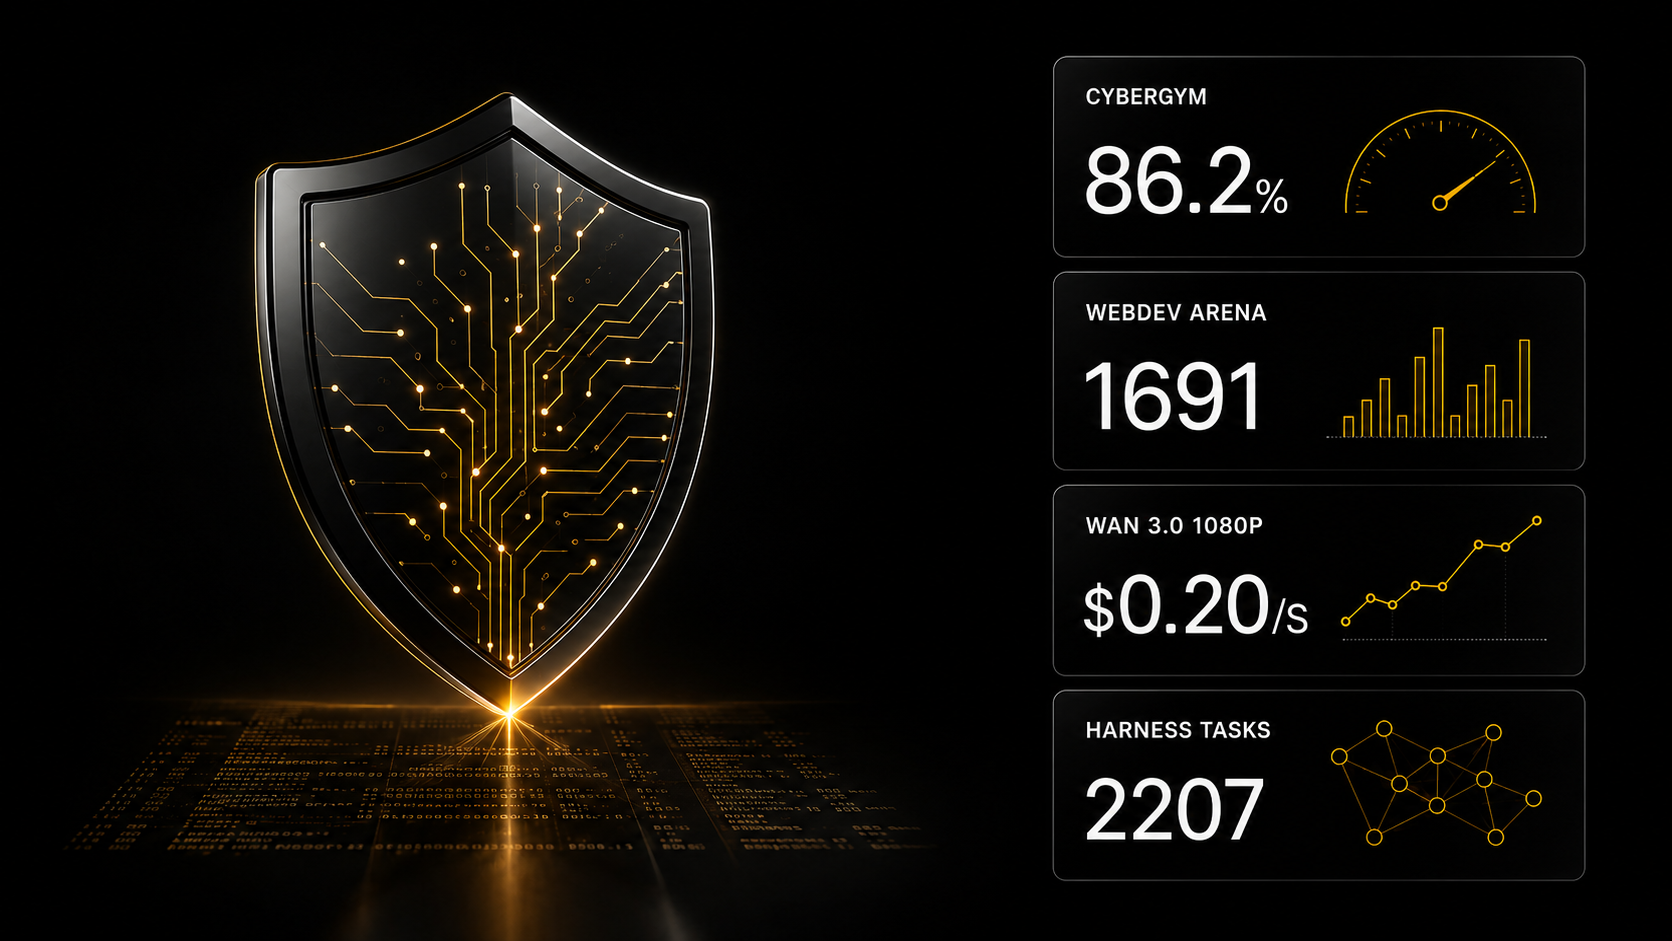
Google представила Gemini 3.8 Flash Cyber — модель, заточенную под кибербезопасность, с результатом 86,2% на бенчмарке CyberGym и 47,2% на CWE-Bench в задачах исправления уязвимостей. Об этом сообщил Сундар Пичаи: по внутреннему бенчмарку поиска уязвимостей модель показывает более 70% успеха на двадцати языках программирования, сохраняя скорость и цену линейки Flash. Это заметный сдвиг: раньше «безопасные» модели продавались как премиальные и медленные, здесь же специализация подаётся без наценки за неё. Практический смысл для команд простой — автоматический разбор кода на уязвимости перестаёт быть отдельной дорогой операцией и становится частью обычного конвейера проверки.
Meta: Muse Spark 1.3 метит в агентные и кодинг-задачи, открытые веса обещаны
Meta выпустила Muse Spark 1.3 — сильнейшую модель линейки Spark для агентных и кодинг-задач, с упором на длинную дистанцию работы и точное следование сложным инструкциям. Модель представил Шэнцзя Чжао; Александр Ван отдельно подчеркнул соотношение цены и возможностей. В обсуждении на r/LocalLLaMA участники заметили заявленный результат MRCR 98,1% на контексте 512K–1M и то, что открытые веса обещаны «скоро», — при подтверждении это был бы один из самых сильных результатов на миллионном контексте. Издание Superhuman AI 3 сентября 2026 года вынесло возвращение Meta в гонку фронтир-моделей в заголовок выпуска.
Alibaba: Wan 3.0 берёт первое место в видеомонтаже со звуком и стоит от $0,05 за секунду
Wan 3.0 занял первое место в категории «видеомонтаж со звуком», второе в «текст-в-видео со звуком» и пятое в «изображение-в-видео со звуком» на лидербордах Artificial Analysis. Замер опубликовала Artificial Analysis: модель заявлена как универсальная — принимает на вход текст, изображения, видео, аудио, документы и веб-страницы как референсы, поддерживает нативный звук и генерирует до 30 секунд в 1080p. Цена в публичном превью начинается с $0,05 за секунду для 480p и доходит до $0,20 за секунду для 1080p. Для тех, кто собирает ролики конвейером, важна именно связка «генерация плюс монтаж плюс звук в одной модели» — она убирает склейку из нескольких сервисов. Готовые сценарии съёмки и промпты под видео собраны в генераторе промптов AI SKILLS.
Qwen3.8-Max-0902 обошёл Opus 5 Max в веб-разработке на три пункта
В арене Code Arena WebDev модель Qwen3.8-Max-0902 вышла на первое место со счётом 1691, опередив Claude Opus 5 Max с 1688 и Kimi K3 Max с 1674. Скриншот лидерборда разобрали на r/LocalLLaMA; разрыв в три пункта находится в пределах статистической погрешности таких арен, поэтому корректнее говорить о паритете, а не о победе. Обсуждение показательнее самой таблицы: участники сообщают, что локальный Qwen3.8-27B в кодинге субъективно устраивает их больше платной подписки, а главный вопрос к лидеру — станут ли веса Max-версии открытыми. Подборка открытых моделей и инструментов для локального запуска — в разделе Open Source на AI SKILLS.
Цифры и факты
- 86,2% — Gemini 3.8 Flash Cyber на CyberGym, 47,2% — на CWE-Bench в исправлении уязвимостей, более 70% — на внутреннем бенчмарке поиска уязвимостей в двадцати языках.
- 1691 против 1688 и 1674 — Qwen3.8-Max-0902, Claude Opus 5 Max и Kimi K3 Max в Code Arena WebDev.
- 30 секунд в 1080p и $0,05–$0,20 за секунду — предел длины и цена Wan 3.0 в публичном превью.
- 2 207 удержанных задач, шесть моделей-создателей и четыре домена — объём проверки в работе HarnessDev.
- 17 моделей — охват исследования об эффекте извлечения скиллов.
- 10 266 скиллов для Claude Code — столько активных карточек в каталоге AI SKILLS на 4 сентября 2026 года; это тот самый масштаб библиотек, о котором спорят авторы обеих работ.
Разные точки зрения: помогают ли агенту библиотеки скиллов и самодельные харнесы?
Две свежие работы дают противоположные по настроению ответы, и обе меряют то, что раньше принимали на веру. Харнес — это обвязка вокруг модели: инструменты, память, порядок вызовов и правила остановки, всё то, что превращает модель в работающего агента.
За. Команда ByteDance Seed показала HarnessDev: модель стартует со слабой, но запускаемой заготовки и сама достраивает харнес, а на втором этапе улучшает его по обратной связи. Работу пересказал Элвис Саравия: на четырёх доменах и 2 207 удержанных задачах сгенерированные харнесы догоняют или обходят инженерные решения людей в письме и ML-экспериментах.
Нейтрально. Там же зафиксировано, что в коде, поиске и исследовательских задачах самодельные харнесы всё ещё отстают от зрелых человеческих систем, а прирост нестабилен и плохо переносится между моделями.
Против. Работа об эффекте фактического использования извлечения, пересказанная dair.ai, предлагает честную методику: гонять одну и ту же задачу дважды, со скиллами и без, и считать только те случаи, где извлечение реально сработало. На 17 моделях в коде и математике нашлись случаи, где библиотека улучшает средний балл, но ухудшает результат именно на тех задачах, где её вызвали. Для тех, кто ведёт библиотеки скиллов, это прямое предупреждение против веры в общий прирост.
Инструменты и приёмы
- Spark-X2.5 в размерах 4B и 1.7B — релиз обсуждают на r/LocalLLaMA: заявлены нативный контекст в 1M токенов и обучение примерно на 20T токенов, а поддержка в llama.cpp пока ждёт пул-реквеста №27868. Если цифры подтвердятся, это самый маленький из известных вариантов с миллионным контекстом.
- Photon 2.1 — Викхьят Корраправати сообщил о добавлении моделей синтеза речи и поддержки NVIDIA B200 в движок мультимодального инференса реального времени.
- GLM-5.3 Fast на Baseten — хостинг объявил о доступности с упором на более высокую пропускную способность в токенах в секунду для задач реального времени.
Коротко
- Стэнфорд перезапускает курс The Modern Software Developer: Михаил Эрик пишет, что 85% материала осени 2025 года заменяется темами агентных скиллов, контекст-инжиниринга, MCP-порталов и агентного код-ревью.
- Там же открывается CS329Z «Engineering AI Agents» — курс о сборке агентов с нуля, анонсированный Дии Ян и Майклом Райаном.
- Открытая модель Marin 535B-A23B прошла 13% обучения, сообщил Перси Лян; вычисления оплачены фондом Дженсена и Лори Хуанг и идут на CoreWeave.
- Себастьян Рашка разобрал слухи про архитектуру Astra и напомнил про Nanbeige 4.2-3B: стек из 22 слоёв, переиспользованный дважды, ведёт себя как 44-слойная модель при той же памяти и примерно вдвое большем счёте.
- Сервис imagine поднял лимит до 14 референсов на одно видео — изображения, голоса и персонажи подключаются тегом в промпте.
- Платформа Palmimo DevKit представлена как настольный робот с открытым софтом и сменными «мозгами», управляемый несколькими строками на Python.
- Подкаст The AI Daily Brief 3 сентября 2026 года разобрал агентные циклы для работников умственного труда: как задавать проверяемую точку финиша и не давать циклу разогнать расходы.