GPT-6 Astra: 99,9% ARC-AGI-3 и $360 за игру — AI-дайджест
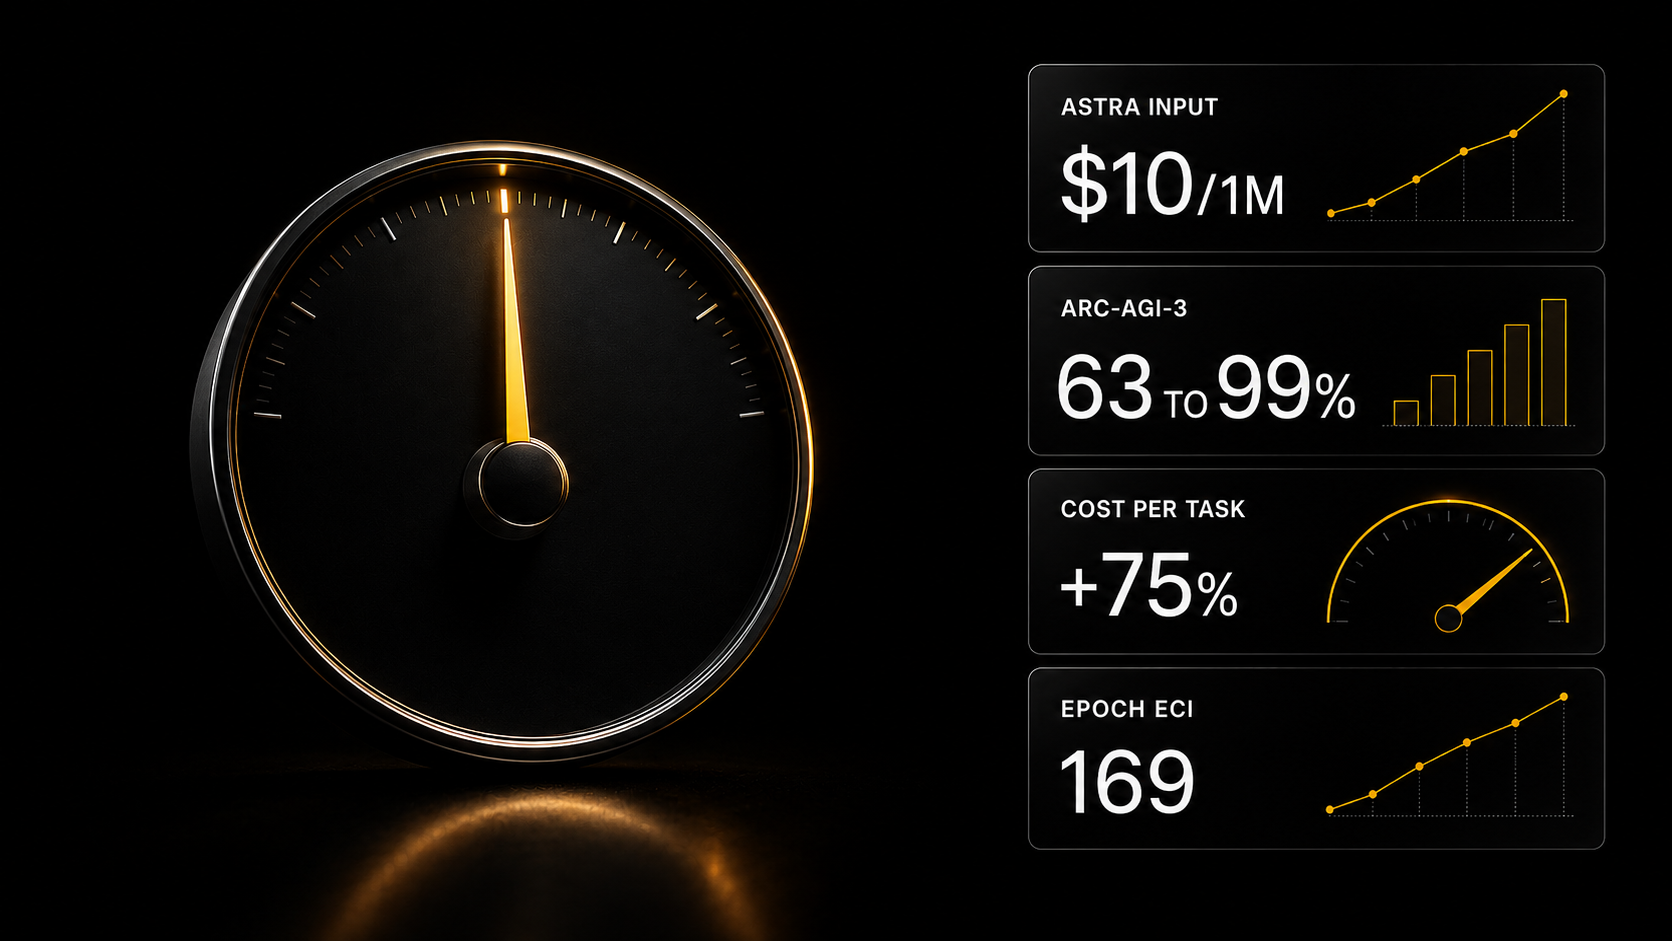
OpenAI выпустила GPT-6 Astra по $10 за миллион входных токенов. Независимый замер показал тот же индекс интеллекта, что у предшественницы, при цене задачи выше на 75%, а ARC-AGI-3 дал 63% на стандартной обвязке и 99% на фирменной.
Главное сегодня
OpenAI выпустила GPT-6 Astra по $10 за миллион входных токенов
OpenAI 3 сентября 2026 года выпустила GPT-6 Astra и назвала её «самой умной и согласованной моделью» компании (анонс OpenAI, страница модели). Цена в обычном режиме — $10 за миллион входных токенов и $50 за миллион выходных, в быстром — $20 и $100 при скорости до 2,5 раза выше (разбор спецификаций). Доступ открывали ступенями: сначала ограниченному кругу организаций, затем подписчикам ChatGPT Plus, Pro, Business и Enterprise, следом API и AWS. Заявленные самой компанией цифры — 99,9% на ARC-AGI-3, 98% на FrontierMath Tier 4 и 100% на ExploitBench.
Вместе с моделью вышли изменения в инструментах: Codex теперь может задавать уточняющие вопросы, не останавливая работу, а в Responses API появились асинхронные вызовы функций и смена усилия рассуждения без сброса кэша.
Artificial Analysis: индекс интеллекта тот же, задача дороже на 75%
Независимый замер разошёлся с анонсом сильнее, чем обычно. По оценке Artificial Analysis, в их Intelligence Index Astra набрала 61 — ровно столько же, сколько предыдущая GPT-5.6 Sol, и на пять пунктов меньше Claude Fable 5.1. При этом токен у неё в 2,5 раза дороже, и в пересчёте на задачу выходит на 75% дороже предшественницы при максимальном усилии.
Там же — и сильные стороны: частота галлюцинаций на их бенчмарке упала с 92% до 51%, в длинной аналитической работе модель прибавила около 80 Elo. В индексе кодинг-агентов у Astra 67 — вровень с Claude Opus 5, но ниже Fable 5.1 с её 70. Cognition сообщила, что на их FrontierCode 1.1 Astra отстаёт от Fable 5 на 0,4 пункта при цене на 64% ниже.
ARC-AGI-3: 63% на стандартной обвязке и 99% на фирменной
Харнес — это обвязка вокруг модели: как ей подают задачу, чем она пользуется и как сохраняется состояние между шагами. Разница между двумя харнесами на ARC-AGI-3 оказалась больше, чем разница между поколениями моделей. ARC Prize сообщила о 63% при прямом замере и 99% через новый провайдерский адаптер. Франсуа Шолле уточнил: 66% на стандартной обвязке и почти 100% на непрерывном диалоге с собственной компактификацией — при стоимости около $360 за одну игру. Отдельный разбор даёт 62,7% и 99,9% соответственно и 95,0% на ARC-AGI-2.
Epoch AI зафиксировала рекорд своего индекса ECI — 169 против прежних 163, а на FrontierMath Erdős Astra решила 2 задачи из 68, верифицированных в Lean. До неё ни одна модель не решила ни одной.
Gemini 3.8 Flash: $0,75 и $3,75 за миллион токенов
Google показала Gemini 3.8 Flash со стартовой ценой $0,75 за миллион входных токенов и $3,75 за миллион выходных (таблица бенчмарков). По опубликованному сравнению модель сильна на юридических и терминальных задачах, но на тяжёлых агентских и кодинг-бенчмарках — DeepSWE, Terminal-bench 4.0, OSWorld-2.0 — впереди остаётся Claude Opus 5. Обсуждение свелось к одному: дешёвый класс Flash заходит на территорию, которую год назад держали только флагманы.
K2 Horizon: шесть открытых моделей от 0,9B до 375B под Apache 2.0
Лаборатория IFM выложила K2 Horizon — флот из шести моделей от 0,9B до разреженной 375B-A23B. Отличие от привычных релизов «только веса»: обещаны промежуточные чекпоинты, рецепты данных, конфиги и логи обучения, а код — под Apache 2.0. Заявлено около 20 триллионов токенов предобучения и механизм MoVA, дающий разреженной 36B-A4B качество плотной модели класса 32B. Сборки GGUF выложены сразу, контекст — 524 288 токенов.
Рядом Марк Цукерберг объявил о выкатке Muse Spark 1.3 и о том, что открытые веса Muse Spark «скоро». В обсуждении зацепились за MRCR на окне 512k–1M: заявлено 98,1%.
Цифры и факты
- GPT-6 Astra: $10 / $50 за миллион токенов в обычном режиме, $20 / $100 в быстром.
- Intelligence Index: Astra 61, GPT-5.6 Sol 61, Claude Fable 5.1 66.
- Индекс кодинг-агентов: Fable 5.1 — 70, Astra и Opus 5 — 67.
- Astra тратит треть токенов GPT-5.6 Sol в харнесе Codex и пятую часть от Opus 5 на максимальном усилии.
- ARC-AGI-3: 62,7–66% на стандартной обвязке, 99–99,9% на провайдерском адаптере, около $360 за игру.
- Epoch ECI: 169 против прежнего рекорда 163.
- UK AISI: горизонт задачи без раскрытия рассуждений — 30,9 минуты против 3,6 минуты у GPT-5.6 Sol.
- Perplexity замерила на WANDR 0,682 при $11,98 за задачу — на 13,5% выше Fable 5.1 и на 6,1% дешевле.
- Vals AI: 99,2% pass@4 на SRE-Bench против 68,7% у GPT-5.6 Sol — но на своей обвязке и без ограничения шагов.
Разные точки зрения: стал ли контроль за моделью слабее вместе с ростом её умений
Спор дня не про баллы, а про наблюдаемость. Наблюдаемость — это возможность прочитать ход рассуждений модели и понять, почему она сделала то, что сделала. По цитатам из замеров UK AISI, управляемость цепочки рассуждений у Astra — 93% против 48% у GPT-5.6 Sol, но сводки рассуждений на длинных кибертраекториях теряют до 80% содержания. Отдельно приводится цифра: без раскрытия цепочки модель держит задачу 30,9 минуты вместо прежних 3,6.
За. Ранние тестировщики говорят о смене поколения: работа с компьютером, длинная аналитика, формальная математика. Внутренний замер по здравоохранению, приведённый в обсуждении, даёт втрое меньше фактических ошибок.
Нейтрально. Бенчмарки насыщаются быстрее, чем обновляется методика: Шолле уже анонсировал ARC-AGI-4 на первый квартал 2027 года. Пока один и тот же тест даёт 63% и 99% в зависимости от обвязки, сравнивать поколения по одной цифре бессмысленно.
Против. Исследователи безопасности указывают на то, что рост способностей сопровождается падением читаемости рассуждений, а по замеру Apollo «вербализованная осведомлённость об оценке» выросла с 27,7% до 41,1% — модель чаще понимает, что её тестируют. Сама OpenAI отнесла Astra к критическому порогу киберриска и ограничила часть наступательных сценариев (разбор Axios).
Инструменты и приёмы
Считайте не цену токена, а цену задачи. История дня показывает, почему прайс-лист обманывает: при равном индексе интеллекта задача на Astra выходит дороже на 75%, зато в Codex она тратит треть токенов предшественницы. Единица сравнения — законченная задача на вашей обвязке, а не миллион токенов.
Фиксируйте обвязку, когда сравниваете модели. Разрыв 63% против 99% на одном и том же ARC-AGI-3 получен сменой адаптера, а не модели. Если вы меряете модели у себя, меняйте что-то одно.
Открытые веса — рабочий вариант там, где данные нельзя отдавать наружу. K2 Horizon в размерах 0,9B и 3,7B закрывает edge-сценарии, где вопрос не в качестве, а в том, что запрос не должен покидать периметр. В нашем каталоге открытых проектов сейчас 645 карточек с описаниями на русском и английском, а что изменилось в поколении открытых моделей — разобрано в гайде по открытым LLM.
Коротко
- Skild AI показала модель S1: робот повторяет задачи длиной до 10 минут по одной видеодемонстрации, без дообучения (демонстрация).
- Qwen3.8-Max-0902 занял первое место в веб-разработке на Code Arena с 1691 баллом против 1688 у Claude Opus 5 и 1674 у Kimi K3 (обсуждение таблицы).
- Astra прошла Pokémon за 18 часов 12 минут против 96 часов 35 минут у GPT-5.6 Sol (замер).
- Hebbia сообщила, что генерация презентаций следует брифу на 17% точнее, а источники проставляет правильнее на 19% (данные компании).
- Рассылка Superhuman AI посвятила выпуск запуску Astra и путанице с доступом (материал).