Прогресс LLM: данные дали 12x, модели 3,7x — AI-дайджест
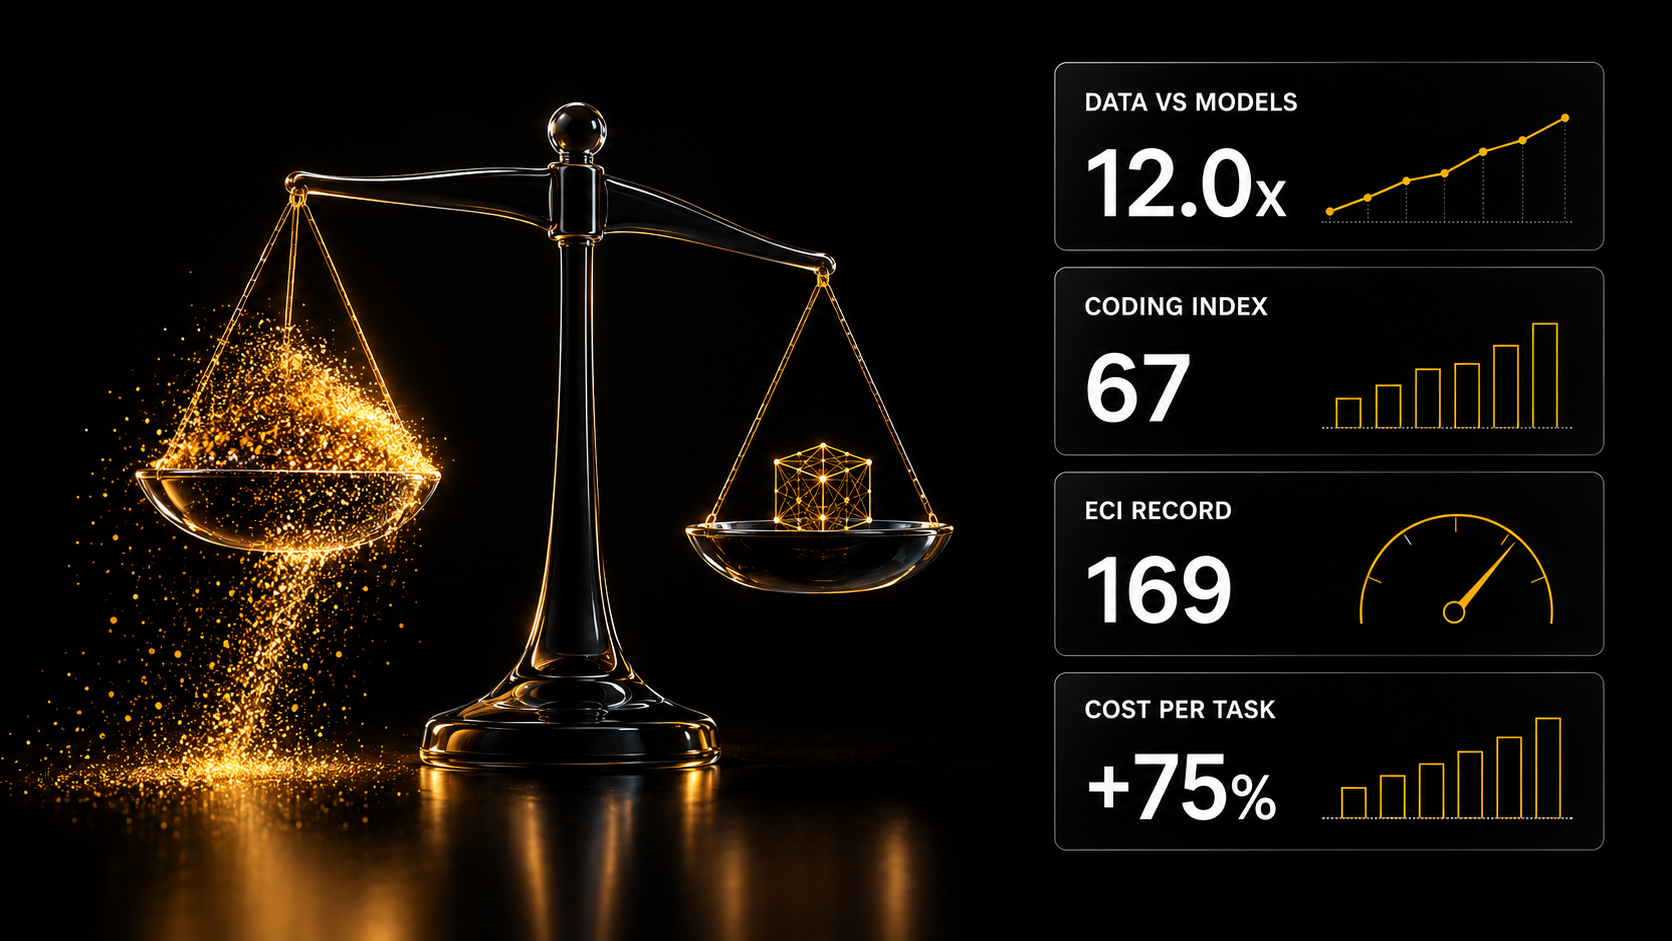
Замер 2019–2025: данные дали 12,0x прироста вычислительной эффективности против 3,7x у архитектур. GPT-6 Astra через неделю — 67 в Coding Agent Index против 70 у Fable 5.1 и на 75% дороже за задачу.
Главное сегодня
Данные дали в 3,24 раза больше прироста, чем архитектуры моделей
Исследование, опубликованное 8 сентября 2026 года, измерило вклад данных и архитектур в прогресс языковых моделей за 2019–2025 годы: улучшение данных дало в 3,24 раза больше прироста вычислительной эффективности, чем улучшение самих моделей. В абсолютных числах — 12,0x от данных против 3,7x от архитектур при бюджете обучения 1e19 FLOPs. Претрейн — это первый этап обучения модели на большом корпусе текста, до дообучения под конкретные задачи. Авторы брали по одному «рецепту» модели и по одному публичному корпусу на каждый год и обучали все сочетания, оценивая результат на OLMES — наборе из десяти относительно простых бенчмарков. Вклады оказались почти независимыми: 88% разброса оценки объясняется простым сложением эффектов данных и модели. Для контекста: в 2019 году корпус OpenWebText содержал около 9 миллиардов токенов, а к 2025 году открытые корпуса вроде UltraFineWeb выросли на порядки и стали отбирать данные обученным классификатором. Полный разбор с графиками.
GPT-6 Astra через неделю: «выставочная лошадь, а не рабочая»
Спустя неделю после запуска практический вердикт по GPT-6 Astra разошёлся с бенчмарками: модель берёт рекорды, но пользователи описывают её как неровную. Автор Ben's Bites за выходные сжёг 4 миллиарда токенов и, по собственному признанию, не построил ничего законченного. Формулировка Кирана Клаассена — «это выставочная лошадь, а не рабочая»; разработчик Тео пишет: «я одновременно люблю и категорически не выношу эту модель». При этом Astra выигрывает ARC-AGI-3, показывает лучший результат на AutomationBench от Zapier и стоит столько же, сколько Claude Fable 5.1. Отдельно отмечают компьютерное управление: Astra рисует портрет в Canva так, как это делал бы человек мышью, и достаточно быстра, чтобы играть на пианино. В Codex модель научилась задавать вопросы, не останавливая работу: она продолжает всё, что не зависит от ответа, и подхватывает ответ, не теряя исходной задачи. Разбор недели использования.
Astra экономит токены, но выходит дороже за задачу
Независимый замер Artificial Analysis показал, что Astra тратит на 70% меньше токенов, чем GPT-5.6 Sol, но из-за цены обходится на 75% дороже за задачу на максимальном усилии. В Coding Agent Index у Astra 67 баллов — вровень с Claude Opus 5 и Fable 5, тогда как Fable 5.1 лидирует с 70. В Codex-обвязке Astra расходует треть токенов GPT-5.6 Sol и пятую часть токенов Claude Opus 5 на максимальном усилии, а тот же результат обходится дешевле половины цены Claude Fable 5. В Intelligence Index у Astra 61 балл — столько же, сколько у GPT-5.6 Sol, и на 5 баллов ниже Claude Fable 5.1. Доля галлюцинаций на их бенчмарке падает с 92% до 51% при максимальном усилии, точность растёт на 4 пункта. Есть и регрессии: около 80 пунктов Elo вниз на GDPval-AA v2 и 2–3 пункта на τ³-Banking, SciCode и AA-LCR. Полный разбор замера.
OpenAI объявила о достижении цели «автоматический научный стажёр»
OpenAI заявила, что достигла собственной цели «автоматический научный стажёр»: её агенты берут исследовательские задачи, на которые у квалифицированного человека уходит несколько дней. Направление задаёт и результат оценивает по-прежнему человек. Следующая заявленная цель компании — полностью автоматический ИИ-исследователь к марту 2028 года. Параллельно OpenAI рассказывает о внутреннем преимуществе от собственных исследовательских агентов — материал The Rundown от 8 сентября 2026 года. Заявление важно тем, что переводит спор о пользе агентов из демонстраций в измеримую плоскость: компания называет конкретный класс задач и конкретный горизонт. Проверить утверждение снаружи пока нельзя — независимых замеров «исследовательской» работы агентов на многодневных задачах в открытом доступе нет. Первоисточник заявления.
Anthropic тестирует плагины, меняющие поведение Claude Code
Anthropic тестирует механизм, позволяющий Claude Code писать плагины, которые меняют интерфейс, ведут журнал действий и ограничивают то, что агенту разрешено делать. Функция пока не выпущена, команда собирает отзывы. Третий пункт здесь важнее первых двух: ограничение прав агента внутри самого инструмента — это ответ на запрос компаний, которым нужен предсказуемый агент, а не максимально свободный. Для тех, кто уже собирает свои расширения под Claude Code, это меняет опору: сегодня поведение настраивается файлами скиллов, завтра — ещё и кодом плагина. Устройство скиллов и их формат разобраны в нашем руководстве по Skills для Claude Code. Первоисточник.
Цифры и факты
- 12,0x против 3,7x — прирост вычислительной эффективности от данных и от архитектур соответственно, 2019–2025, при бюджете 1e19 FLOPs (исследование).
- 88% разброса оценки OLMES объясняется простым сложением эффектов данных и модели — они почти не взаимодействуют (там же).
- 67 против 70 — Coding Agent Index у Astra и у Claude Fable 5.1 (Artificial Analysis).
- 169 — новый рекорд ECI у Astra против прежних 163, с новыми рекордами в математике, непрерывном обучении и игровых головоломках (Epoch AI).
- $10 и $50 за миллион токенов входа и выхода в стандартном режиме Astra; быстрый режим — $20 и $100 за скорость до 2,5x (анонс OpenAI).
- 8,2 миллиарда токенов, 235 сообщений и 656 субагентов — стоимость сборки одного дата-проекта на 107 миллионов строк (разбор автора).
- 10 416 скиллов для Claude Code в каталоге AI SKILLS на 9 сентября 2026 года, из них 153 — про диаграммы и визуализацию архитектуры; агенты упоминаются в описаниях 2 739 скиллов.
Разные точки зрения: что двигало прогресс ИИ — данные или архитектуры
Замер даёт перевес данным: 12,0x прироста против 3,7x у архитектур за 2019–2025 годы. Но авторы того же исследования предупреждают, что это неверный способ оценивать вклад архитектур.
За «данные решают». Цифры прямые: на бюджете 1e19 FLOPs данные дали в 3,24 раза больше прироста, чем модели, а эффекты почти не пересекаются. Наивное чтение результата — эпоха предобучения 2019–2024 годов была в основном хорошей инженерией данных: извлечение, очистка, отбор (исследование).
Нейтрально. Замер сделан на малом масштабе — до 1e19 FLOPs — и только для предобучения. Современный прирост в значительной части идёт от обучения с подкреплением и постобучения, которых этот эксперимент не касается вовсе.
Против. Авторы исследования сами возражают своей наивной трактовке: главный вклад архитектурной работы был не в вычислительной эффективности, а в том, что она вообще сделала большие объёмы вычислений пригодными к использованию — по мере роста числа параметров, длины контекста, длительности прогонов и размеров кластеров.
Инструменты и приёмы
Плагины вместо конфигов: подключение агента через обычный вход в браузере. Обзор Grok Bot описывает установку плагина как вход на сайт: находишь плагин в каталоге, открывается браузер, логинишься — и агент подключён, без правки JSON MCP-сервера и без вставки ключей API. Автор так подключил Freshdesk и собрал бота, который каждые пятнадцать минут проверяет новые тикеты поддержки. Вышедший на этой неделе OpenClaw 2.0 сокращает разрыв: его быстрый старт переиспользует уже существующий вход в Claude Code или Codex, а браузерное приложение переносит настройку и управление плагинами в графический интерфейс. Разница остаётся принципиальной: OpenClaw даёт собственный шлюз, который вы запускаете сами, а Grok Bot поставляет и обслуживает машину как часть продукта (разбор пяти дней использования).
Субагенты для сбора данных с проверкой целостности. Автор Ben's Bites собрал 107 миллионов строк открытых данных о расходах британских советов, поручив агенту найти источники: тот развернул три субагента в отдельных потоках, собрал каталог из 31 официального источника и логировал каждую загрузку контрольной суммой — чтобы потом отличить свои данные от изменившихся на стороне источника. Итог — 8 советов, 1,8 миллиона строк и 9 миллиардов фунтов расходов в одном чистом CSV (описание сборки). Похожие связки для рутинного сбора и обработки данных есть в каталоге шаблонов автоматизаций.
Коротко
- Skild S1 учится новому движению робота по одному видео (The Rundown, 6 сентября 2026 года).
- MIT и Motional показали CW-Net — модель рассуждений для автономных автомобилей (The Rundown, 6 сентября 2026 года).
- Insilico опубликовала данные по рентосертибу и «часам старения» в ИИ-разработке лекарств (The Rundown, 8 сентября 2026 года).
- Якуб Пахоцкий, главный научный сотрудник OpenAI, высказался о замедлении и стандартах безопасности (The Rundown, 7 сентября 2026 года).
- OpenAI раскрыла инцидент безопасности с роем агентов в немецкой Википедии (The Rundown, 7 сентября 2026 года).
- Tesla вывела роботакси Cybercab на улицы Остина (Superhuman, 5 сентября 2026 года).
- METR и Redwood Research выпустили независимый разбор поведения агентов во взломе OpenAI и Hugging Face — с расшифровками цепочек рассуждений (Hard Fork, 4 сентября 2026 года).
- Отдельный выпуск подкаста объясняет, почему Astra так трудно оценивать: спектакулярные демонстрации при смешанной реакции обычных пользователей (The AI Daily Brief, 8 сентября 2026 года).