DeepSeek V4.1-Flash: 40 баллов за $0,30 — AI-дайджест
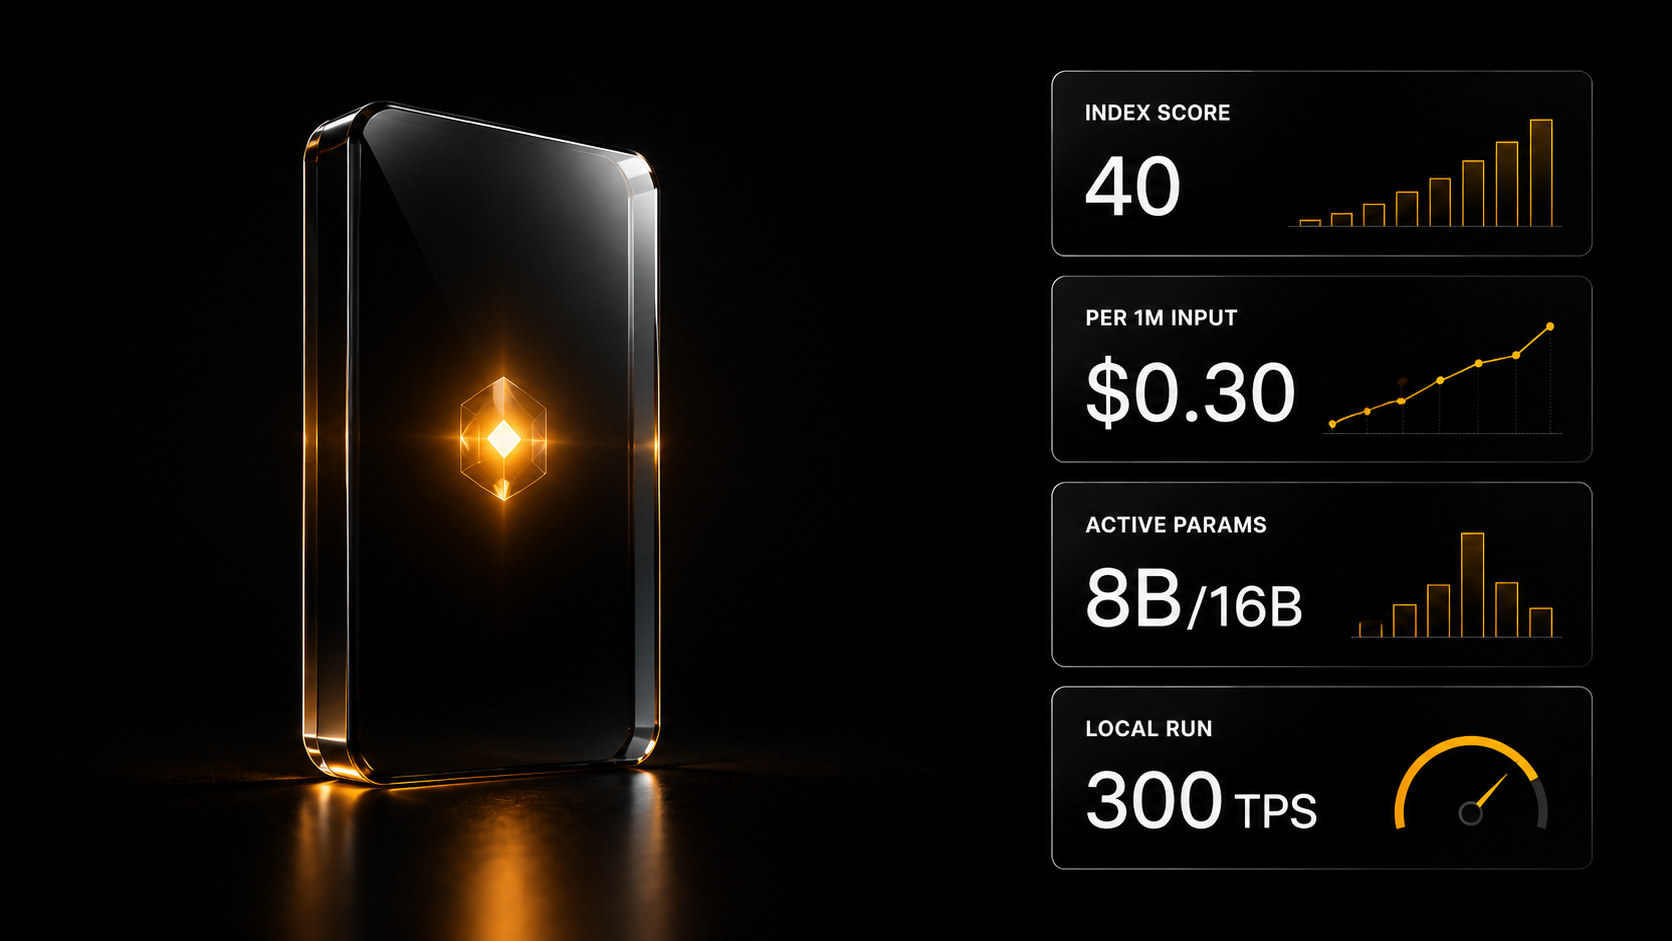
DeepSeek выложила под MIT модель V4.1-Flash: 40 баллов индекса при $0,30 за миллион входных токенов и 763 млрд параметров, из которых активны 8 на ввод и 16 на вывод. Её запустили с SSD на 300 токенах в секунду. OpenAI открыла голосовую модель с полным дуплексом.
Главное сегодня
DeepSeek V4.1-Flash: 40 баллов в индексе интеллекта при $0,30 за миллион токенов
DeepSeek выложила под лицензией MIT модель V4.1-Flash: 40 баллов в Artificial Analysis Intelligence Index при цене $0,30 за миллион входных токенов и $1,20 за миллион выходных — выше прежней старшей V4 Pro и заметно дешевле её. Кэшированный вход стоит $0,006 за миллион, вне часа пик действует дополнительная скидка 50%. Модель заявлена как 763 миллиарда параметров всего, но активными на обработку запроса идут лишь 8 миллиардов, а на генерацию ответа — 16; контекст — миллион токенов, на вход принимаются текст и изображения. Vals поставила её на первое место среди открытых моделей своего рейтинга, впереди Kimi K3, при стоимости прогона теста $0,30 — дешевле всех в первой десятке. Себастьян Рашка назвал релиз «капитальной переработкой» и сказал, что модель «стоило назвать DeepSeek V5». Разбор Artificial Analysis, рейтинг Vals, оценка Рашки.
Архитектура ради инференса: раздельная экономика ввода и вывода
Главная новинка V4.1-Flash — причинный энкодер-декодер: модель тратит 8 миллиардов активных параметров на чтение запроса и 16 миллиардов на генерацию, то есть разводит стоимость ввода и вывода по разным бюджетам. Разбиравшие отчёт сходятся в том, что всё подчинено сжатию KV-кэша. KV-кэш — это память модели о уже прочитанном тексте: она растёт с длиной контекста и на длинных документах стоит дороже самих вычислений. По оценке одного из разборов, на токен приходится около 890 байт кэша в том режиме, в котором снимались баллы. Инженеры отмечают связку локального окна внимания с разреженной выборкой и предполагают обучение с учётом квантования кэша — этим объясняют, почему модель держит качество при четырёхбитном KV-кэше. Технический разбор, архитектурный разбор, о квантовании кэша.
Фронтир-модель запустили с SSD: 300 токенов в секунду при 32 ГБ оперативной памяти
Фрейзер Прайс сообщил, что запустил DeepSeek V4.1-Flash в полной точности со скоростью 300 с лишним токенов в секунду на четырёх картах RTX Pro, удерживая пик потребления системной памяти ниже 32 ГБ — за счёт выгрузки 200-гигабайтной структуры на NVMe-накопитель. Первый его замер был скромнее: 200 токенов в секунду на четырёх Max-Q и 64 ГБ памяти. Сальваторе Санфилиппо независимо запустил ту же модель на ноутбуке с 128 ГБ памяти и отметил, что потоковая подгрузка с SSD оказалась неожиданно быстрой. Практический вывод: у открытой модели верхнего уровня требование к дорогой видеопамяти перестало быть отсекающим — узким местом становится накопитель, а он дешевле. Подборка инструментов для локального запуска — в разделе Open Source AI SKILLS. Замер на RTX Pro, первый замер, запуск на ноутбуке.
Anthropic опубликовала самый подробный отчёт о попытках злоупотребления Claude
Anthropic выпустила отчёт о выявленных попытках использовать Claude для кибератак, информационных операций, слежки, биологии и оружия, и заявила, что пресекла каждую описанную операцию. Это самый детальный документ такого рода у компании. Бывший руководитель направления по пресечению угроз в Meta Дэвид Агранович счёл, что за такой уровень открытости компании стоит отдать должное, даже если отдельные формулировки заслуживают спора. Публикация вышла на фоне отдельной дискуссии о наблюдаемости рассуждений: Redwood Research предложила нормы раскрытия для архитектур, которые ослабляют видимую цепочку рассуждений, а Райан Гринблатт призвал публиковать доказательства и политики до выката таких архитектур. Отчёт Anthropic, оценка Аграновича, нормы раскрытия.
OpenAI открыла голосовую модель с полным дуплексом и хостинг для агентов
OpenAI выпустила в API модель GPT-Live-1 — голосовой интерфейс с полным дуплексом, то есть способный слушать во время собственной речи, а рассуждения и вызов инструментов передавать модели в бэкенде. По замерам компании, в связке с GPT-6 Astra модель выполняет задачу с первой попытки в 83,6% случаев на Tau3, набирает 97,3% на тесте разговорной динамики Artificial Analysis и отвечает с задержкой начала реплики 0,798 секунды. Тем же днём вышел публичный бета-доступ к Agents API с обвязкой Codex и песочницами на стороне OpenAI — код, файлы и артефакты исполняются у провайдера. Интеграции появились сразу у LiveKit, HeyGen и в голосовом режиме Devin у Cognition. Запуск GPT-Live-1, замеры, Agents API и песочницы.
Цифры и факты
- 40 баллов при $0,30 / $1,20 за миллион токенов — DeepSeek V4.1-Flash в Artificial Analysis Intelligence Index и её цена входа и выхода (разбор).
- 763 млрд параметров всего, 8 млрд активных на ввод и 16 млрд на вывод, контекст 1 млн токенов, лицензия MIT (разбор).
- 69% на AutomationBench-AA — вровень с GPT-6 Astra и выше Grok 4.6 с 67%; на GDPval-AA v2 прирост 164 балла Elo, с 1468 до 1632, выше Kimi K3 с 1584 (разбор).
- 89 тысяч токенов на задачу против 71 тысячи у GLM-5.3 — V4.1-Flash среди самых многословных измеренных моделей, но задача всё равно обходится в $0,27 против $2,01 у GLM-5.3 (разбор).
- 300+ токенов в секунду при пике системной памяти ниже 32 ГБ — запуск в полной точности на четырёх RTX Pro с выгрузкой на SSD (замер).
- 83,6% с первой попытки и 0,798 секунды до начала ответа — GPT-Live-1 на Tau3 в связке с GPT-6 Astra и на тесте полного дуплекса (замеры).
- До 70% дешевле при сопоставимом качестве — заявленная экономика модели SWE-2 у Cognition; обучение с подкреплением масштабировали до триллионов параметров (анонс).
- 614 из 10 441 скилла каталога AI SKILLS для Claude Code на 12 сентября 2026 года описывают локальный запуск моделей; про безопасность и уязвимости — 956.
- До 25% экономии токенов траектории — контроллер Elastic Horizon подстраивает горизонт агента по 90-му перцентилю длины удачных траекторий (разбор).
Разные точки зрения: дешёвая открытая модель — прорыв или внутренний артефакт?
Цифры не оспариваются: 40 баллов индекса, первое место среди открытых моделей у Vals, $0,27 за задачу против $2,01 у ближайшего конкурента. Спор идёт о том, переносятся ли эти результаты в реальную работу.
За. Vals называет V4.1-Flash новой первой открытой моделью своего рейтинга, Artificial Analysis выносит в заголовок стоимость с поправкой на качество, Себастьян Рашка — «капитальная переработка», которую «стоило назвать V5» (Vals, Рашка).
Нейтрально. Часть разбиравших не оценивает, а препарирует: гибрид локального внимания и разреженной выборки, странности первых слоёв, токенизация изображений. Александр Гордич отмечает, что по публикациям DeepSeek выглядит лабораторией «органических данных» и, судя по всему, не использует даже синтетический перефраз (Гордич).
Против. Аккаунт Teortaxes возражает по существу: у DeepSeek высокие внутренние замеры сочетаются со слабой устойчивостью снаружи и провалами в отдельных навыках, потому что компания «выпускает внутренние исследовательские артефакты, а не продукты». Он же называет часть результатов «очень странными» — в частности первое место на AutomationBench при регрессе на CritPt (о продуктах, о странных результатах).
Инструменты и приёмы
- Горизонт агента подстраивается автоматически. Контроллер Elastic Horizon следит за 90-м перцентилем длины успешных траекторий и по нему двигает предел числа шагов: успеваемость растёт, расход токенов падает до 25% (разбор).
- Длинный контекст читают параллельно, а не по кускам. PARSER заменяет последовательное чтение фрагментов набором замороженных субагентов с ведущим агентом, обученным на подкреплении: заявлено +12 баллов на контексте 896 тысяч токенов и до 11 раз меньшая задержка (разбор).
- Словарь для постановки задач дизайнеру-агенту. Автор Ben's Bites собрал Design Words — набор готовых формулировок стилей, раскладок и компонентов, которые можно выбрать и вставить в запрос агенту, если своего дизайнерского языка нет (инструмент и описание). Готовые сценарии для агентов — в каталоге шаблонов автоматизаций AI SKILLS.
Коротко
- OpenAI приостановила регистрацию новых подписок Pro за $200 из-за нехватки мощностей под Astra; действующих пользователей это не затронуло, API и другие планы работают (сообщение).
- Cursor выпустил Projects — постоянные ветки работы с агентом-координатором, общей памятью и синхронизацией между устройствами (анонс).
- В ChatGPT Work появился агент по данным: дашборды, ответы и действия поверх подключённых корпоративных источников (анонс).
- Обучение слабой модели на полных траекториях сильной ухудшает результат на 4–30 баллов после смены обвязки — переписывать нужно только неудачный шаг в её собственном прогоне (разбор работы Salesforce).
- В ByteDance агенты сами строят и улучшают свою обвязку, но переносимость средняя: только 34 изменения из 64 сработали в нужную сторону на отложенных задачах (разбор HarnessDev).
- ToolGrad от Google Research генерирует цепочки вызовов инструментов до формулировки запроса и заявляет почти 100% годных примеров при сборке датасета (анонс).
- Hugging Face объявила о создании команды Open Alignment (Том Вольф).
- Команда Dioxus Labs переходит в Cognition — работать над виртуальной машиной Devin, управлением компьютером и тестированием (анонс).