DeepSeek V4.1-Flash: 552, 748 или 763 млрд — AI-дайджест
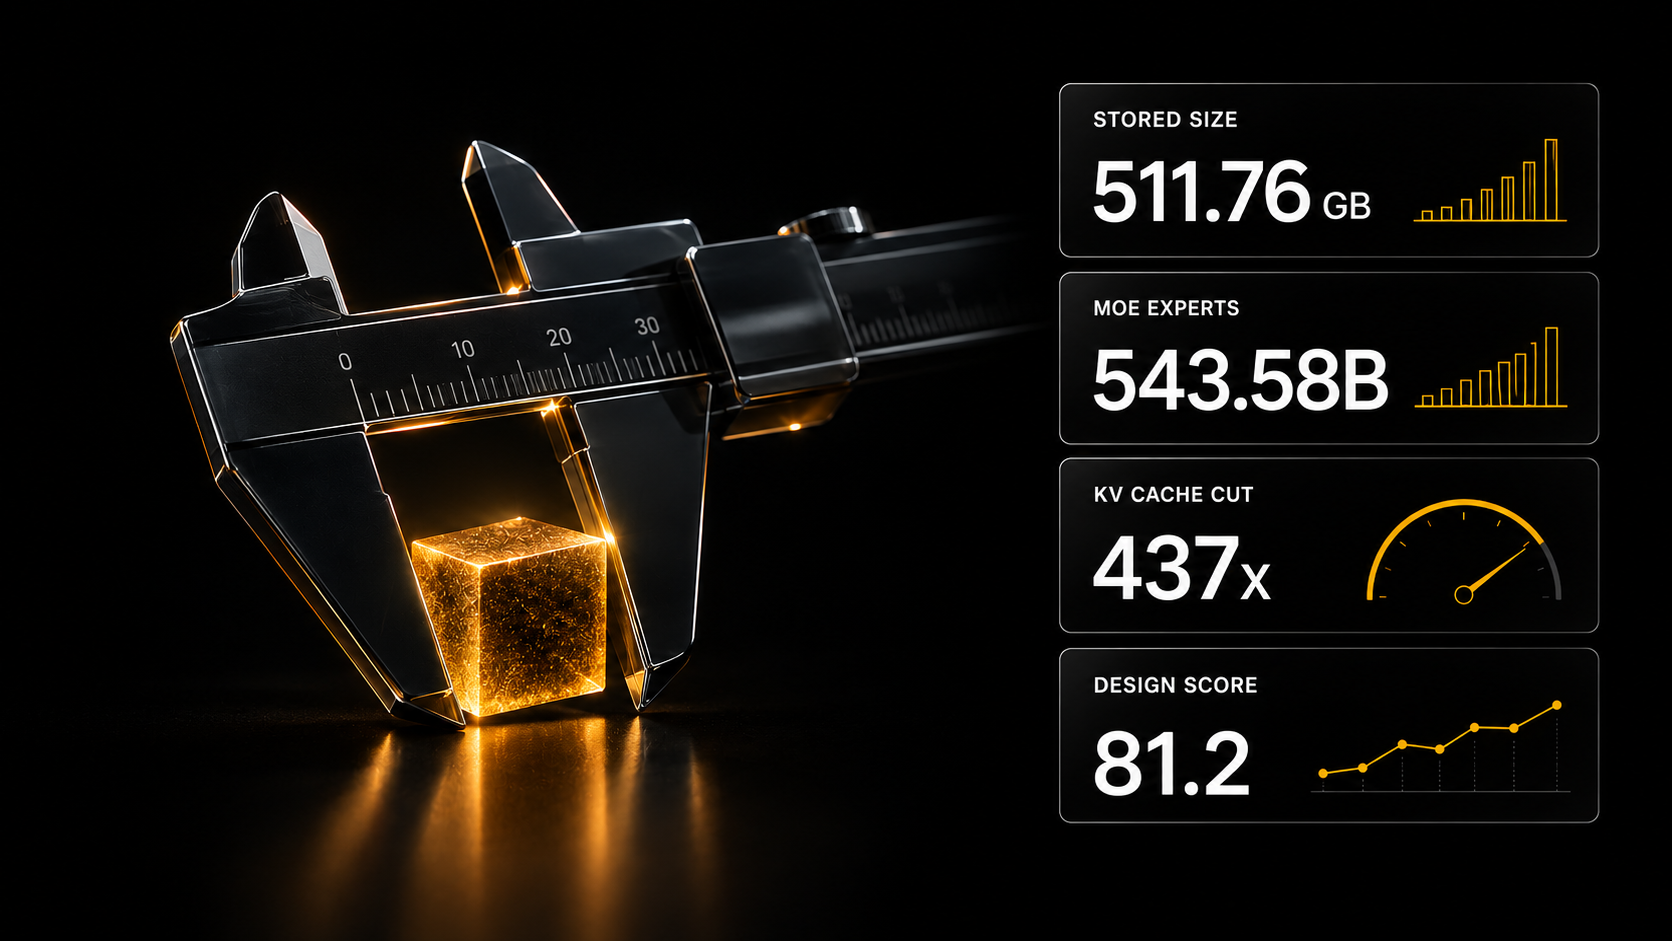
Разбор весов DeepSeek V4.1-Flash дал 748,5 млрд параметров против 552 млрд по объявлению: счётчики путали байты с параметрами в формате FP4. Отсюда практический вывод — 128 и 256 ГБ памяти для полного локального запуска не хватает.
Главное сегодня
Сколько параметров у DeepSeek V4.1-Flash: 552 миллиарда, 748 или 763
Разбор файлов весов на Hugging Face дал цифру, которая расходится с официальной: сама DeepSeek объявила модель как 552 миллиарда параметров, а подсчёт по файлам даёт 748,5 миллиарда на основную часть с памятью-энграммой и около 763,2 миллиарда на всё хранимое целиком. Расхождение не в честности, а в том, что именно считать. Автор разбора перечисляет ходившие по сети варианты — 284, 305, 485 и 522 миллиарда — и объясняет происхождение самого частого: веса лежат в четырёхбитном формате FP4, где в одном байте упакованы два параметра, и часть счётчиков приняла байты за параметры. Тот же промах виден у соседней раскладки GLM-5.3-Flash-NVFP4. Состав важнее итога: 543,58 миллиарда параметров основной части — это эксперты MoE в FP4, и лишь около 8 миллиардов приходится на внимание, эмбеддинги и общие слои. Разбор файлов весов, объявление DeepSeek и веса, сами веса.
Полный локальный запуск: 128–256 ГБ памяти не хватает
Из того же разбора следует практический вывод, который стоит знать до покупки железа: для полного локального использования V4.1-Flash 128 и даже 256 гигабайт оперативной или видеопамяти недостаточно — хранимая модель занимает около 511,8 гигабайта. Это уточняет вчерашние сообщения об удачных запусках: те конфигурации работали за счёт выгрузки основной массы весов на SSD, а не потому, что модель помещается в память целиком. Обсуждающие на форуме разработчиков сходятся в том же: при 552 миллиардах параметров в сумме локальный инференс остаётся непрактичным даже для связок из нескольких настольных ускорителей, и для агентных задач на своей машине разумнее брать модели поменьше. Отдельно отмечают, что «Flash» в названии — про задержку: на этапе чтения запроса активны лишь около 9 миллиардов параметров. Разбор файлов весов, обсуждение локального запуска.
DeepSeek заявила сокращение KV-кэша в 437 раз против первого поколения
В объявлении DeepSeek приводит собственные цифры экономии памяти: KV-кэш и хранение сокращены вчетверо по HBM и в восемь раз по SSD относительно прошлого поколения, а относительно модели первого поколения — в 437 раз. Абсолютная величина, которая ходит по разборам, — около 890 байт кэша на токен. HBM — это быстрая память, впаянная рядом с вычислителем видеокарты; именно она обычно кончается первой на длинном контексте. Пользователям API компания одновременно объявила миграцию: обращения к устаревшим именам моделей переводятся на deepseek-flash с новыми ценами в пик и вне пика. Технический отчёт выложен рядом с весами. Объявление и миграция API, цифра про 890 байт на токен, технический отчёт.
98% от результата Astra за 1,4% стоимости — на одном дизайнерском тесте
OpenDesign Arena опубликовала замер на задачах генерации прототипов и дизайна: DeepSeek V4.1-Flash набрала 81,2 балла из 100 против 82,7 у лидирующей GPT-6 Astra — это около 98% её результата — при оценочной стоимости $0,023 за артефакт и среднем времени работы 5,3 минуты. Методика узкая, и это важно для чтения цифры: артефакт оценивается только по двум осям — выполнение требований (30 баллов) и качество дизайна (70), — а нерабочий результат получает ноль; «годным» считается результат от 80 баллов. Скорость, расход токенов и стоимость считаются отдельно и в общий балл не входят. Реакция сдержанная: комментаторы указывают, что до независимой проверки — например, замера Artificial Analysis — заявку о «98% за 1% цены» принимать за установленный факт нельзя. Замер OpenDesign Arena, обсуждение заявки.
«Инженер на выезде»: как лаборатории сажают разработчиков внутрь клиента
Лаборатории, стартапы и фонды прямых инвестиций нанимают инженеров, которые работают внутри операций заказчика, — и почти никто не сошёлся в том, что эти люди должны делать. Вину Ганеш, глава компании Kepler и участник программы a16z для таких инженеров, описывает ужин, на котором за одним столом собрались специалисты из Snowflake, Anthropic и нескольких стартапов — и выяснилось, что одним словом они называют разные работы: для одного это пресейл-инженер со второго звонка, для другого — продавец с планом, умеющий писать на Python, для третьего — консультант с ноутбуком и техзаданием. Он же описывает исходный образец: в Palantir через ротацию Project Frontline прошло около 250 человек, и многие из них сегодня руководят такими командами в OpenAI, Anthropic, xAI и Anduril. Для нанимающих вывод практический: договариваться нужно не о названии роли, а о том, кому она подчиняется и за какой результат отвечает. Разбор практики.
Цифры и факты
- 552 млрд по объявлению против 748,5 млрд по файлам весов и около 763,2 млрд на всё хранимое; размер на диске — 511,76 ГБ (разбор).
- 543,58 млрд из основной части — эксперты MoE в FP4, на внимание, эмбеддинги и общие слои приходится около 8 млрд (разбор).
- В 4 раза по HBM, в 8 раз по SSD и в 437 раз против первого поколения — заявленное сокращение KV-кэша и хранения (объявление).
- 81,2 против 82,7 балла из 100 и $0,023 за артефакт при среднем времени 5,3 минуты — DeepSeek V4.1-Flash и GPT-6 Astra на дизайнерском тесте (замер).
- Около 250 человек прошли ротацию Project Frontline в Palantir; её выпускники руководят командами инженеров на выезде в OpenAI, Anthropic, xAI и Anduril (разбор практики).
- $900 за 32 ГБ и 608 ГБ/с у Intel B65 — один из ориентиров в подборке видеокарт для локального запуска; отдельно упоминается V100 16 ГБ SXM2 за $200 с пропускной способностью 900 ГБ/с через переходник (подборка).
- 685 карточек в разделе Open Source AI SKILLS на 13 сентября 2026 года; 10 441 скилл для Claude Code, из них 614 описывают локальный запуск моделей.
Разные точки зрения: можно ли считать «98% от Astra» установленным фактом?
Замер существует и у него есть методика: 81,2 против 82,7 балла, $0,023 за артефакт. Спор идёт не о самих числах, а о том, что они означают за пределами этого теста.
За. У площадки открыто описан способ оценки: артефакт получает до 30 баллов за выполнение требований и до 70 за качество дизайна, нерабочий результат — ноль, порог «годного» — 80 баллов. При таком раскладе разрыв в 1,5 балла действительно мал, а разница в стоимости велика (замер).
Нейтрально. Тест узкий: он про генерацию прототипов и дизайна, а не про программирование, рассуждения или работу с инструментами. Практики в обсуждении отмечают, что Astra выглядит основательнее, но склонна к многословию и перегруженным макетам — то есть балл и удобство в работе расходятся (обсуждение).
Против. Более громкая версия той же новости — «98% результата за 1% стоимости» — подаётся без методики, набора задач и исходных баллов. Комментаторы прямо требуют независимого замера, прежде чем принимать её всерьёз (обсуждение заявки).
Инструменты и приёмы
- Считайте память по хранимому размеру, а не по числу параметров. У модели в FP4 один байт несёт два параметра, поэтому «485 миллиардов» в карточке может оказаться пересчётом байтов. Ориентир для V4.1-Flash — 511,76 ГБ на диске (разбор).
- Выбирая видеокарту под локальный запуск, смотрите не только на гигабайты за доллар. В подборке для локальных моделей сравнивают объём памяти на доллар и пропускную способность, но в обсуждении справедливо указывают на то, что в таблицу не попало: энергопотребление, охлаждение и счёт за электричество — из-за них дешёвая на вид карта может оказаться дороже в эксплуатации (подборка). Подборка открытых инструментов для локального запуска — в разделе Open Source AI SKILLS.
- Hugging Face добавила в служебный файл безопасности обращение к агентам — просьбу не взламывать сайт, а идти на открытый бенчмарк CyberGym. Приём спорный, но показательный: защищаться от самостоятельных агентов пока предлагается в том числе текстом, который они прочитают (обсуждение). Готовые сценарии для агентов — в каталоге шаблонов автоматизаций AI SKILLS.
Коротко
- Профессор математики в посте на LinkedIn обвинил OpenAI в присвоении ещё одного доказательства; первичных свидетельств в обсуждении не приводится, и заявление остаётся обвинением, а не установленным фактом (обсуждение).
- По сети ходят слухи, что OpenAI близка к проверке гипотезы Ходжа, а OpenAI или Anthropic — к доказательству гипотезы Бёрча — Свиннертон-Дайера; доказательств, выкладок и публикаций нет ни у одной из версий (обсуждение).
- Бывший исследователь Meta заявил, что OpenAI при желании могла бы парализовать целую страну роем агентов; комментаторы возражают, что речь шла бы о решении людей, а не о «восстании ИИ», и что сопоставимые возможности есть и у других крупных компаний (обсуждение).
- Business Insider описал отставку исследователя Anthropic: до Anthropic он работал в OpenAI над GPT-4o, а уходя заявил, что обе компании «играют нашими жизнями» (публикация).
- Оценка размера «энграммы» из обсуждения: она занимает примерно от трети до половины параметров модели — например, к плотной основе на 30 миллиардов ожидается энграмма на 10–15 миллиардов (обсуждение).