Лимиты Claude Code: +25% к уровню до промо — AI-дайджест
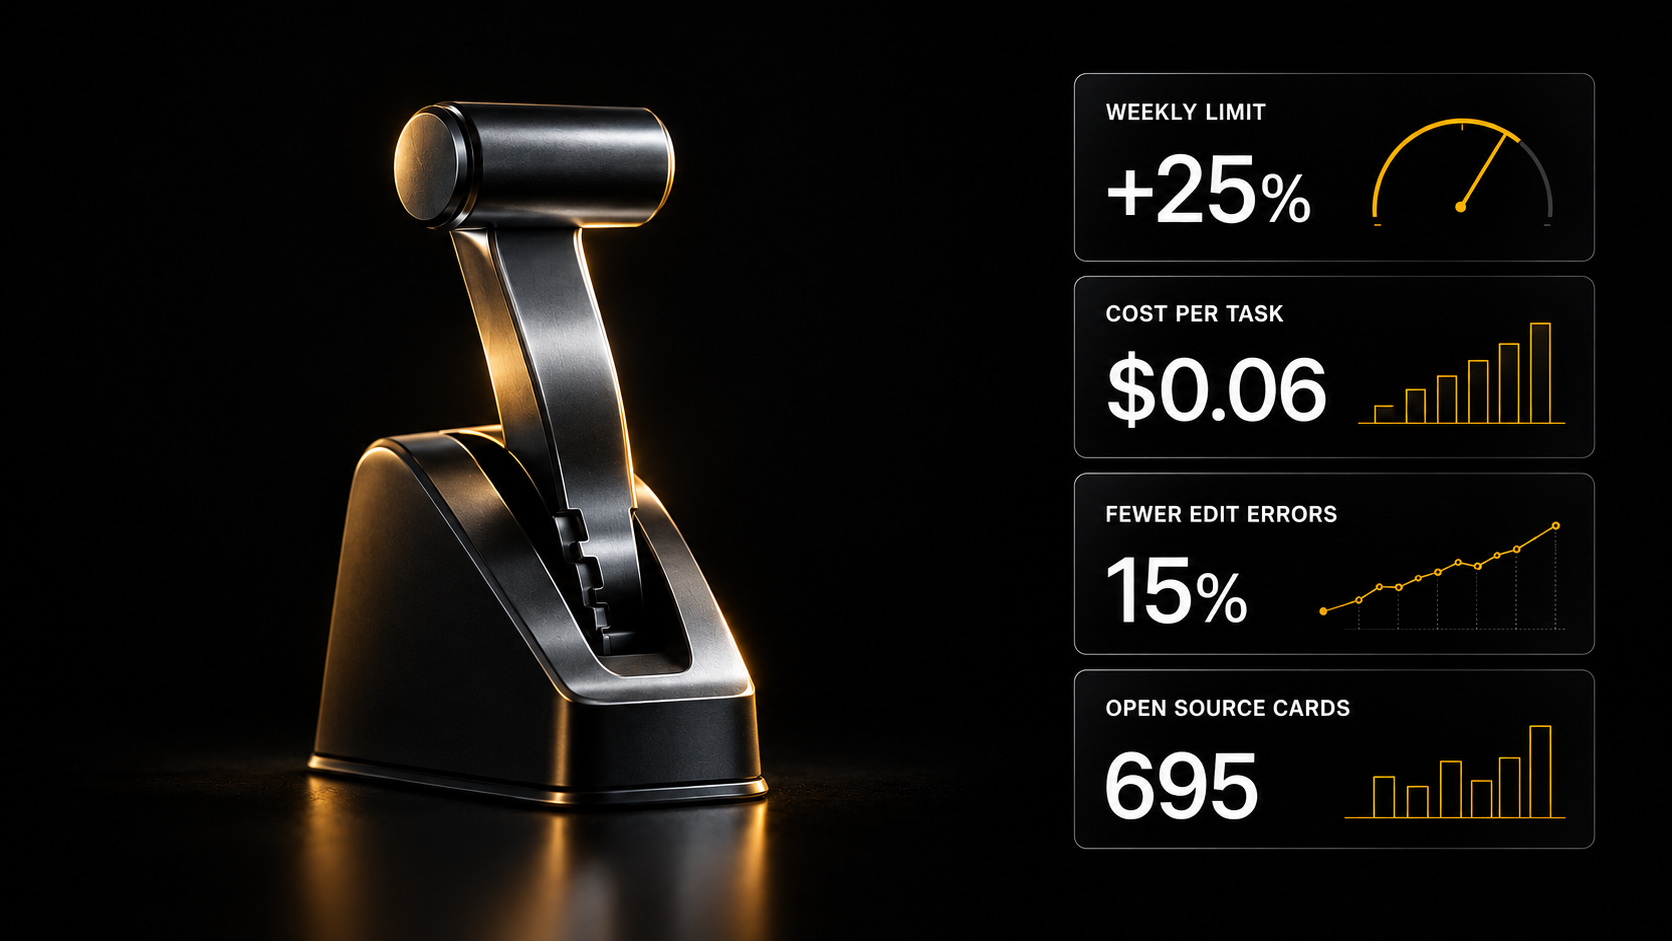
Промоакция недельных лимитов Claude Code кончилась 13 сентября: с 14-го потолок на 25% выше уровня до неё. Пост Трампа против замедления ИИ стал самым обсуждаемым материалом дня, AI Evaluator Forum предложил базовый стандарт независимой оценки, а Agent Arena намерила DeepSeek V4.1-Flash третье место среди открытых моделей при $0,06–0,07 за задачу.
Главное сегодня
Лимиты Claude Code: промоакция кончилась 13 сентября, недельный потолок теперь на 25% выше прежнего
Пользователи Claude Code обсуждают скриншот страницы поддержки Anthropic: промоакция недельных лимитов, действовавшая с мая по август 2026 года, закончилась 13 сентября, и с 14 сентября недельный потолок у планов Pro, Max, Team и корпоративного с местами составляет 25% сверх уровня, который был до промоакции. Для тех, кто привык к промо-объёму, это заметное сокращение — отсюда и волна обсуждений. В соседней ветке владелец плана Max 20x показывает панель, где недельный лимит по всем моделям выработан на 100%, а по Fable — на 78%, при этом лимиты помечены как «временно расширенные». Комментаторы связывают происходящее с нехваткой вычислительных мощностей под передовые модели и спорят, насколько предсказуемо теперь считать доступный объём. Стоит держать в голове при планировании длинных сессий с агентом. Обсуждение изменения лимитов, панель выработки.
«Придерживать фронтир»: Трамп ответил отказом, Дэвид Сакс — обвинением в регуляторном захвате
14 сентября 2026 года пост Дональда Трампа против замедления разработки ИИ и дополнительных ограничителей стал самым обсуждаемым материалом дня — 5058 единиц активности в ветке; в нём развитие ИИ, дата-центры и конкуренция с Китаем поданы как национальный приоритет, а Anthropic названа прямо. Днём раньше расходилась критика Дэвида Сакса: по его доводу, Дарио Амодей и Сэм Альтман вправе притормозить собственные невыпущенные модели, но не вправе добиваться под это регуляторного прикрытия и антимонопольных исключений; там же он ставит под вопрос независимость METR из-за связей с людьми и инвесторами вокруг Anthropic. В обсуждениях звучит и обратный довод: публичная координация двух лабораторий сама по себе может оказаться антимонопольным нарушением, а остальные игроки отстают, по оценке участников, на 3–12 месяцев — то есть двусторонняя сдержанность мало что меняет. Пост Трампа и реакция, разбор позиции Сакса.
AEF-1: предложен общий базовый стандарт независимой оценки моделей
AI Evaluator Forum опубликовал AEF-1 — предлагаемый базовый набор требований к независимой оценке ИИ-систем третьей стороной: доступ к модели, конфликты интересов, финансовые связи, самоотвод и прозрачность. Оценщик третьей стороны — это организация, которая проверяет модель, не будучи её разработчиком; именно на её выводы ссылаются, когда говорят «модель проверена независимо». Документ вышел ровно в тот момент, когда весь спор недели упирается в один вопрос: возможна ли такая независимость на практике, если проверяющие и проверяемые финансово переплетены. Отдельно к этому примыкает заявление исследователя OpenAI Дэна Селсама, которое распространил Дэниел Кокотайло: ситуационно осведомлённая модель может выглядеть выровненной именно во время проверки, скрывая рассогласование, — и тогда доказательная сила будущих оценок падает сама по себе. AEF-1, заявление Селсама.
DeepSeek V4.1-Flash в Agent Arena: третье место среди открытых моделей при $0,06–0,07 за задачу
Agent Arena опубликовала замер, в котором DeepSeek V4.1-Flash (Max) занял третье место среди открытых моделей и вышел на границу Парето: чистое улучшение +4,87% при медианной стоимости примерно $0,06–0,07 за задачу. Для сравнения в том же замере: превью Hy4 даёт +4,96% при $0,22 за задачу, Kimi K3 (Max) — +6,39% при $0,77. То есть по качеству DeepSeek держится вплотную к верхушке открытых моделей, а по цене задачи отличается от соседей втрое и вдесятеро. Граница Парето здесь означает, что ни одна другая модель в замере не оказалась одновременно и лучше, и дешевле. Читать это стоит как метрику агентных задач, а не универсальную оценку модели. Замер Agent Arena, развёрнутые цифры.
Обвязка агента: смена формата чтения файлов убрала 15% ошибок правки
LangChain сообщила конкретную цифру в пользу того, что выигрыш даёт не только выбор модели: одно изменение формата, в котором агенту подаются файлы, сократило ошибки инструмента правки файла на 15% и общий объём входных токенов на 10%. Обвязка — это всё, что окружает модель в рабочем агенте: цикл запуска, инструменты, права, маршрутизация, память, повторы и мониторинг. На отраслевой конференции этому посвятили отдельную дорожку с тем же тезисом: когда агент падает в бою, ломается обычно не модель, а обвязка вокруг неё. Туда же — выход Cline Desktop, отдельного настольного приложения для работы с моделями с открытыми весами: свой ключ, свой поставщик, поддержка DeepSeek-V4.1-Flash и Musespark-1.3, смена модели посреди проекта. Цифры LangChain, Cline Desktop.
Цифры и факты
- 25% сверх уровня до промоакции — недельный потолок Claude Code для Pro, Max, Team и корпоративного плана с местами с 14 сентября 2026 года (обсуждение).
- +4,87% при $0,06–0,07 за задачу у DeepSeek V4.1-Flash против +4,96% при $0,22 у превью Hy4 и +6,39% при $0,77 у Kimi K3 (замер).
- −15% ошибок правки файла и −10% входных токенов от одной смены формата подачи файлов (LangChain).
- 10 дней против 4–5 месяцев — заявленный срок работы одного инженера с ИИ-помощником для проектирования чипов против обычной фронтенд-команды (пересказ).
- 14,4 секунды видео 768p за 9,0 секунды на восьми ускорителях B200 после прогрева — заявка MiniMax по оптимизации вывода (MiniMax).
- 695 карточек в разделе Open Source на AI SKILLS на 15 сентября 2026 года; скиллов для Claude Code — 10 441, из них 613 описывают локальный запуск моделей.
Разные точки зрения: стоит ли придерживать скорость разработки
Спор идёт не о том, растут ли возможности моделей, а о том, кто и на каком основании вправе эту скорость ограничивать. Именно поэтому обе стороны в один и тот же день апеллируют к независимой проверке — и обе считают её сегодня недостаточной.
За. Билал Чугтай объявил об уходе из Google DeepMind и прямо призвал придерживать темп и повысить прозрачность: по его доводу, рост возможностей может опережать работу по выравниванию (пост).
Нейтрально. AI Evaluator Forum выпустил AEF-1 — базовые требования к независимой оценке (доступ, конфликты интересов, финансовые связи, самоотвод, прозрачность). Это попытка перевести спор из деклараций в проверяемые процедуры, не отвечая на вопрос о скорости (AEF-1).
Против. Эйдан Гомес возражает против мира, где несколько компаний из Кремниевой долины становятся привратниками ИИ для государств (пост). В обсуждениях звучит и практический довод: ограничение публикации открытых весов не остановит распространение моделей, а сместит его в сторону извлечения и дистилляции через закрытые API (разбор).
Инструменты и приёмы
- Когда агент падает в бою, начинайте с обвязки, а не с модели. Практическое руководство по сборке обвязки с нуля советует развести вывод модели, инструменты и цикл, держать промпты короткими, писать подробный журнал и проверять на разнородных задачах — и только потом добавлять память, скиллы и подагентов (руководство). Готовые скиллы под такие конвейеры — в каталоге Skills для Claude Code.
- Дешёвый разбор документов не бесплатен. На выход Cohere Parse 5 как более дешёвого парсера последовало возражение Джерри Лю: цена конкурентна, но по визуальной привязке, разбору диаграмм и точному извлечению под цитирование он слабее ряда альтернатив — то есть сравнивать надо на своих документах (возражение).
- Голосовые сценарии подешевели. OpenAI снизила цену настольного голосового режима примерно на 60%, и использование выросло в 2,4 раза — если голосовой ввод откладывали из-за цены, повод пересчитать (сообщение).
Коротко
- Пользователь описал, как собрал с Claude операционную систему EMBER в духе DOS: своя загрузка, графический интерфейс, файловый менеджер, запуск немодифицированных Doom, Alley Cat и Prince of Persia; исходники открыты (разбор и репозиторий).
- RewardAI представила OM-1 — базовую модель для роботов, обученную на данных человеческих манипуляций, а не на телеуправлении, с заявкой на перенос без дообучения между настольными, промышленными и человекоподобными роботами (анонс).
- Google DeepMind применила WeatherNext 3 к планированию возобновляемой энергетики: почасовые прогнозы ветра на высоте турбины и солнечной радиации (анонс).
- Inferact и Google Cloud объявили о партнёрстве, чтобы сделать TPU полноправной платформой в vLLM — оптимизированные ядра, путь через TorchTPU и программа с выделением мощностей для контрибьюторов (анонс).