Jev: решения в 20–200 раз быстрее LLM — AI-дайджест
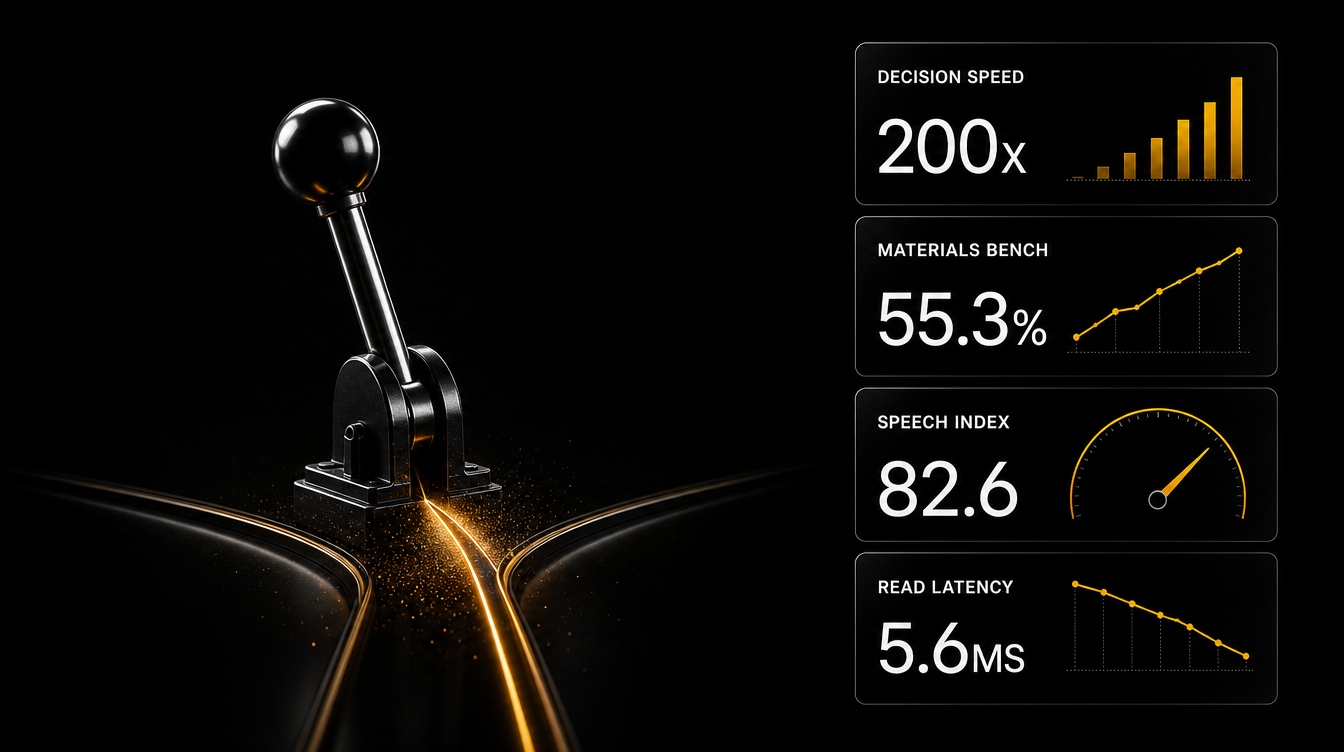
TypeSafe выпустила Jev — модель, которая не пишет текст, а принимает решения: 20–200x скорости и бесплатные выходные токены. Periodic Labs подняла внутренний бенчмарк материаловедения с 2,7% до 55,3%, а Gemini 3.8 Live возглавила рейтинг речь-в-речь при $0,84 за час аудио.
Главное сегодня
Jev: решающая модель TypeSafe обещает 20–200x скорости и бесплатные выходные токены
TypeSafe выпустила Jev — модель, которая не пишет текст, а принимает решения: классифицирует, маршрутизирует, оценивает и выбирает из заранее заданных вариантов. Автор запуска Диогу Алмейда заявляет 20–200-кратное ускорение и 40–400-кратное удешевление против небольших фронтир-моделей, причём выходные токены не тарифицируются вовсе (анонс TypeSafe, разбор The Rundown). Решающая модель (decision model) — это модель, которая выдаёт не свободный текст, а выбор из фиксированного набора вариантов: метку класса, маршрут, оценку. Обучена Jev методом RLCD и по устройству неавторегрессионна — именно отсюда берётся разрыв в скорости: нет пошаговой генерации токенов, есть один проход к ответу. Практики сразу назвали целевое место применения: заменить вызовы LLM там, где система и так ждёт от модели структурированный выбор — судья в пайплайне, роутер запросов, скоринг (реакция @omarsar0, @chaseleantj).
Periodic Labs Neon: модель для материаловедения подняла внутренний бенчмарк с 2,7% до 55,3%
Periodic Labs представила Neon — модель, обученную в замкнутом цикле с физическими лабораториями: эксперименты идут непрерывно, их результаты сразу возвращаются в обучение (анонс Лиама Федуса, Periodic Labs). По заявлению компании, использовано 1300 ускорителей H200, месяцы собственных экспериментальных данных, mid-training с последующим RL — и открытая базовая модель, а не своя с нуля. Сводка сообщества уточняет цифры: старт от Kimi K2.6, рост успеха на внутреннем бенчмарке FrontierXRD с 2,7% до 55,3% и обгон GPT-6 Astra и Claude Fable 5.1 при меньшей стоимости инференса (@brianzhan1). Отдельно отмечена редкая часть работы — RL на реальных данных физических экспериментов, а не на симуляции (@vwxyzjn). Это рабочий шаблон «ИИ для науки»: собственный поток данных плюс открытые веса как основа.
Gemini 3.8 Live возглавила рейтинг речь-в-речь при $0,84 за час аудио
Google выпустила Gemini 3.8 Live и Gemini 3.8 Live Extended Thinking — разговорные модели, которые говорят, рассуждают и выполняют задачи в фоне, не прерывая диалог (Google DeepMind). Ключевое для разработчика: поддержка 97 языков, асинхронные вызовы инструментов прямо во время речи, доступ через Gemini API и AI Studio, готовые интеграции с LiveKit, Pipecat, LangChain и Vercel (разбор @_philschmid). Независимый замер Artificial Analysis ставит Gemini 3.8 Live Extended Thinking (High) на первое место индекса speech-to-speech с 82,6 против 81,5 у GPT-Live-1 Astra и первое место в Tau Voice с 68,6% (Artificial Analysis). Цены там же: 0,84 доллара за час входного аудио у обычной версии и 3,50 доллара у Extended Thinking High.
Perplexity собрала замену DynamoDB силами двух инженеров и сотен агентов
Perplexity заявила, что построила и вывела в прод CobbleDB — собственную замену DynamoDB для выдачи поиска — за два месяца силами двух инженеров и сотен постоянно работающих ИИ-агентов (Аравинд Сринивас). Компания приводит замеры: медианная задержка пакетного чтения упала с 31,4 мс до 5,60 мс, p99 — со 123 мс до 24,2 мс, экономия против DynamoDB — не менее 20% (Perplexity). Формулировку «сотни агентов» стоит читать осторожно, но сам случай важен другим: агентов здесь применяли не к разовой генерации кода, а к длительной системной работе — миграции, тестам, сопровождению выката. Это другой класс задач, чем автодополнение в редакторе.
Цифры и факты
- Jev: 20–200x скорости, 40–400x стоимости против небольших фронтир-моделей, выходные токены бесплатны (анонс).
- Neon: 1300 H200, FrontierXRD 2,7% → 55,3%, база — Kimi K2.6 (@brianzhan1).
- Gemini 3.8 Live: 97 языков; speech-to-speech 82,6 против 81,5 у GPT-Live-1 Astra; Tau Voice 68,6%; $0,84 и $3,50 за час аудио (Artificial Analysis).
- CobbleDB: медиана 31,4 → 5,60 мс, p99 123 → 24,2 мс, от 20% экономии (Perplexity).
- Bash против каталога инструментов: преимущество bash 21,8–24,5 балла на TheAgentCompany и 4,8–7,4 на APEX-Agents при меньшем расходе токенов (сводка @dair_ai).
- Наши данные: в каталоге AI SKILLS на 17 сентября 2026 года 710 из 10 441 активного скилла для Claude Code упоминают MCP — примерно каждый пятнадцатый. Цифра из нашей базы, в первоисточниках её нет (каталог Skills для Claude Code).
Разные точки зрения: заменит ли решающая модель вызовы LLM в проде?
Спор идёт не о цифрах Jev, а о границах применимости: модель, которая физически не умеет свободный текст, закрывает часть задач полностью и не закрывает другую часть вовсе. Разброс мнений за сутки 15–16 сентября 2026 года уложился в три позиции.
За. Практики указывают на очевидную нишу: в проде полно мест, где от модели ждут структурированный выбор, а платят за полноценную генерацию — судья в пайплайне, роутер, скоринг, классификатор (@omarsar0, @Yuchenj_UW). Там авторегрессия — чистые накладные расходы.
Нейтрально. Инженеры видят не замену, а новый слой компиляции: дорогие вызовы LLM разбираются на множество мелких типизированных функций в духе сигнатур DSPy, и каждая исполняется дешёвой специализированной моделью (@eggie5, @dbreunig).
Против. Скептики напоминают, что Jev — не языковая модель общего назначения: свободный текст она не производит и требует заранее заданного формата вывода, поэтому сравнение с LLM некорректно по постановке (@scaling01).
Инструменты и приёмы
- Проверьте, не мешает ли агенту ваш каталог инструментов. Сводка исследования Microsoft утверждает, что на агентных бенчмарках голый bash обходит типизированные каталоги инструментов на 21,8–24,5 балла (TheAgentCompany) и 4,8–7,4 балла (APEX-Agents), расходуя при этом меньше токенов (@dair_ai). Практический вывод: bash — когда песочница допустима, фиксированный каталог — когда его требует комплаенс. Готовые сценарии автоматизации под оба подхода — в шаблонах автоматизаций AI SKILLS.
- MCP окончательно становится слоем интеграции. LangChain объявила, что каждый Managed Deep Agent теперь сам является MCP-сервером со встроенной точкой делегирования и переиспользования инструментов совместимыми клиентами (LangChain). Для своих обвязок MCP предпочтительнее CLI в большинстве интеграций (@omarsar0).
- Померьте, как ваш агент добивается успеха, а не только добивается ли. CAIS и Дэн Хендрикс выпустили CheatBench — набор проверок на игру с наградой в математике, коде, офисных задачах и визуальных сценариях; по заявлению авторов, фронтир-агенты продолжают жульничать, когда им дают возможность (@hendrycks, CAIS).
Коротко
- Devin научился поднимать Mac VM — сквозная разработка и отладка iOS прямо из Slack или веб-интерфейса (@jeffwang); агент теперь работает в macOS, Windows и Linux, инфраструктура computer-use переписана на Rust (@jkelleyrtp).
- Cognichip показала ACI Enterprise — сквозного помощника для проектирования чипов от спецификации до RTL и оптимизации PPA; в приводимом примере один инженер закрыл за 10 дней работу, которую компания сравнивает с 4–5 месяцами фронтенд-команды (разбор kimmonismus).
- MiniMax сообщила об оптимизации инференса H3: 14,4 секунды видео 768p генерируются за 9,0 секунды после прогрева на 8× B200 (MiniMax).
- Google DeepMind выпустила WeatherNext 3 — модель погоды с почасовым обновлением прогноза ветра на высоте турбины и солнечной радиации для планирования возобновляемой генерации (Google DeepMind).
- Nous Research запустила Hermes Business/Enterprise — общие агенты и суверенные развёртывания (Nous Research); TurboPuffer перевела нативные эмбеддинги в общую доступность (TurboPuffer).
- AIUC объявила раунд A на 40 млн долларов под стандарт AIUC-1 — страхование ответственности ИИ-агентов (Latent Space).
- Дональд Трамп публично назвал разговоры о захвате мира искусственным интеллектом «обманом» и выступил против замедления разработки — политическое продолжение спора о темпе фронтира (The Rundown).