Открытый Jev за двое суток: 90% против 93% — AI-дайджест
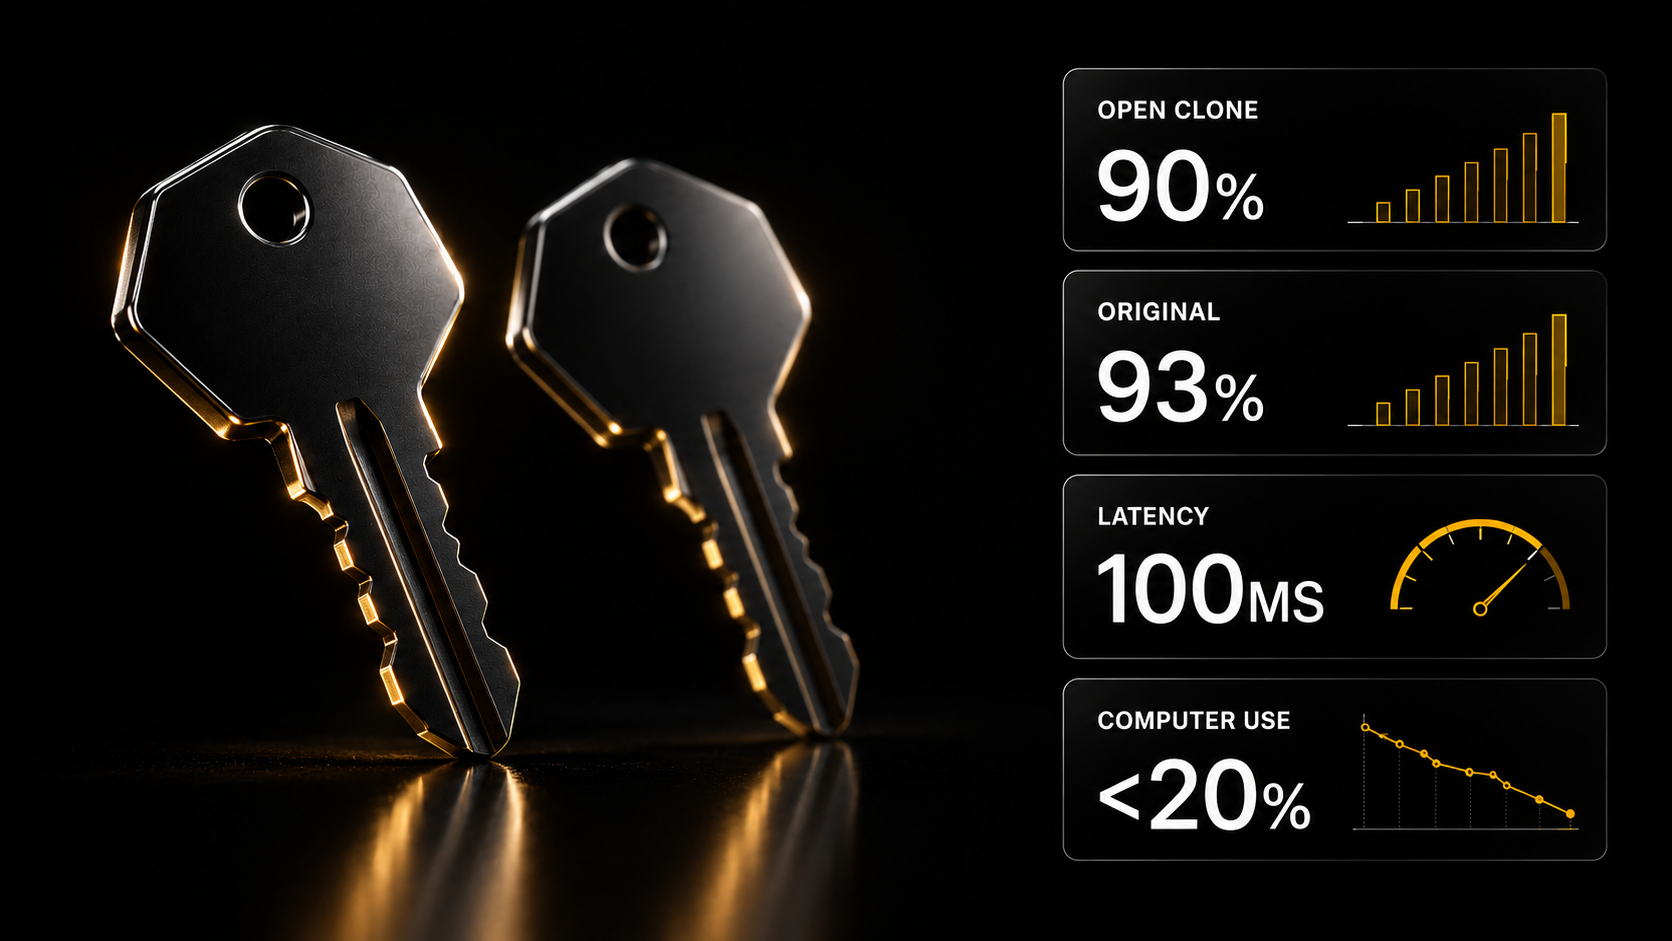
Решающая модель Jev получила открытые копии за двое суток: Bespoke Nimble на Qwen3.5-9B даёт 90% против 93% у оригинала. Claude Code начал читать AGENTS.md, а Anthropic и Accenture вкладывают от миллиарда долларов в независимую оценку моделей.
Главное сегодня
Открытые копии Jev вышли через двое суток после анонса
Решающая модель Jev, показанная 15 сентября 2026 года, получила открытые воспроизведения за двое суток. Bespoke Nimble — «открытый Jev», собранный дообучением LoRA поверх Qwen3.5-9B на синтетических контрастных данных с ограниченным декодированием: на кураторском наборе базовая Qwen выросла с 66% до 90% против 93% у самого Jev, при 100 мс на H100 и возможности запуска локально (анонс Bespoke). На другом конце — Kev-0.5B на базе Qwen2.5-0.5B, который работает на макбуке (анонс). Одновременно Jev появился как модель оценки в Braintrust с заявленной в 400 раз меньшей стоимостью скоринга (Анкур Гоял). Скорость воспроизведения показывает, что дело не в весах, а в постановке задачи: класс «дискриминативная модель вместо генеративной» повторяется на открытых базах почти сразу.
Claude Code начал читать AGENTS.md — конвенция стала стандартом
Claude Code версии 2.1.277 теперь ищет файл AGENTS.md, если в проекте нет CLAUDE.md, с переключателем на уровне конфигурации (анонс разработчиков). AGENTS.md — это файл с инструкцией для кодинг-агента в корне репозитория: что за проект, как его собирать, какие правила соблюдать. Значение шага не техническое, а отраслевое: формат, который до сих пор поддерживали одни инструменты и игнорировали другие, признан общим. Практическая выгода видна сразу — исчезает нужда в файлах-переходниках, которые просто ссылались с одного формата на другой (Саймон Уиллисон). Для команд, ведущих несколько агентов параллельно, это означает одну инструкцию вместо трёх копий с расхождениями.
Anthropic и Accenture вложат не меньше миллиарда долларов в независимую оценку моделей
Anthropic объявила партнёрство с Accenture по независимой оценке фронтир-моделей: стороны рассчитывают вложить не менее 1 млрд долларов за пять лет, чтобы построить мощности для такой проверки (анонс Anthropic). Это продолжение спора о внешнем надзоре, который идёт с 14 сентября, и первая заявка такого масштаба. Реакция оказалась от сдержанной до враждебной: критики сомневаются, что консалтинговая фирма — подходящий носитель для ред-тиминга моделей и оценки защитных мер, а Transluce напоминает, что вопрос не в объёме вложений, а в условиях независимости и реального доступа (позиция Transluce). Параллельно давление идёт и со стороны регулятора: губернатор Калифорнии подписал указ о созыве экспертной панели для подготовки более жёстких законов о безопасности ИИ, включая возможные аварийные выключатели и встроенных внешних наблюдателей (The Rundown).
Команды разносят модели по ролям: фронтир на план, дешёвая на исполнение
Практики описывают одну и ту же схему сборки: сильная модель планирует, дешёвая исполняет. Один из стеков — GPT 5.6 Sol XHigh на планирование, GLM 5.3 Flash на реализацию, DeepSeek V4.1 Flash на остальное (разбор Ахмада Османа). Экономика такого перехода измерима: внутренний конвейер базы знаний прошёл путь Opus → Sonnet → GLM 5.2 → GLM 5.3 Flash и урезал расходы примерно на два порядка с весны (Кайл Расселл). Цена верхней планки при этом видна на конкретных цифрах: у GPT-6 Astra режим повышенного усилия поднял детекцию с 82,1% до 83,6% mAP@50, но примерно удвоил стоимость кадра — с $0,050 до $0,101 — и поднял задержку с 11 до 32 секунд (замер Roboflow). Полтора пункта за двойную цену — ровно тот размен, из-за которого модели и разносят по ролям.
Цифры и факты
- Bespoke Nimble: 66% → 90% против 93% у Jev, 100 мс на H100 (анонс).
- Astra, режим усилия: 82,1% → 83,6% mAP@50 при росте цены $0,050 → $0,101 и задержки 11 → 32 с (Roboflow).
- CUA-Bench: все фронтир-модели набирают меньше 20% на реальном управлении клавиатурой и мышью в шести играх (замер Vals AI).
- Turbo-dLLM: ускорение обучения диффузионных LLM в 2,48 раза на 512К контекста и в 7,59 раза на 1М на 8× H100 (анонс).
- ABC-130K: 3500 часов телеоперации, 130 тысяч эпизодов, 195 задач, собрано на двуруком стенде за $8 тыс., корреляция симуляции с реальностью r = 0,91 (разбор).
- Наши данные: в каталоге AI SKILLS на 19 сентября 2026 года 100 скиллов из 10 441 упоминают
CLAUDE.mdи только 52 —AGENTS.md, то есть перевес прежнего формата пока двукратный. Цифры из нашей базы, в первоисточниках их нет (каталог Skills для Claude Code).
Разные точки зрения: Jev — новый примитив или переоткрытие классификаторов
Спор идёт не о цифрах, а о том, новое ли это вообще. Разброс за 18 сентября 2026 года уложился в три позиции, и он заметно разделил людей по стажу в машинном обучении.
Это архитектурный сдвиг. Ханьсяо Сяо считает, что Jev способен утянуть вызов инструментов, маршрутизацию и решения уровня MCP обратно от маленьких генеративных моделей к дискриминативным (позиция). Развитие той же мысли — слой суждений с почти нулевой предельной стоимостью прямо на устройстве: уведомления, адаптация интерфейса, решения по датчикам (продолжение).
Это зависит от того, откуда вы пришли. Михаил Парахин отметил раскол: пришедшие в тему после ChatGPT восприняли Jev как откровение, а те, кто занимался машинным обучением до него, скорее недоумевают по поводу ажиотажа (наблюдение).
Демонстрации пока про скорость, а не про качество. Самое существенное возражение: почти все показы упирают на быстродействие, а стандартного бенчмарка для этого класса моделей до сих пор нет — сравнивать не с чем (возражение).
Инструменты и приёмы
- Сократите набор инструментов агента до четырёх. Разбор «налога обвязки» показывает, что простой набор — чтение, запись, правка, bash — выходит на Парето-фронт по результату на бенчмарках и при этом срезает лишние траты (разбор). Рядом вышла работа об эмпирическом исследовании устройства обвязки для кодинг-агентов: результат на бенчмарке всё больше определяется структурой обвязки, подачей контекста, бюджетом ходов и набором инструментов, а не самой моделью (работа).
- Дайте решающей модели браузер. Самое убедительное применение Jev на сегодня — управление браузером: связка LangChain с Jev показала себя на задачах вроде «игры в Википедию» и структурных рутин (разбор), а Cline выпустила плагин, дающий Jev браузер прямо в редакторе (анонс Cline). Готовые сценарии автоматизации под такие связки — в шаблонах автоматизаций AI SKILLS.
- Проверьте агента на управлении компьютером, а не только на тексте. CUA-Bench тестирует работу с клавиатурой и мышью в реальном времени на шести играх, три из которых закрыты от обучения; все фронтир-модели пока ниже 20% (анонс). Открыт и первый набор маленьких моделей управления компьютером — CUA-S1-FORMS (анонс).
Коротко
- В рейтинге RSI-Exam GPT-6 Astra держит первое место с 0,5126, Claude Fable 5.1 вошла второй с 0,4813, до опорной планки не дотянулась ни одна модель (обновление).
- Epoch AI сообщила, что ещё одна открытая задача FrontierMath решена в интерактивной сессии с GPT-6 Astra (Epoch AI); фонд SAIR запустил Open Math Model — открытые модели и инструменты для математики (анонс).
- Grok Voice Transcribe 2.0: 2,7% ошибок в потоковой расшифровке против 3,9% у предшественника, задержка 0,49 с после конца речи, цена прежняя — $0,20 за час потока (замер Artificial Analysis).
- fal выпустила H3 Max Lip Sync с медианным временем генерации 11 секунд и первым местом по скорости и качеству в собственных замерах (анонс); модель собрана переносом диффузионного RL на проверяемую задачу липсинка (подробности).
- ProgramAsWeights: функция описывается по-английски, компилируется один раз и дальше исполняется маленькой нейропрограммой локально на процессоре с выключенным Wi-Fi; код и модели открыты (анонс).
- Качество DeepSeek V4.1 Flash заметно выросло после расширения контекста до 1 млн токенов — довод в пользу того, что агенты прожорливы именно до контекста (наблюдение).