Claude Opus 5.5 дешевле Opus 5 на 40% — AI-дайджест
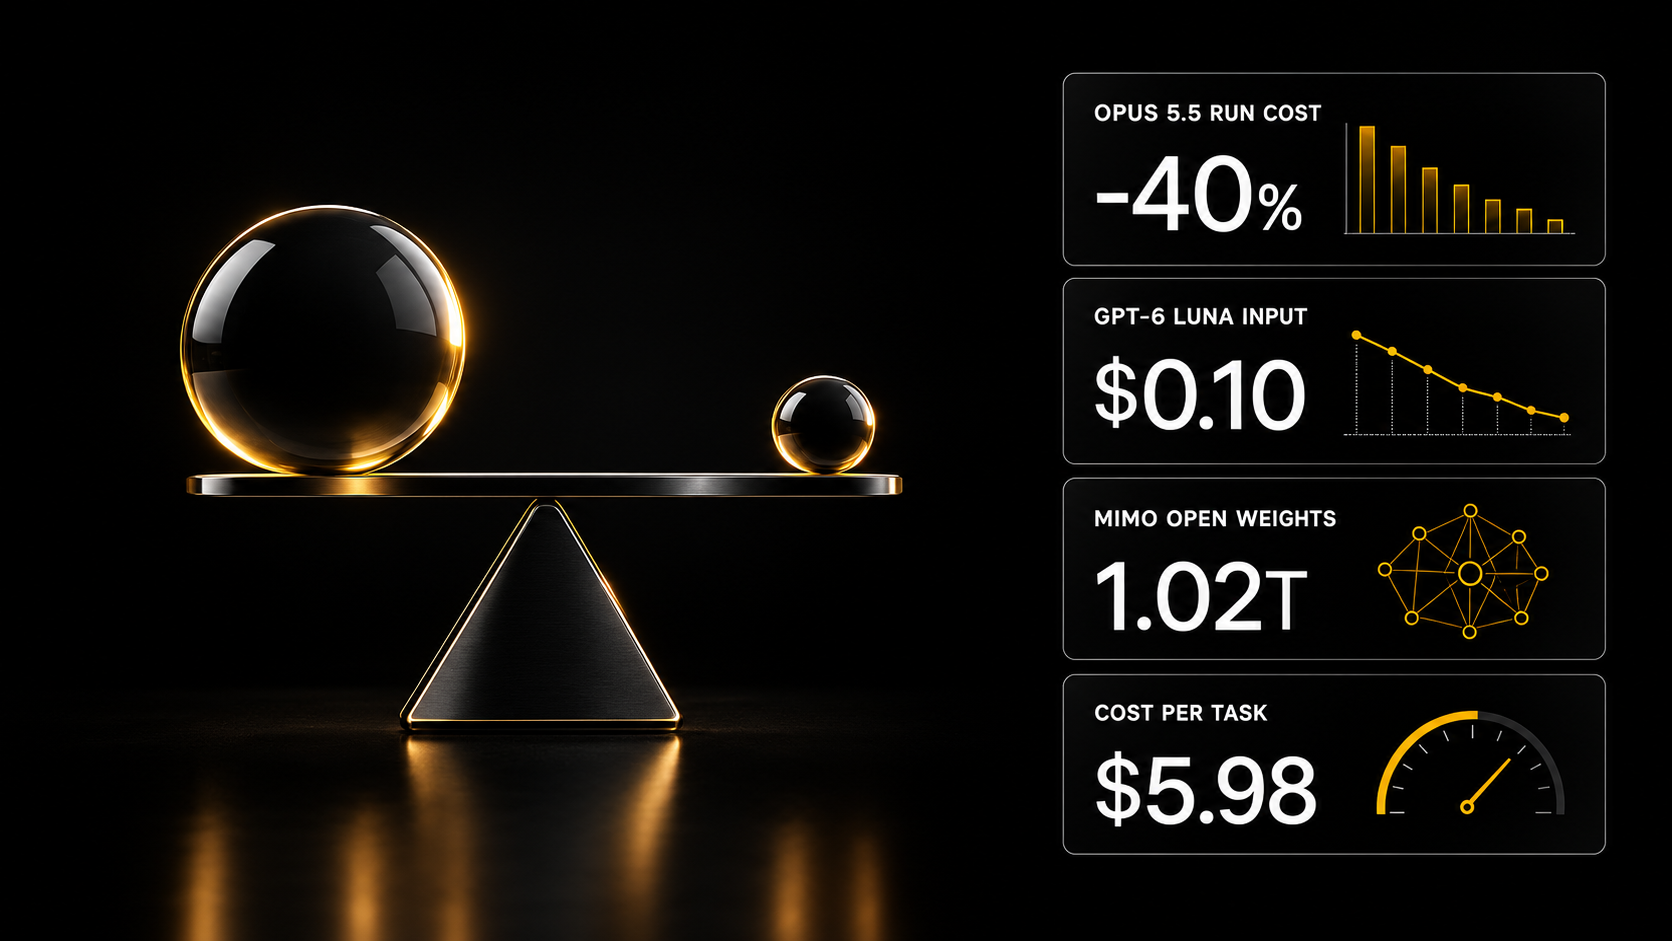
Anthropic выпустила Claude Opus 5.5 — уровень Fable 5.1 при цене эксплуатации на 40% ниже Opus 5, а OpenAI в тот же день ответила GPT-6 Sol и Luna по $2/$10 и $0,10/$0,50 за миллион токенов. Xiaomi открыла MiMo-V2.6-Pro на 1,02 трлн параметров под MIT.
Главное сегодня
Claude Opus 5.5: уровень Fable 5.1 при цене на 40% ниже Opus 5
Anthropic выпустила Claude Opus 5.5 и заявила уровень Claude Fable 5.1 «для большинства задач» при стоимости эксплуатации на 40% ниже, чем у Opus 5. Анонс 22 сентября 2026 года называет модель первой в новом семействе Claude 5.5; доступна сразу в приложении и в Claude Code. Цена токенов, по данным замерщиков, снижена с $5/$25 до $4/$20 за миллион входных и выходных токенов, окно контекста — 1 млн при 128 тыс. токенов вывода. Для платных подписок модель стала моделью по умолчанию в Claude Code и приложении, пятичасовые лимиты в Claude Code подняты на 20%, а из-за цены тот же лимит проходит примерно на четверть дальше. Отдельно Anthropic заявила защиту уровня Fable 5.1 по кибер- и биорискам с переводом спорных запросов на другую модель. Sonnet 5.5 и Haiku 5.5 обещаны в ближайшие недели.
Внешние замеры подтвердили заявку частично. Cursor поставил модель первой на CursorBench с 57,8%, Cognition — первой на FrontierCode 1.1 Extended с 65,3%, Vals — первой на RSI Index. На FrontierSWE она вторая с 62,3% — позади GPT-6 Astra с 65,5%, но впереди Fable 5.1 (56,3%) и Opus 5 (52,0%). На разборе таблиц ParseBench — 93,9%, плюс семь пунктов к Opus 5, при 5,8 цента за страницу. Отдельной темой стал стиль: Anthropic прямо обещала, что модель «общается естественнее» и выносит главное вперёд, а исследователь Anthropic подытожил проще: «мы починили письмо».
GPT-6 Sol и Luna: OpenAI ответила в тот же день ценой $2/$10 и $0,10/$0,50
OpenAI выпустила GPT-6 Sol и GPT-6 Luna через несколько часов после Anthropic — более быстрые и дешёвые модели, унаследовавшие наработки GPT-6 Astra. Объявление называет цены: Sol — $2 за миллион входных и $10 за миллион выходных токенов, Luna — $0,10 и $0,50; обе примерно вдвое дешевле предшественников из семейства GPT-5.6. Модели раскатаны в ChatGPT Work, Codex и API, Luna доступна бесплатным и Go-подписчикам в десктопном приложении, но пока не в обычном чате. Сравнение OpenAI строит не на абсолютном превосходстве, а на цене за задачу: по её примерам Sol на максимальном эффорте обходит Claude Opus 5 на AutomationBench примерно за 9% стоимости задачи. Эффорт — это заданный бюджет рассуждений модели: чем он выше, тем больше токенов уходит на обдумывание до ответа.
Партнёры подтвердили экономику быстро. Cognition сообщила, что Sol повторяет результат GPT-5.6 Sol при цене за задачу ниже на 61%, а Luna обходит предшественницу примерно за четверть цены. Perplexity сделала Sol оркестратором по умолчанию на «лёгком» уровне усилий. Инфраструктурная часть релиза может оказаться важнее самих моделей: OpenAI заявила скидку до 90% на чтение кэшированных входных токенов и выпустила панель наблюдения за кэшем с диагностикой того, почему кэш перестал переиспользоваться. Для долгоживущих агентов это прямые деньги: именно сброс кэша при переключении инструментов съедает бюджет длинных прогонов.
Xiaomi MiMo-V2.6-Pro: 1,02 трлн параметров под MIT и RL-прогон за $2,6 млн
Xiaomi выпустила MiMo-V2.6-Pro — модель с открытыми весами на 1,02 трлн параметров, из которых активны 42 млрд, под лицензией MIT. Релиз включает не только веса и технический отчёт, но и среды обучения с кодом RL-тренировки. Artificial Analysis поставила модель первой среди открытых весов на своём Intelligence Index со значением 46 и отметила цену $0,435 за миллион входных и $0,87 за миллион выходных токенов. Лицензию MIT подтвердили независимо — для триллионной модели это редкость: обычно открытые веса выходят под лицензией с оговорками.
Сильнее всего обсуждали не баллы, а стоимость обучения. По приведённым цифрам, финальный RL-прогон занял 130 часов, 75 млрд токенов и $2,6 млн — на порядок меньше, чем принято считать нормой для моделей такого класса. Команда сообщает, что масштабирует обучение с подкреплением на JAX и TPU, где переход на больший масштаб «в основном изменение конфига, а не переписывание кода». Если цифры подтвердятся, вывод прикладной: догоняющее обучение становится дешевле предобучения, и открытые веса продолжат сокращать отставание. Готовые к развёртыванию открытые проекты мы собираем в разделе Open Source, а общая картина открытых моделей — в гайде по open-source LLM.
Системная карта Anthropic: масштабирование до 100 параллельных агентов
Anthropic впервые опубликовала в системной карте замеры многоагентного масштабирования — до 100 агентов, работающих параллельно над одной задачей. На это обратил внимание независимый аналитик, назвав публикацию первой в своём роде для системных карт лабораторий; исследователь безопасности указал на раздел 8.12, где результаты выглядят как законы масштабирования, но для систем из агентов, а не для одной модели. Практический смысл в том, что параллельные агенты перестают быть приёмом энтузиастов и становятся измеряемой конфигурацией с предсказуемой отдачей.
Возражение пришло сразу и по существу. Автор бенчмарка ProgramBench заявил, что Anthropic считала результат на подмножестве из 166 задач против 200 и, по его мнению, исключила самые тяжёлые; позже он же разобрал разницу метрик — «средняя доля пройденных тестов» у Anthropic против «средней доли выполненных задач» у его команды. Это типичная для сезона история: спор идёт не о том, работает ли модель, а о том, что именно посчитали. Проверять такие заявления приходится на своих задачах — и ровно поэтому харнес и метрика важнее строчки в таблице.
Цифры и факты
- $5,98 против $5,86 — стоимость задачи Intelligence Index у Opus 5.5 и у Opus 5 в максимальном режиме по расчёту Artificial Analysis: снижение цены токена почти полностью съедено ростом их расхода.
- ~47% за квартал — с такой скоростью, по оценке Epoch AI, с 2023 года падает стоимость ИИ при фиксированном уровне качества.
- 0,610 при $4,13 за задачу — результат Opus 5.5 на собственном тесте Perplexity WANDR, по её данным это на 67,6% дешевле за задачу, чем у Fable 5.1.
- 21,2% — на столько Perplexity снизила долю неудачных вызовов инструментов в живом A/B-тесте, дообучив агента на реальных пользовательских сессиях.
- 80,9% на Terminal-Bench 2.1 — заявленный результат Step Code v0.1.0, CLI-агента для кодинга, выпущенного под лицензией MIT.
- 1,7% WER — показатель StepAudio 3 ASR на индексе AA-WER, фактически деление первого места среди непотоковых систем распознавания речи.
- 0,73 с до первого токена и 6,9 мВт·ч на запрос — Reka EdgeQ, мультимодальная модель, работающая прямо на NPU Qualcomm Hexagon с простаивающим GPU.
Наша сводка по ценам дня (объявленные цены за миллион токенов, вход/выход):
| Модель | Вход | Выход | Веса |
|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | закрытые |
| GPT-6 Sol | $2 | $10 | закрытые |
| GPT-6 Luna | $0,10 | $0,50 | закрытые |
| MiMo-V2.6-Pro | $0,435 | $0,87 | открытые, MIT |
Разные точки зрения: стал ли фронтир дешевле на самом деле?
За один день цена входного токена упала у обоих ведущих поставщиков — у Anthropic с $5 до $4, у OpenAI вдвое против предшественников, — но стоимость решённой задачи снизилась не везде. Расчёт Artificial Analysis по индексу даёт у Opus 5.5 $5,98 против $5,86 у Opus 5: модель тратит больше токенов, особенно на кодинге, и скидка уходит на этот рост.
За. Цена за задачу у партнёров падает измеримо: минус 61% у Cognition на Sol, минус 67,6% у Perplexity на WANDR, девятикратная разница в примерах OpenAI по AutomationBench. Там, где задача короткая и кэш тёплый, экономия реальна и видна в счёте.
Нейтрально. Скидки на чтение кэша меняют картину сильнее объявленных цен: OpenAI довела её до 90% и дала диагностику кэша, а в расчётах Artificial Analysis именно кэш оказался главным компенсатором роста расхода токенов. Значит, считать надо не прайс, а свой профиль нагрузки.
Против. Больше «усилий» не значит лучше и почти всегда значит дороже: в опубликованных таблицах нашёлся случай, когда максимальный эффорт стоил в 2,8 раза дороже среднего и дал на 3,2 пункта хуже на агентном кодинге. Практик сформулировал вывод коротко: оставайтесь на среднем.
Инструменты и приёмы
- Перепишите промпты под новое поколение. Anthropic опубликовала прямые рекомендации к Opus 5.5: отдавать задачу целиком, а не по шагам; явно описывать, что считается готовым результатом; убрать «думай внимательно» — оно больше не помогает. Разработчики отмечают, что старые приёмы промптинга могут конфликтовать с новым обучением, то есть накопленные шаблоны стоит перепроверить, а не переносить вслепую. Готовые шаблоны под конкретные задачи — в библиотеке промптов.
- Не бойтесь менять уровень усилий посреди сессии. На Claude Code версии 2.1.280 и выше переключение эффорта не ломает кэш промпта — значит, длинный прогон можно вести на среднем уровне и поднимать усилия точечно на трудном шаге, не оплачивая заново весь контекст.
- Сожмите модель, а не бюджет. Тим Деттмерс открыл фреймворк динамического сжатия в составе bitsandbytes2 с прицелом на 1,5–2,0 бита на вес и «ленивым» режимом, который сам подбирает компромисс между памятью, качеством и скоростью при развёртывании. Это прямой ответ на главную проблему локального запуска триллионных открытых весов — растущий KV-кэш.
Коротко
- Qwen-Image-2.1 заняла первое место среди открытых моделей сразу в двух аренах — редактирования изображений и text-to-image — по данным площадки.
- Ming-Image-0.1-Design на 6 млрд параметров вышла с открытыми весами и заявкой на первое место среди открытых моделей в рейтинге UI/UX-дизайна — анонс.
- Moondream выпустила локальные модели распознавания речи Parakeet Redux и Parakeet Ultra на 25 языков — объявление.
- fal описала стек H3 Max, который генерирует 5 секунд видео за 3 секунды — разбор оптимизаций.
- DigitalOcean открыла публичное превью управляемых агентов с поддержкой Claude Code, Codex и выбором из 75+ моделей — анонс.
- В VS Code появился экспериментальный Agent Merge: агент сам разбирает замечания ревью, упавшие проверки и конфликты слияния внутри пул-реквеста — объявление.
- NVIDIA DGX Spark: 128 ГБ единой памяти при весе 1,2 кг и заявленной поддержке локального инференса моделей до 200 млрд параметров — обзор.
- Amazon заблокировала шопинг-агента Muse от Meta — сообщает The Rundown.
- OpenAI заявила, что её модели решили 100 открытых математических задач — разбор Superhuman AI.
- Anthropic-модель показала заметный скачок в трёхмерном моделировании: исследователь компании говорит о серьёзном шаге в понимании 3D, а независимый обозреватель — что сцены в коде получаются не хуже, чем у GPT-6 Astra.