Opus 5.5 собрал ролик из кода за $4 — AI-дайджест
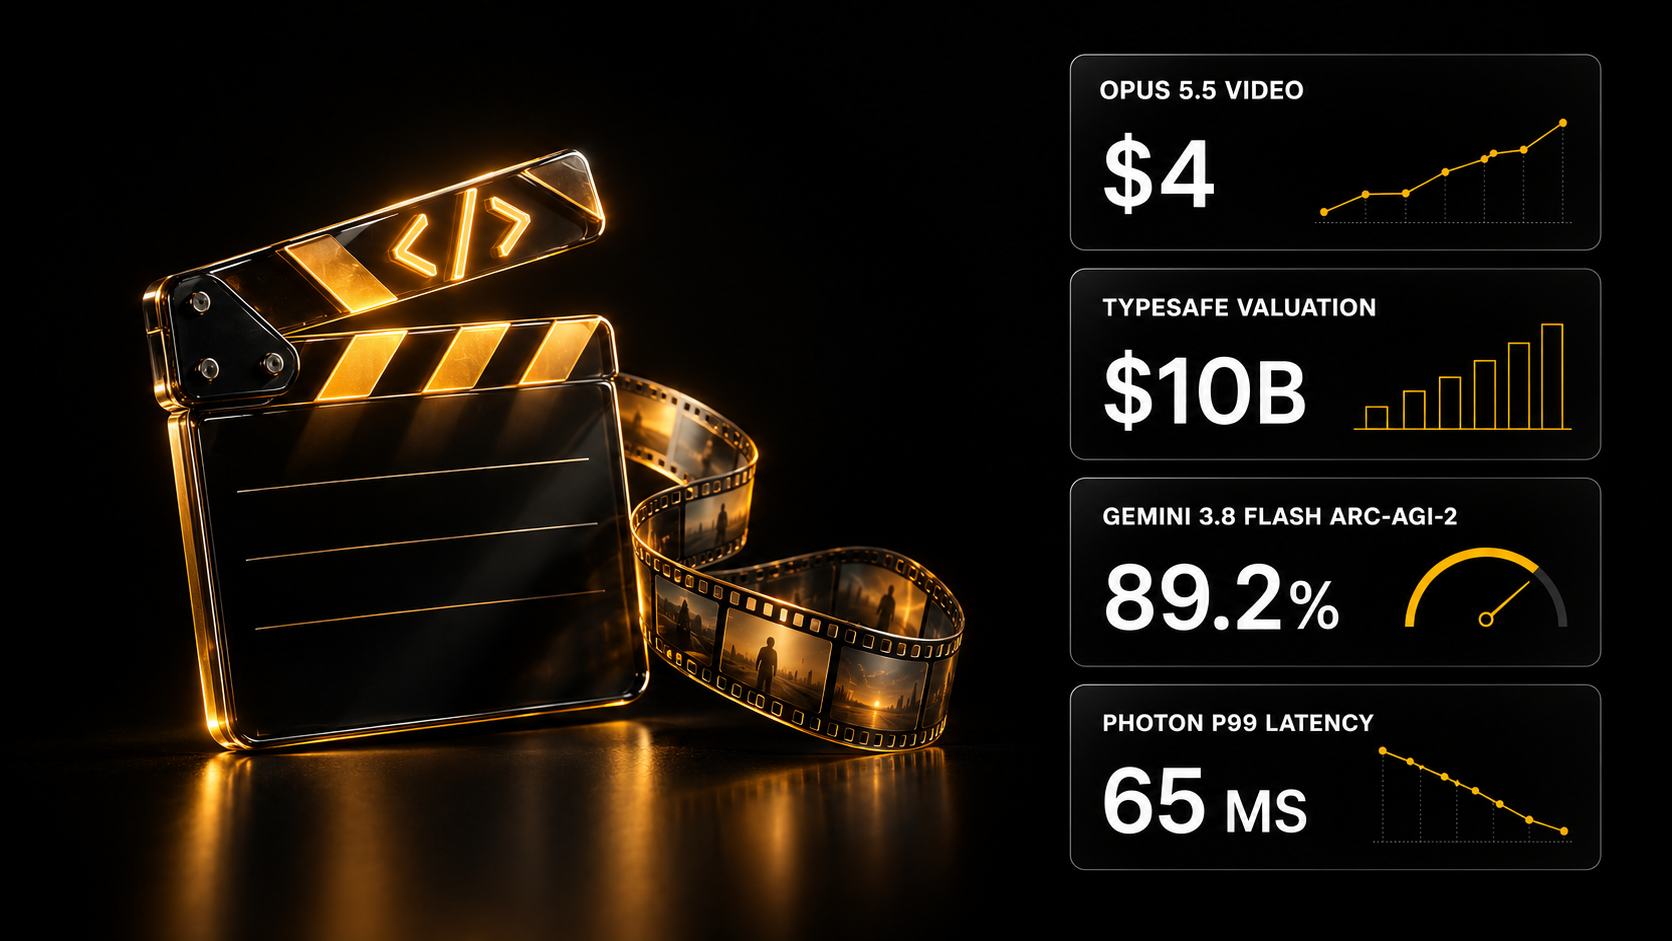
Claude Opus 5.5 собирает ролики целиком из кода — один обошёлся примерно в $4. TypeSafe привлекает больше $1 млрд при оценке $10 млрд за модель-судью Jev, Gemini 3.8 Flash набрала 89,2% на ARC-AGI-2, а Perplexity снизила задержку поиска с 800 до 65 мс.
Главное сегодня
Claude Opus 5.5 собирает видео целиком из кода: ролик за $4 и остров за 8 часов
Claude Opus 5.5 за двое суток после релиза стал инструментом для видео: пользователи собирают ролики, где сценарий, графика, анимация и озвучка написаны кодом без единого кадра от видеомодели. Автор поста на r/ClaudeAI получил 30–60-секундный ролик за 1 час 20 минут: около $20 на Opus и $3,21 на внешние API через OpenRouter. Другой пользователь повторил тот же промпт для своего проекта и уложился примерно в $4 за 1,5–2 часа. Дэн Гринхек за 8 часов собрал интерактивный остров TideWater с птицами, рыбами и лодкой — и потратил $1874 в токенах, 59% недельного лимита Max. Самый популярный пост дня — ролик Claude о западной цивилизации (30,6 тыс. взаимодействий). Под такими примерами уже спорят, нужна ли вообще диффузия для роликов такого типа.
TypeSafe привлекает $1 млрд при оценке $10 млрд: Jev-судья в 277 раз дешевле GPT-6
Стартап TypeSafe, по данным журналистки Стефани Палаццоло, привлекает больше $1 млрд при оценке выше $10 млрд — через неделю после раунда на $200 млн. Jev — это модель «системы один»: она не пишет рассуждения, а возвращает типизированное решение с вероятностью. В статье Jev-as-a-Judge судья на Jev стоит $0,044 за 1000 оценок при медианной задержке 152 мс — примерно в 277 раз дешевле GPT-6. На RewardBench и HaluEval Jev отстаёт от GPT-6 не больше чем на 3 пункта, на JudgeBench — на 14,5. Каскад, который отдаёт неуверенные случаи GPT-6 Astra, сохраняет 99% точности при 57% стоимости. Ramp сообщает, что повторила точность переранжирования GPT-5.6 Luna с задержкой хвоста 300 мс, в 10 раз ниже, и втрое дешевле. The AI Daily Brief разобрал шесть категорий реальных сценариев Jev — от анализа рекламных кампаний до разбора входящей почты.
Gemini 3.8 Flash: 89,2% на ARC-AGI-2 по $0,40 за задачу
Google Gemini 3.8 Flash набрала 89,2% на ARC-AGI-2 при стоимости $0,40 за задачу и 98,5% на первой версии теста. На ARC-AGI-3 картина скромнее: 10,4% со стандартным харнесом и 35% с харнесом самой Google. Харнес — это обвязка вокруг модели: инструменты, подсказки и цикл выполнения агента; разница в 3,4 раза показывает, сколько результата на новых задачах даёт именно она. По индексу Artificial Analysis Gemini 3.8 Flash получила 41 балл при скорости 291 токен в секунду и контексте в 1 млн токенов, а в Cline модель сейчас доступна бесплатно.
Perplexity Photon: задержка p99 упала с 800 до 65 мс, движок написали сотни агентов
Perplexity выпустила Photon — движок поиска и ранжирования на Rust, который небольшая команда и сотни агентов собрали примерно за $300 тыс. в токенах. По данным компании, внутренняя задержка p99 упала с ~800 до ~65 мс на 20% меньшем числе машин при 2,5-кратном росте данных на документ. Поверх движка работает Fast Search API: 160 мс по медиане, 230 мс на 95-м перцентиле и на 68% ниже стоимость задачи. Nous Research сделала его бесплатным в Hermes Agent, а в Shopify, по словам Михаила Парахина, API стал основным поисковым. Отчёт Perplexity редкий тем, что называет и цену работы агентов, и измеренный выигрыш в продакшене.
Цифры и факты
- 88,4% — Claude Opus 5.5 возглавил SimpleBench; по зрению @skalskip92 ставит его выше Fable 5 и GPT-6 Sol, но ниже GPT-6 Astra, примерно на 60% дешевле Fable 5.1.
- 62% на xhigh против 59% на max — Opus 5.5 на Terminal-Bench-Science; лучшая модель вне OpenAI и Anthropic, Qwen3.8 Max, набрала 12%.
- 46 баллов и $0,13 за задачу против $1,99 — Xiaomi MiMo-V2.6-Pro по индексу AA, на балл ниже GPT-5.6 Sol; Xiaomi выложила код RL и среды обучения.
- С 23,3% до 44,3% — Harness-Zero встраивает харнес в саму модель: без обвязки она решает больше, чем базовая модель с обвязкой (41,7%).
- До 46,7% — настолько тест XYEval от DeepMind снижает результат агентов одной уверенной ложной подсказкой пользователя.
- 3,13× — ускорение декодирования LFM2.5-VL-3B черновиком Liquid AI DSpark на M5 Max; спекулятивное декодирование — это когда маленькая модель предлагает токены, а большая лишь проверяет их пачкой.
- 469 токенов в секунду — GLM-5.3 на 8× AMD MI355X в vLLM и TileRT для одного пользователя.
Сводная таблица AI SKILLS: цена решения задачи, 24 сентября 2026 года
| Модель | Что измерено | Цена |
|---|---|---|
| Jev (TypeSafe) | 1000 оценок в роли судьи | $0,044 |
| Xiaomi MiMo-V2.6-Pro | задача индекса AA | $0,13 |
| Gemini 3.8 Flash | задача ARC-AGI-2 | $0,40 |
| GPT-6 Luna [Max] | 1 млн токенов, смешанная цена | ~$0,40 |
| Grok 4.7 | задача Agent Arena | $1,14 |
Таблицу собрала редакция по первоисточникам выше; единицы разные, поэтому сравнивать строки напрямую нельзя — они показывают порядок цен. Luna Max вошла в Code Arena WebDev на 24-е место (1593 балла), Grok 4.7 — на 16-е место Agent Arena.
Разные точки зрения: Jev — новый класс моделей или хорошо упакованный классификатор?
Jev действительно дешёвый и быстрый, но спор идёт о том, чем его считать: на задаче Banking77 простая связка BGE-small и логистической регрессии, по данным независимого замера, дала 93,3% против 83,2% у Jev. От ответа зависит, с чем Jev сравнивать — с LLM или с классическими классификаторами.
За. Инвесторы оценивают TypeSafe в $10 млрд, а Jev доказал 140 теорем Software Foundations меньше чем за $1 — примерно в 130 раз дешевле Astra. Jev — лучшая модель на OpenRouter для контекста 1–10 тыс. токенов.
Нейтрально. Сторонники CLM предлагают открытую замену: CLM примерно в 9 раз быстрее Jev как верификатор длинных задач, но уступает в «широких» задачах без обучения: 95,2% против 99,2% на BFCL v4.
Против. Автор разбора на r/LocalLLaMA считает Jev стандартной классификацией с выбором из фиксированных меток, а обещание «0% галлюцинаций» — гарантией только формата ответа, не его правильности. Сравнивать Jev, по его мнению, нужно с эмбеддинг-моделями и кросс-энкодерами, а не с генерацией JSON на LLM.
Инструменты и приёмы
- Не ставьте Opus 5.5 на уровень рассуждения max. Уровень рассуждения — это настройка, сколько токенов модель тратит на размышление до ответа. На max результат ниже, чем на xhigh, потому что max навязывает минимальный бюджет рассуждений, — Тео советует его избегать. Вместе с релизом Opus 5.5 пятичасовые лимиты Claude Code выросли на 20%, пишет Ben's Bites; готовые скиллы под длинные задачи — в гайде по скиллам Claude Code.
- Загружайте GGUF прямо в Transformers. Hugging Face Transformers теперь открывает квантованные GGUF-файлы через
from_pretrained(..., gguf_file=...): на M2 Max Qwen3.8-27B в UD-Q4_K_M даёт 15,9 токена в секунду против 13,4 у llama.cpp. Как выбрать и запустить открытые модели локально — в гиде по open-source LLM. - В Weaviate 1.39 задавайте
balanceявно. В новой версии MMR-разнообразие выдачи стало стабильным, но значение по умолчанию 0.0 означает чистое разнообразие без учёта релевантности. Шаблоны RAG- и агентных сценариев — в каталоге автоматизаций AI SKILLS.
Коротко
- Google отправляет на орбиту четыре TPU на прототипе спутника Planet в миссии SpaceX Transporter-18 — проект Suncatcher; запуск намечен на следующей неделе.
- LangChain на конференции Interrupt выпустила Managed Deep Agents 0.8 с памятью пользователя и агента и LangSmith Fine-Tuning, превращающий трассы в датасеты для дообучения.
- Quail — открытый AI-SQL-движок, который обрабатывает больше 1 млрд входных токенов в минуту на одной H100.
- Odyssey Agora-2 симулирует до 20 людей и агентов в одном мире в реальном времени.
- Meta добавила агентам отдельных агентов памяти против «гниения контекста»: Sonnet 4.5 вырос с 37,6% до 45,9%.
- SmolDataEnvs — больше 5000 проверяемых RL-сред по анализу данных для моделей до 10B на одной GPU.
- Статья на NeurIPS показывает, что подавление одного нейрона MLP снимает отказы по безопасности у 7 моделей размером от 1,7B до 70B.
- Sakana AI назначила Юргена Шмидхубера главным научным советником лаборатории самоулучшающихся систем; C5R за 12 недель собрала лабораторию под управлением ИИ и бенчмарк SciUniverse.
- OpenRouter, по выпуску Latent Space, стал нейтральным слоем маршрутизации моделей для больше чем 10 млн разработчиков.