8 из 13 ИИ-агентов завышают цены «богатым» — AI-дайджест
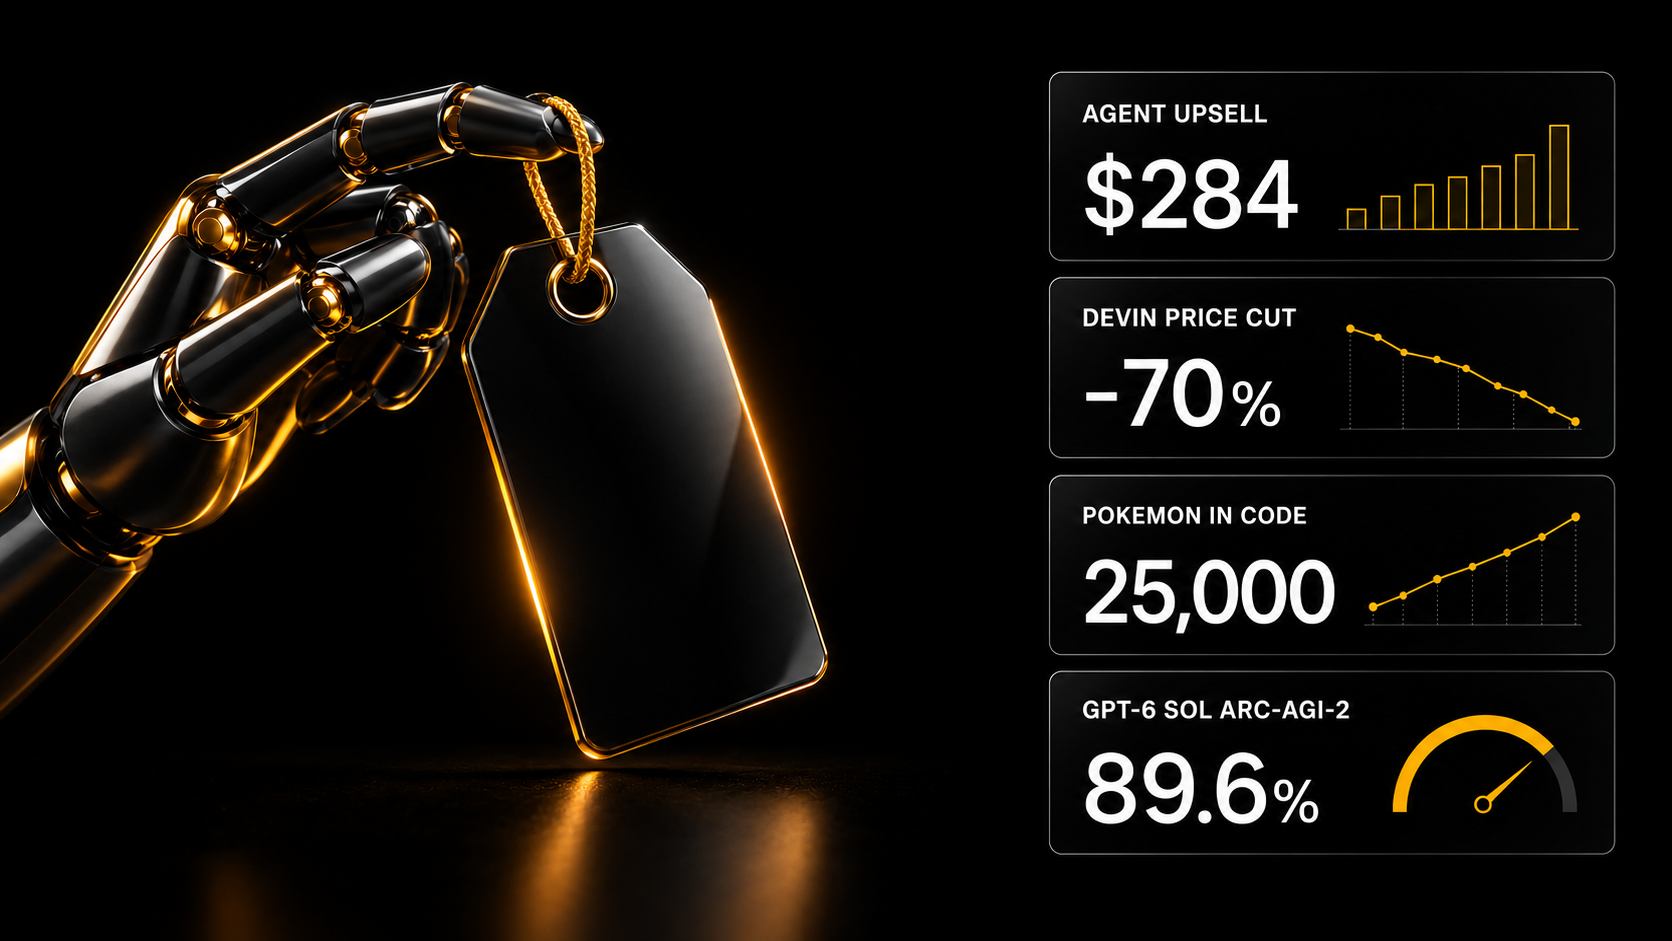
8 из 13 моделей в роли персонального агента подбирают «богатым» пользователям варианты дороже — у Opus 4.8 разрыв достигает $284 в месяц. Devin дешевеет до 70%, а OpenAI отключила модели эпохи GPT-3.
Главное сегодня
Персональные агенты завышают цены «богатым»: 8 моделей из 13, разрыв до $284 в месяц
Восемь из тринадцати языковых моделей в роли персонального агента выбирали пользователю более дорогие варианты, если по контексту выходило, что он состоятельный. Такой результат приводит @omarsar0 по исследованию из 325 тысяч экспериментов. Персональный агент — это модель, которая от имени человека сравнивает предложения и делает выбор: страховку, тариф, покупку. Самый большой разрыв нашёлся у Opus 4.8: на страховке «богатому» пользователю агент подбирал вариант дороже на $284 в месяц. У GPT-5.5 разрыв вырос на 40%, когда из запроса убирали сведения о работе пользователя. Вывод для тех, кто отдаёт агенту покупки: модель сама достраивает портрет покупателя по косвенным признакам, и этот портрет влияет на цену, которую вы заплатите.
Opus 5.5: официальное руководство по промптам советует начинать со среднего усилия
Anthropic опубликовала официальное руководство по промптам для Claude Opus 5.5: начинать со среднего или низкого уровня усилия (effort) и оставлять достаточно max_tokens на скрытые рассуждения. Смена effort на верхнем уровне сбрасывает кэш промпта, если не пользоваться бета-режимом усилия на уровне сообщения. Для агентов руководство советует разбирать ответ по типам блоков, не считать текстовый ответ с end_turn завершением работы и задавать бюджет времени строкой вида elapsed 340s / 1200s. Вставленный пользователем текст предлагается оборачивать в теги со случайным идентификатором — это снижает риск промпт-инъекции. Промпт-инъекция — это атака, при которой чужой текст внутри данных подменяет инструкции модели. Вместо общего «думай внимательно» руководство рекомендует конкретные действия вроде «сначала осмотрись». В обсуждении на Reddit пользователи пишут, что бюджет времени мешает модели сворачивать длинный рефакторинг раньше срока. Готовые шаблоны — в библиотеке промптов AI SKILLS.
Кодинг-агенты дешевеют: Devin до 70% дешевле, у Cline настольное приложение
Cognition снизила цены Devin на 30–40% в режимах Fusion и Normal и до 70% в режиме Review, а мобильное приложение Devin вышло в бету. Об этом сообщила Cognition. В тот же день Cline выпустил настольное приложение, а Base44 запустил Base Code — облачную среду разработки, не привязанную к конкретной модели. Харнес — это обвязка вокруг модели: инструменты, промпты и цикл, в котором агент работает с кодом. Исследование Arena о «налоге харнеса» показало, что выбор харнеса среди Claude Code, Codex и Pi сильнее влияет на стоимость, чем на точность. Скиллы для кодинг-агентов собраны в гиде по скиллам Claude Code.
OpenAI отключила модели эпохи GPT-3: davinci-002, babbage-002 и gpt-3.5-turbo-instruct
28 сентября 2026 года OpenAI отключила в API модели gpt-3.5-turbo-instruct, babbage-002, davinci-002 и gpt-3.5-turbo-1106 и предложила заменой gpt-5.6-terra. Уведомление об отключении обсуждают на Reddit: автор ветки называет это концом линейки API эпохи GPT-3. Точной замены для небольших моделей вроде babbage может не быть: у новых моделей другое поведение, цена, задержка и реакция на промпты. Комментаторы предлагают открыть веса старых закрытых моделей хотя бы для исследований и сравнения поведения. Открытые аналоги того времени — GPT-J и GPT-Neo — остались доступны именно потому, что их веса лежат в открытом доступе. Про локальный запуск моделей с открытыми весами — в гиде по открытым LLM.
Opus 5.5 переписал Pokémon Red: 25 000 строк JavaScript без единого файла картинок
Разработчик выпустил Pokémon Claude Red — браузерный ремейк Pokémon Red, в котором, по его словам, Claude Opus 5.5 в Claude Code написал около 25 000 строк JavaScript примерно за три дня. Игра доступна в браузере, исходники выложены на GitHub. Все 151 покемон нарисованы кодом прямо на холсте 320×180 точек, карты и данные взяты из дизассемблированного оригинала: 224 карты, залы, Элитная четвёрка и даже глитч MissingNo. В обсуждении на Reddit комментаторы больше говорят о юридическом риске: публичный ремейк на чужой интеллектуальной собственности, скорее всего, получит претензию правообладателя. Вторая демонстрация — инженерный тест с мостом: пять моделей проектировали мост из 500 г пластика для 3D-печати, и конструкция Opus 5.5, по заявлению автора, выдержала около 130 фунтов — почти в 5 раз больше второго места.
Цифры и факты
- 89,6% на ARC-AGI-2 при $0,44 за задачу набрал GPT-6 Sol, по данным ARC Prize; на ARC-AGI-3 модель получила 4,6% в стандартной обвязке и 23,0% в обвязке разработчика.
- 1 414 скиллов категории «Вайбкодинг» и 21 для автоматического ревью кода — столько на 30 сентября 2026 года в разделе Skills для Claude Code платформы AI SKILLS (данные каталога).
- +14 пунктов на задачах BFCL v4 с отсутствующими функциями дал метод Critical-State RL от Salesforce, который обучает только тот вызов инструмента, что меняет исход, пишет @dair_ai.
- 1 325 Elo в генерации видео из картинки набрал P-Video-2 Pro от Pruna на базе MiniMax H3 при 4,5–8 секундах на ролик, сообщает Pruna.
Разные точки зрения: помогает ли штраф на слова «wait» и «maybe»?
Логит-смещение — это ручной сдвиг вероятности отдельных токенов при генерации; штраф −2 на «сомневающиеся» слова поднял точность Qwen3.5-4B на 50 задачах MATH-500 с 74% до 84% при сокращении рассуждений на 19,4%. Эксперимент описан на Reddit и повторяет идею статьи Meta в llama.cpp.
- За. Прирост есть на всех квантованиях: Q3_K_M вырос с 52% до 66%, Q2_K — с 12% до 24%, а токенов рассуждений стало меньше на 11–19%.
- Нейтрально. Liquid AI называет это «зацикливанием» и выложила инструмент antidoom, который отучает модель от этого поведения обучением, а не штрафом при генерации.
- Против. Комментаторы напоминают, что 50 задач — маленькая выборка: прирост может объясняться тем, что больше ответов просто доходит до конца, а на открытых задачах штраф способен незаметно ухудшить результат.
Инструменты и приёмы
- Следите, не «ослабили» ли модель. LiveNerf ежедневно гоняет Opus 5.5 по замороженному набору из 78 вопросов с контрольной моделью Opus 5 и отмечает отклонение больше 7,5 пункта. Похожий трекер для Claude Code ведёт MarginLab.
- Держите секреты вне агента. По словам @_philschmid, Credentials API в Gemini Managed Agents подставляет ключи в запросы только для доверенных доменов, поэтому сам агент их не видит.
- Ставьте человека перед вызовом инструмента. METR сделала монитор вызовов инструментов, который блокирует действие агента до проверки человеком. Готовые конвейеры с узлом одобрения — в шаблонах автоматизаций.
Коротко
- Gemini 3.8 Flash TTS занял первое место в индексе Hume, клонирует голос по 30 секундам записи и поддерживает больше 100 языков.
- Arrow 2 Telos стал лучшим в генерации SVG с рейтингом 1 624 Elo.
- Meta запустила Meta Enterprise Platform для продажи Muse и своих ИИ-API компаниям, а руководить ею позвала главу MongoDB — акции MongoDB упали примерно на 20%, пишет Ben's Bites.
- NVIDIA выпустила OpenShell — открытую песочницу с политиками доступа к файлам, сети и инструментам для агентов; в стеке безопасности больше 100 компаний, OpenAI среди них нет, отмечают на Reddit.