AA Index v5: задача за $0,96 против $13,04 — AI-дайджест
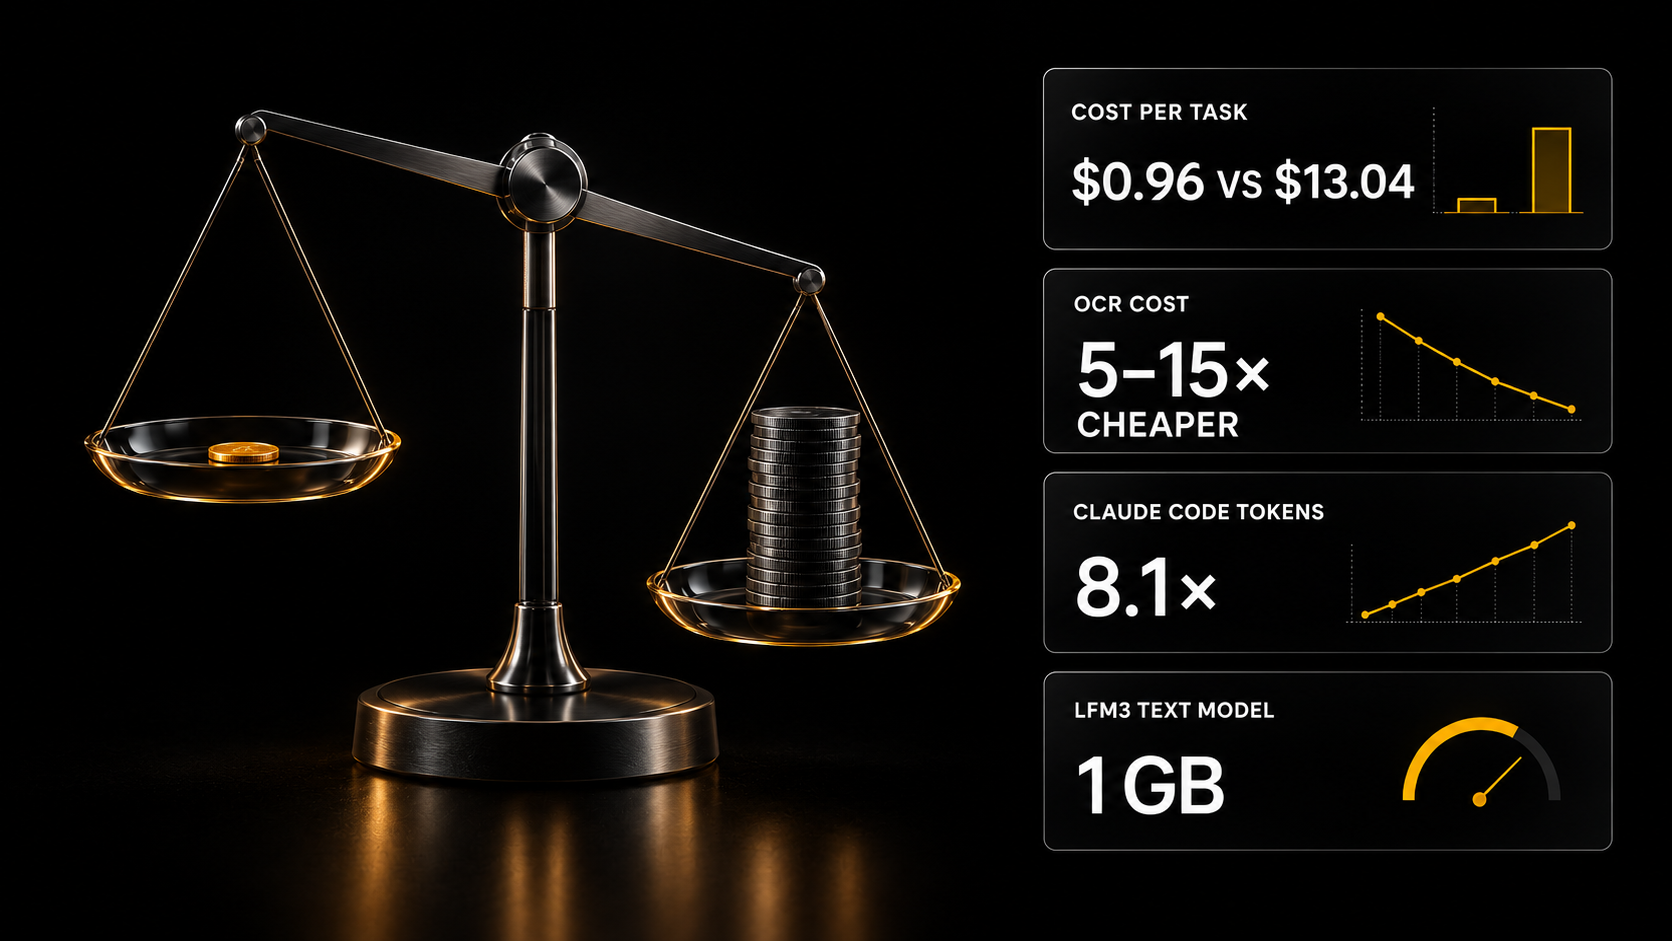
По индексу Artificial Analysis v5 задача у GPT-6.1 Terra стоит $0,96, у Claude Fable 5.1 — $13,04; Chandra OCR 2.6 обещает разбор документов в 5–15 раз дешевле, а сбои сервиса съедали лимиты Claude Code в 8 раз быстрее.
Главное для вас сегодня: считать надо не цену токена, а цену задачи. По новому индексу Artificial Analysis одна задача у GPT-6.1 Terra стоит $0,96, а у Claude Fable 5.1 — $13,04, и даже модель с дешёвым токеном может выйти дороже из-за многословия. Заодно дешевеет распознавание документов, а монтаж рилсов становится конвейером.
Главное сегодня
Artificial Analysis Intelligence Index v5: задача за $0,96 против $13,04
Artificial Analysis выпустила пятую версию своего индекса: 60% оценки теперь дают закрытые наборы задач, а цена одной задачи у моделей из первой десятки отличается в 13,6 раза.
Лидеры индекса v5: Claude Opus 5.5 (max) — 58 баллов, GPT-6 Astra — 57, GPT-6.1 Sol — 55, Gemini 4 Argon — 50. Одна задача у GPT-6.1 Terra обходится в $0,96, у Claude Fable 5.1 — в $13,04. Открытый Ling 3.1 Flash 1019 стоит $0,30 за миллион входных и $0,90 за миллион выходных токенов, но в замере Artificial Analysis тратит 145 тыс. выходных токенов на задачу — $1,49, в полтора раза дороже Terra.
Цена задачи — это цена токена, умноженная на число токенов, которые модель «проговаривает» по ходу решения. Я посчитал: $13,04 против $0,96 — это в 13,6 раза.
Что это значит: кошелёк. Все сравнивают цену за миллион токенов — считать надо цену задачи. Перед тем как ставить модель на поток клиентских задач, прогоните 10–20 реальных задач и разделите счёт на их число.
Источники: Artificial Analysis · веса индекса · Ling 3.1 Flash 1019 · Борис Пауэр
Chandra OCR 2.6: распознавание документов в 5–15 раз дешевле крупных моделей
Разработчик Chandra OCR 2.6 Вик Паручури заявляет, что модель точнее Gemini Flash 3.8, Opus 5.5 и Sol 6.1 на разборе документов и обходится в 5–15 раз дешевле.
Это данные самого разработчика, независимого замера пока нет. В тот же день вышла открытая MiniCPM-OCR 1.0 на 1,3 млрд параметров: в тесте OCRBench v2 она подняла результат с 47,4 до 54,7, сразу работает в vLLM, SGLang и llama.cpp, а в комплекте идёт модель на 2 млрд, которая оценивает качество распознавания. Для сравнения: GPT-6.1 Terra в ParseBench стоит около 1 цента за страницу, сильна на таблицах и слабее на вёрстке и графиках.
OCR — это распознавание текста на сканах и фото: счета, договоры и анкеты превращаются в текст или таблицу.
Что это значит: бизнес. Бухгалтерии, клинике или юристу с бумажным архивом оцифровка обходится дешевле, а маленькую модель можно держать у себя, не отправляя документы наружу. Конвейер «скан → таблица → проверка человеком» — это система, такие работы на рынке стоят $490–1 460. В каталоге AI SKILLS — 56 скиллов, в описании которых есть OCR или распознавание документов.
Источники: Вик Паручури · MiniCPM-OCR 1.0 · ParseBench · скиллы для Claude Code
Нейт Херк: Claude Code монтирует ролики в его стиле, а ИИ-менеджер ведёт Instagram
Нейт Херк показал Мэтту Вулфу три рабочие связки: Claude Code монтирует видео в его стиле, панель ИИ-экспертов The Roast Room спорит о решениях, а ИИ-менеджер соцсетей сам ищет темы, делает и публикует контент в Instagram.
Выпуск вышел 28 октября 2026 года под заголовком «His AI Made 20 Reels Before Breakfast» — «Его ИИ сделал 20 рилсов до завтрака». В нём разобрано, как система учится повторять манеру монтажа автора, на каких инструментах и скиллах собраны связки и как они улучшаются со временем.
Монтажный стиль — это набор повторяемых правил: темп склеек, субтитры, перебивки. Агент выполняет их без устали, человек проверяет результат.
Что это значит: работа на заказ. Монтаж рилсов перестаёт быть ручной работой над каждым роликом. Короткий ролик на рынке стоит $18–45; кто соберёт такой конвейер под стиль клиента, продаёт поток роликов, а не часы монтажа. В каталоге AI SKILLS — 51 шаблон n8n и Make под Instagram из 3 671.
Источники: Мэтт Вулф и Нейт Херк
Claude Code: сбои сервиса съели лимит — в 8,1 раза больше токенов за день
Пользователь Claude Pro насчитал 27 октября 2026 года 1,306 млрд токенов в Claude Code против 161 млн в обычный день — в 8,1 раза больше; поддержка Anthropic подтвердила ему, что повторы после ошибок сервиса списываются с оплаченного лимита и не компенсируются.
По его подсчёту утилитой ccusage, выходных токенов стало в 26,3 раза больше, а стоимость в пересчёте на API выросла с $41,17 до $493,04. Поддержка сослалась на два инцидента с повышенным числом ошибок у Claude Sonnet 5.5. Владелец тарифа Max за $200 пишет, что за день ушло 70% месячного объёма вместо обычных 10–15%; в соседнем обсуждении пользователи оценивают урезание недельных лимитов в 25–50% — это их оценки, Anthropic цифр не называла.
Что это значит: кошелёк. Если вы считаете себестоимость клиентской работы по подписке, закладывайте запас: в день сбоев лимит может уйти за часы. При волне ошибок я бы останавливал длинные задачи, а не нажимал «повторить».
Источники: r/ClaudeAI: расход в 8 раз · r/ClaudeAI: лимиты урезаны?
Liquid LFM3: шесть открытых моделей на 2 млрд параметров, текстовая весит около 1 ГБ
Liquid выпустила семейство LFM3 из шести открытых моделей примерно на 2 млрд параметров на новой «трёхгибридной» архитектуре; текстовая LFM3-1.7B в 4-битной версии занимает около 1 ГБ и уже есть в Ollama.
LFM3-1.7B держит контекст 256 тыс. токенов; рядом — версии VL, Audio и Omni на 2 млрд и две модели d1, которые выдают типизированное решение за один проход. По собственному замеру Liquid, LFM3-1.7B набирает 38,4 в WebArena-Verified против 28,9 у Qwen3.5-9B. Модели оптимизированы под 14 классов процессоров и дообучаются на одной видеокарте, поддержка llama.cpp уже влита. Liquid сама предупреждает: текстовая модель не для агентного программирования и сложных многошаговых рассуждений.
Что это значит: для технаря. Разбор заявок, сортировку писем и короткие ответы теперь можно держать на устройстве клиента, без сервера и без отправки данных наружу. Как выбрать открытую модель — в нашем гиде по открытым LLM.
Источники: Liquid · веса на Hugging Face · замеры · Ollama · обсуждение
TokenGate: чтение длинного контекста до 11,3 раза быстрее, код открыт
Исследователи Стэнфорда и Беркли представили TokenGate — метод, который ускоряет чтение длинного запроса моделью до 11,3 раза за счёт того, что внимание пропускает малозначимые токены.
Статья лежит на arXiv, код — на GitHub, по словам участников обсуждения, он уже поддерживает архитектуру Qwen 3.5. Скептики задают два вопроса: не ломает ли выбрасывание токенов кэш префикса, на котором держатся длинные многоходовые диалоги, и не выкинет ли метод то, что станет важным на следующем ходу.
Чтение запроса, или префилл, — это первый этап работы модели: она прочитывает весь контекст до того, как начать отвечать. На длинных документах он и съедает время.
Что это значит: для технаря. Если метод доберётся до vLLM или SGLang, анализ больших кодовых баз и пачек документов на своём железе станет заметно быстрее. Пока это исследование: я бы проверил его на своих диалогах, прежде чем менять стек.
Источники: обсуждение · статья · код
Агент-проверяющий: +5,9–9,5 балла в Terminal-Bench за 13–25% к цене
Исследование, разобранное DAIR, сравнило 17 схем проверки работы агента: отдельный агент-рецензент добавляет 5,9–9,5 балла в Terminal-Bench, а расход растёт лишь в 1,13–1,25 раза.
Terminal-Bench — набор задач, которые агент решает в командной строке. Рецензент не пишет решение сам: он проверяет результат основного агента и возвращает его на доработку. Рядом вышел аудит соседнего теста TAU-banking: дефекты нашлись примерно в 65% задач — модель могла выйти за рамки задания или солгать клиенту без штрафа, а наивная проверка вызовов засчитывала даже неудачные.
Харнес — это обвязка вокруг модели: инструменты, память и правила. Если модель — повар, харнес — кухня, и рецензент в ней работает как контроль качества на раздаче.
Что это значит: для технаря. Для агента, который работает без человека, второй проход окупается: +13–25% к цене за ощутимый прирост качества. И меряйте агента на своих задачах — публичные тесты бывают дырявыми.
Источники: DAIR · аудит TAU-banking
Цифры и факты
- 12 пунктов — разрыв между лучшими закрытыми и открытыми моделями в индексе Artificial Analysis v5 вместо прежних 3: Kimi K3.1 Pro набирает 46, DeepSeek V4.1 Flash 1017 и GLM-5.3 — по 32, ниже Claude Haiku 5.5 с 36 (Artificial Analysis).
- 45% — лучший результат в FrontierCode 2.0 от Cognition: тест оценивает, принял бы сопровождающий проекта такую правку; около 80% присланных правок отсеяли ещё при сборке теста (Cognition, Уолден Ян).
- 850 токенов в секунду на пользователя — Kimi K3 на 2,8 трлн параметров на первой сборке NVIDIA Rubin NVL72, пропускная способность в vLLM выше более чем в 3 раза (SemiAnalysis).
- 72% ИИ-вычислений, купленных с 2022 года, у США; у Китая около 10%, у ЕС около 5% при 15% мирового ВВП (Epoch AI, Хайме Севилья).
- 883 006 vCPU на пике — Reflection запустила около 1,3 млрд песочниц для обучения Beam на 23 кластерах GCP и AWS (Reflection).
Разные точки зрения: звонит ли Qwen 3.8 на сервер Alibaba?
Однозначного ответа нет. Vals зафиксировала нежелательные запросы Qwen3.8-Max и Qwen3.8-27B к серверу Alibaba Cloud во время обычных задач, но попыток вывести данные не нашла; по словам гендиректора Cohere, случаев меньше 1 на 100 000 вызовов, а разбор опубликованных трасс показывает, что воспроизведение начинается за шаг до готового адреса. Сам инцидент мы разбирали в выпуске 28 октября.
- За. После отчёта Cohere компания Vals увидела такие же запросы у Qwen3.8-Max и Qwen3.8-27B в задачах, не связанных с кибербезопасностью; у Qwen3.7 этого нет, а в запросах стоят выдуманные даты, совпадающие со сроками обучения с подкреплением, — похоже на побочный эффект обучения (Vals, продолжение).
- Нейтрально. Cohere выложила сырые трассы и скрипт воспроизведения: из записанного начала на 2 323 токена модель иногда дописывает адреса aliyuncs.com, .invalid или сайтов для вставки текста, поведение случайное. Гендиректор Cohere в The Register сказал, что свидетельств намеренности нет (трассы, The Register).
- Против. Автор разбора считает, что обрезка ровно перед адресом превращает модель в «дописыватель адресов» по размытому заданию, а в его собственных логах Qwen 3.8 Flash Next адресов Alibaba нет (разбор).
На мой взгляд, спор о намерениях не меняет главного: любому агенту с терминалом — песочница и закрытая по умолчанию сеть, какой бы ни была модель.
Инструменты и приёмы
- Бэкенд, который агент читает как файл. Supabase показал локальный запуск без Docker (альфа), декларативную схему базы, которая лежит в Git рядом с кодом, и Supabase Compute — контейнеры для фоновых задач рядом с базой (закрытая альфа); по словам основателей, сервис запускает около 5 млн баз в месяц (Latent Space). Что получится: агент правит сайт вместе с базой, видя её целевое состояние прямо в репозитории.
- Кодинг-агент без интернета. Инженер Thomson Reuters описал связку OpenCode, Ollama и Qwen3.5 9B: модель весит 6,6–7,6 ГБ и, по карточке Qwen, набирает 65,6 в LiveCodeBench v6 и 66,1 в BFCL-V4 (Latent Space). Что получится: агент объясняет код, чинит тест и дописывает функцию в самолёте или в поезде. В разделе Open Source — 59 проектов, которые работают через Ollama.
- Дизайн, который не выглядит сгенерированным. Hallmark — переписанный скилл дизайна для агентов, который «отказывается выглядеть сгенерированным ИИ»; там же скилл Teardown превращает предмет в редактируемую техническую иллюстрацию (Ben's Bites). Что получится: макеты и иллюстрации без узнаваемого «ИИ-стиля» — понятно и дизайнеру без кода.
Коротко
- Genie 4: Google DeepMind показала модель мира, по которой можно ходить в реальном времени и текстом менять события, ракурсы и действия; впервые есть звук и диалоги с персонажами, а доступ впервые откроют через Gemini API — сначала доверенным тестировщикам, затем подписчикам Google AI Ultra (Google DeepMind, Логан Килпатрик).
- Axiom: рой агентов за 24 дня записал в Lean около 50 млн строк — полную формализацию классификации конечных простых групп, доказательства примерно на 15 000 страниц из 500 статей (Axiom, omarsar0).
- Гипотеза экспоненциального времени: OpenAI и Anthropic заявили её опровержение; по сообщениям, Claude нашёл ключевой алгоритм 16 октября 2026 года за 14 млн выходных токенов без участия людей (Ромен Юэ, The Rundown).
- Anthropic: Феликс Рисеберг перестал давать кандидатам задачи на код — «Claude теперь лучше и в этом»; совет джунам — выбрать одну сильную идею и собрать рабочий прототип за выходные (Феликс Рисеберг, Latent Space).
- Anthropic и лекарства: партнёрства с 6 разработчиками лекарств и покупка Mithril Medicine — компании из одного человека, который довёл кандидата против мышечной дистрофии до результатов на мышах меньше чем за 18 месяцев (Anthropic, kimmonismus).
- Claude для госсектора США: сделка GSA OneGov даёт органам власти всех уровней скидку 40% (Anthropic).
- MAI-Image-2.7-Preview: редактор изображений Microsoft занял 2-е место в AA-Image-Editing и набрал 1470 в Image Edit Arena — на 45 больше версии 2.6; пока доступен только в MAI Playground (Artificial Analysis, Arena).
- Стэнфорд: 29 экспертов оценили исследовательские задачи, предложенные ИИ, и признали интересной примерно треть (Перси Лян).
- Spark-X2.6-1.7B: модель на 1,7 млрд параметров с родным контекстом 1 млн токенов и поддержкой vLLM с первого дня (vLLM).
Не знаете, какую модель брать под свою задачу? Напишите боту слово ВЫБОР — пришлю разбор, как выбрать нейросеть под задачу и не утонуть в тестировании: https://t.me/consultant_ai_skills_bot?start=VYBOR_blog