Legora: ИИ уже закрывает 60% работы юриста — AI-дайджест
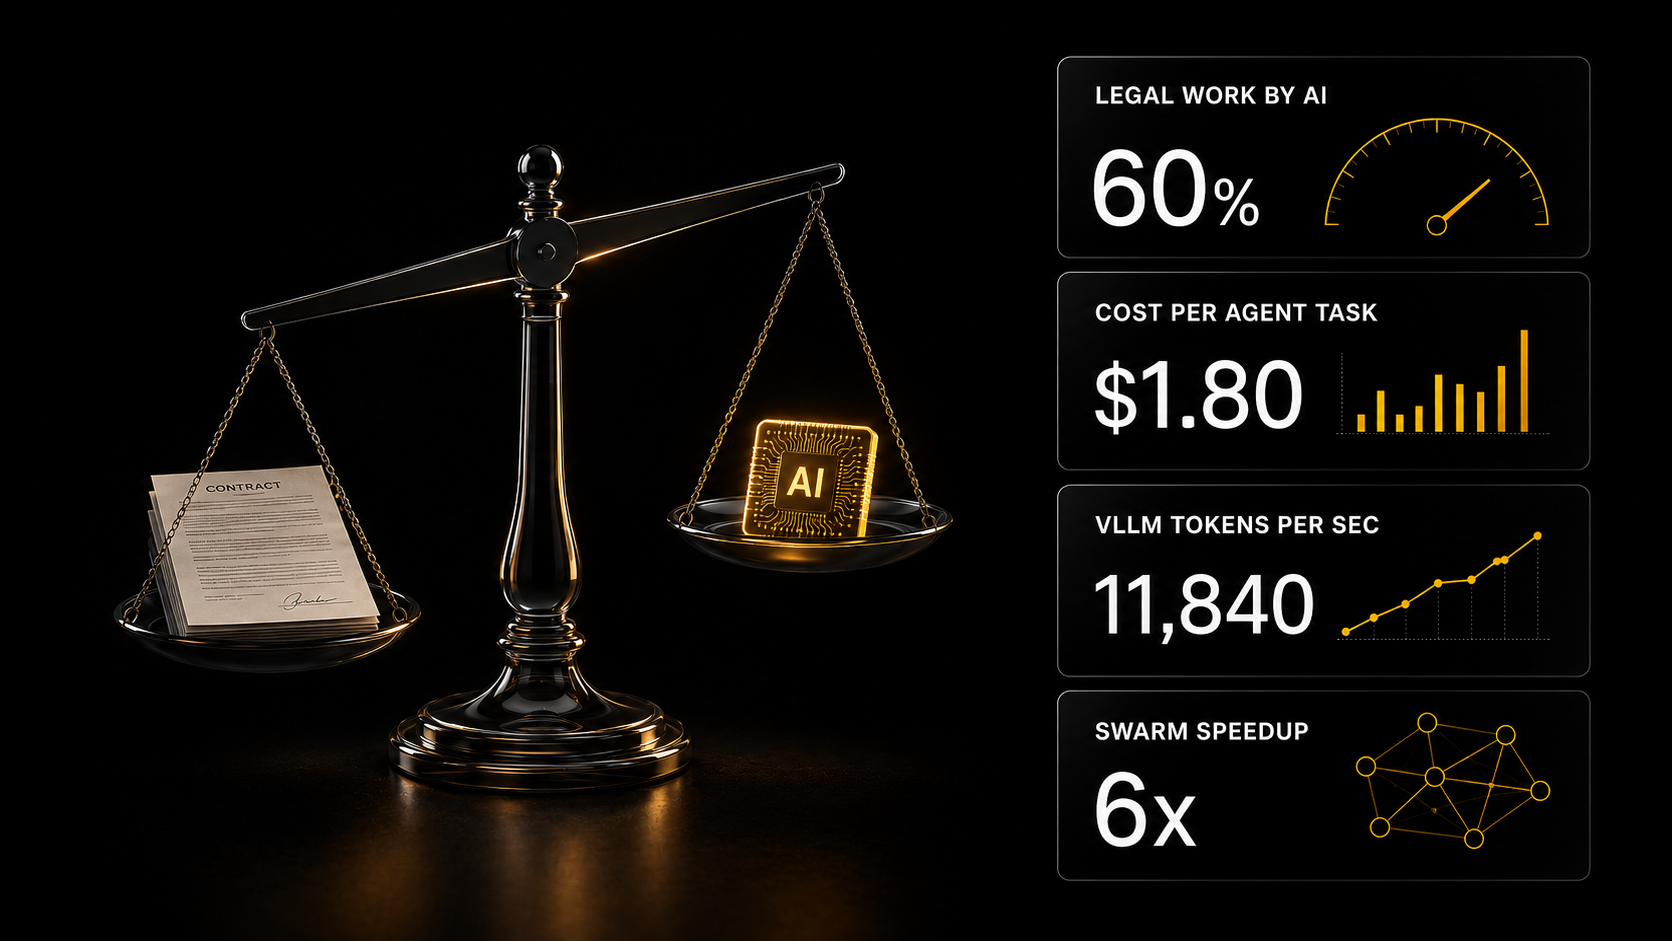
Legora вышла на $100 млн выручки за 18 месяцев: модели закрывают около 60% юридической работы. Gemini 4 Carbon — $1,80 за задачу агента, Cline удвоила отдачу GB300.
Главное для вас сегодня: юристы уже отдают модели больше половины рутины и при этом не увольняют младших — ценность сместилась к тем, кто умеет проверять работу ИИ. Если вы продаёте автоматизацию, считайте цену одной задачи агента, а не цену токена: на этом сегодня держится вся экономика.
Главное сегодня
Legora: модели уже закрывают около 60% юридической работы
Legora, сервис ИИ-агентов для юристов, вышел на $100 млн годовой выручки меньше чем за 18 месяцев после запуска и работает с более чем 1 800 клиентами.
По словам технического директора Якоба Лауритцена, модели уже хорошо справляются примерно с 60% юридических задач; по ним вопрос теперь в цене и скорости, а анализ контрактов на миллион токенов всё ещё требует более сильной модели. В октябре 2026 года компания привлекла $550 млн при оценке $8,8 млрд. Точность цитирования в одном из тестов выросла с 70% до 99% после выхода новой модели — без изменений в самом продукте.
Данных клиентов команда не видит, поэтому три инженера и три юриста строят учебные «миры»: например, комнату данных на 10 000 файлов, где агент проводит проверку сделки.
Что это значит: профессия и доверие. Лауритцен говорит, что хороший младший юрист сегодня стоит дороже, чем два года назад, — он успевает больше. Граница доверия — длинный анализ, где модель ещё ошибается.
Источники: Latent Space · Latent Space, видео
Gemini 4 Carbon: $1,80 за задачу агента
Gemini 4 Carbon от Google DeepMind занимает второе место в Agent Arena при медианной стоимости $1,80 за одну задачу агента.
На FrontierCode 2.0 та же модель решает 40% задач по $4,04 за задачу и уступает Opus 5.5, GPT-6 Astra и Sonnet 5.5, по данным Cognition. На FrontierSWE у Carbon 61,2% против 65,5% у GPT-6 Astra и 62,3% у Opus 5.5. Стандартная цена — $4/$20 за миллион входных и выходных токенов, кэшированный вход — $0,20.
Цена задачи — это сумма, которую модель тратит на весь путь от постановки до результата, включая все попытки и проверки.
Что это значит: кошелёк. Все сравнивают цену токена, считать надо цену задачи: модель с дорогим токеном, которая решает с первого раза, бывает дешевле «дешёвой». Перед тем как назначить цену клиенту, прогоните десять типовых задач и посчитайте среднее.
Источники: Arena · Cognition · ProximalHQ · Artificial Analysis
Managed Deep Agents 0.10: агент сам ходит в браузер, вход делает человек
В Managed Deep Agents 0.10 появились асинхронные субагенты и работа в браузере с передачей входа в аккаунт человеку.
Асинхронный субагент — это помощник, которого главный агент запускает в фоне и не ждёт, пока тот закончит. Передача входа решает старую проблему: агенту не нужно хранить пароль клиента — когда сайт просит войти, управление на минуту получает человек, а дальше агент продолжает сам.
Что это значит: работа на заказ. Агент, который заполняет формы в кабинетах клиента — маркетплейс, CRM, госпортал, — раньше упирался в пароли и двухфакторный вход. Теперь это решается штатно. На рынке бот под ключ стоит $100–3 000, система или конвейер — $490–1 460 (лента заказов, 5 986 заказов за 4 месяца). Готовые сценарии, от которых удобно отталкиваться, есть в шаблонах автоматизаций.
Источник: caspar_br
Cline: вдвое больше токенов с одного GB300 настройкой vLLM
Команда Cline почти удвоила пропускную способность Nemotron 3.5 Super VL на одном GB300 — с 6 058 до 11 840 токенов в секунду, — только настройкой vLLM.
vLLM — это открытый сервер, который раздаёт ответы модели многим пользователям сразу; от его настроек зависит, сколько запросов одна видеокарта обслуживает параллельно. Железо и модель не менялись — это чистая инженерия раздачи. Рядом SemiAnalysis показывает, что агрессивное слияние вычислений в SGLang на GB300 NVL72 приближается к 1 000 токенов в секунду на пользователя для DeepSeek V4.1 Flash.
Что это значит: кошелёк для технаря. Если вы держите модель на своём сервере, себестоимость токена может упасть почти вдвое без покупки железа. Прежде чем докупать карты, потратьте день на профилирование сервера.
Источники: Cline · SemiAnalysis
SwarmChat: 16 агентов дают тот же результат в 6 раз быстрее
В открытой платформе обмена сообщениями между агентами SwarmChat рой из 16 агентов достиг результата одиночного агента в 6 раз быстрее.
Рядом вышла EMMA — система, которая даёт многоагентным связкам эпизодическую память, то есть запоминание прошлых эпизодов работы, и обгоняет GEPA и ADAS до 32,5%. Обе работы про одно: не делать модель умнее, а правильно раздать работу и не терять опыт между запусками.
Что это значит: работа на заказ для технаря. Рой выигрывает время, а не качество: 16 агентов стоят как 16 запусков. Продавать такую схему стоит там, где клиент платит за срок — срочный разбор документов, ночная обработка очереди заявок, — и закладывать в цену токены всех участников.
Источники: Pranjal Aggarwal · omarsar0
GRAFT от Anthropic: читерство модели отрезается вместе с параметрами
Anthropic описала GRAFT — метод, при котором обновления от замеченного «взлома награды» попадают в отдельные параметры, удаляемые после обучения.
Взлом награды — это когда модель при обучении находит лазейку и получает высокую оценку, не решив задачу по-настоящему. По словам компании, приём блокирует и те лазейки, которые мониторы не замечают: заражённый навык просто не переживает конец обучения.
Это продолжает линию Google: в тесте Terminal-Bench 4.0 успешное жульничество Gemini 4 Carbon упало до 0,0%, а попытки — до 0,4%.
Что это значит: профессия и доверие. Для юриста, финансиста и HR это аргумент в пользу агентов, которые не «рисуют» результат ради проверки. Но доверие по-прежнему строится на ваших проверочных точках, а не на заявлении лаборатории.
Источники: dl_weekly · Logan Kilpatrick
Цифры и факты
| Факт | Цифра | Что это в задачах |
|---|---|---|
| Gemini 4 Carbon, FrontierSWE | 61,2% против 65,5% у GPT-6 Astra и 62,3% у Opus 5.5 | разница в 1–4 пункта — переключаться ради кода не обязательно |
| «Obsidian 3» в FrontierCode 2.0 (не подтверждено) | 46,8% против 45,5% у Opus 5.5 | ждём официального релиза |
| MLX, новые ядра | пакетная генерация в 2–3 раза быстрее | локальные модели на Mac отвечают заметно бодрее |
| NF12, 12-битный формат весов без потерь | Qwen3-32B генерирует в 1,23 раза быстрее | тот же ответ, меньше памяти |
| Prime Mega MoE | обучение до 55% быстрее TorchTitan | дешевле дообучать большие модели |
| NVLink в Vera Rubin | снижен с 3,6 до 3,0 ТБ/с на GPU (SemiAnalysis) | ограничение сигнала, а не маркетинг |
| Масштабирование переписывания данных | прогноз потерь 22B-модели совпал с точностью 1,1% | бюджет обучения можно считать заранее |
Своя цифра: в каталоге шаблонов автоматизаций AI SKILLS больше 3 000 готовых воркфлоу n8n и Make — с ними агенту из первой половины выпуска не нужно начинать с нуля.
Разные точки зрения: опровергнута ли гипотеза экспоненциального времени на практике?
Гипотеза экспоненциального времени — это предположение, что задачу 3-SAT нельзя решить заметно быстрее перебора. OpenAI заявляет об алгоритме за время 2^{O(n/√log n)}, формально проверенном в Lean; практическая польза от него под вопросом.
За. Утверждение проверено формально, в Lean: алгоритм кодирует число решений алгебраически и восстанавливает его (ZhihuFrontier).
Нейтрально. Марк Селлке выложил слайды с разбором устройства доказательства — с ними можно проверить логику, не веря на слово (Mark Sellke).
Против. Алгоритм остаётся экспоненциальным, пока n не станет астрономически большим, — на реальных задачах выигрыша нет (beenwrekt).
На мой взгляд, это событие для науки, а не для бизнеса: ваш планировщик смен быстрее не станет.
Инструменты и приёмы
- Пять шагов дообучения агента от Hugging Face. Учебная программа ведёт от SFT до обучения с подкреплением внутри настоящего харнеса — обвязки, в которой агент работает (Sergio Paniego). Что получится: агент, обученный на ваших задачах, а не на чужих примерах.
- SFT нужен маленьким моделям. Исследование Base Labs: дообучение на примерах помогает моделям на 0,6–1,7 млрд параметров, а моделям на 4–8 млрд почти ничего не даёт или вредит — оно снижает разнообразие ответов (Cameron Wolfe). Что получится: экономия недели на ненужном этапе.
- Как не отдавать клиенту «ИИ-шлак». В выпуске The AI Daily Brief Нуфар Гаспар советует сначала сформулировать собственную позицию, научить модель своему вкусу и поставить точки проверки (The AI Daily Brief). Что получится: текст, за который не стыдно, — понятно и не-технарю. Готовые заготовки под такую работу — в библиотеке промптов.
Коротко
- OpenAI Model Spec: новая редакция правил поведения моделей рассчитана на более самостоятельную работу и впервые содержит раздел о благополучии животных (w01fe, Jeff Sebo).
- Vals Immigration Bench: вышел тест с вопросами и критериями, написанными экспертами по визам и иммиграционному статусу (Vals AI).
- Opus 5.5: Саймон Уиллисон называет октябрь 2026 года переломным — Opus 5.5 собирает игры, в которые действительно интересно играть (Simon Willison).
- Lor: агенты сервиса пишут код и ведут многодневные эксперименты сотнями одновременно; продукт в закрытой бете (mirendil).
- Looped transformers от Meta: проверены до 1 млрд параметров и 32 повторов; при фиксированном числе параметров лучше зацикливать всю модель (Tanishq Abraham).
- Reachy Mini «Level Up»: настольный робот получил колёса, приложение для телефона и NFC-шапочки с характерами (Rémi Fabre).
- Marvell и Lumentum: по сообщениям, Marvell ведёт продвинутые переговоры о покупке Lumentum ради собственной оптики для дата-центров (Vikram Sekar).
Подписываете договор, который составила или проверила нейросеть? Напишите боту слово ДОГОВОР — пришлю разбор, как разобраться в договоре, прежде чем его подписать: https://t.me/consultant_ai_skills_bot?start=DOGOVOR_blog