90 PR в ASP.NET Core за $230 на Opus 5.5 — AI-дайджест
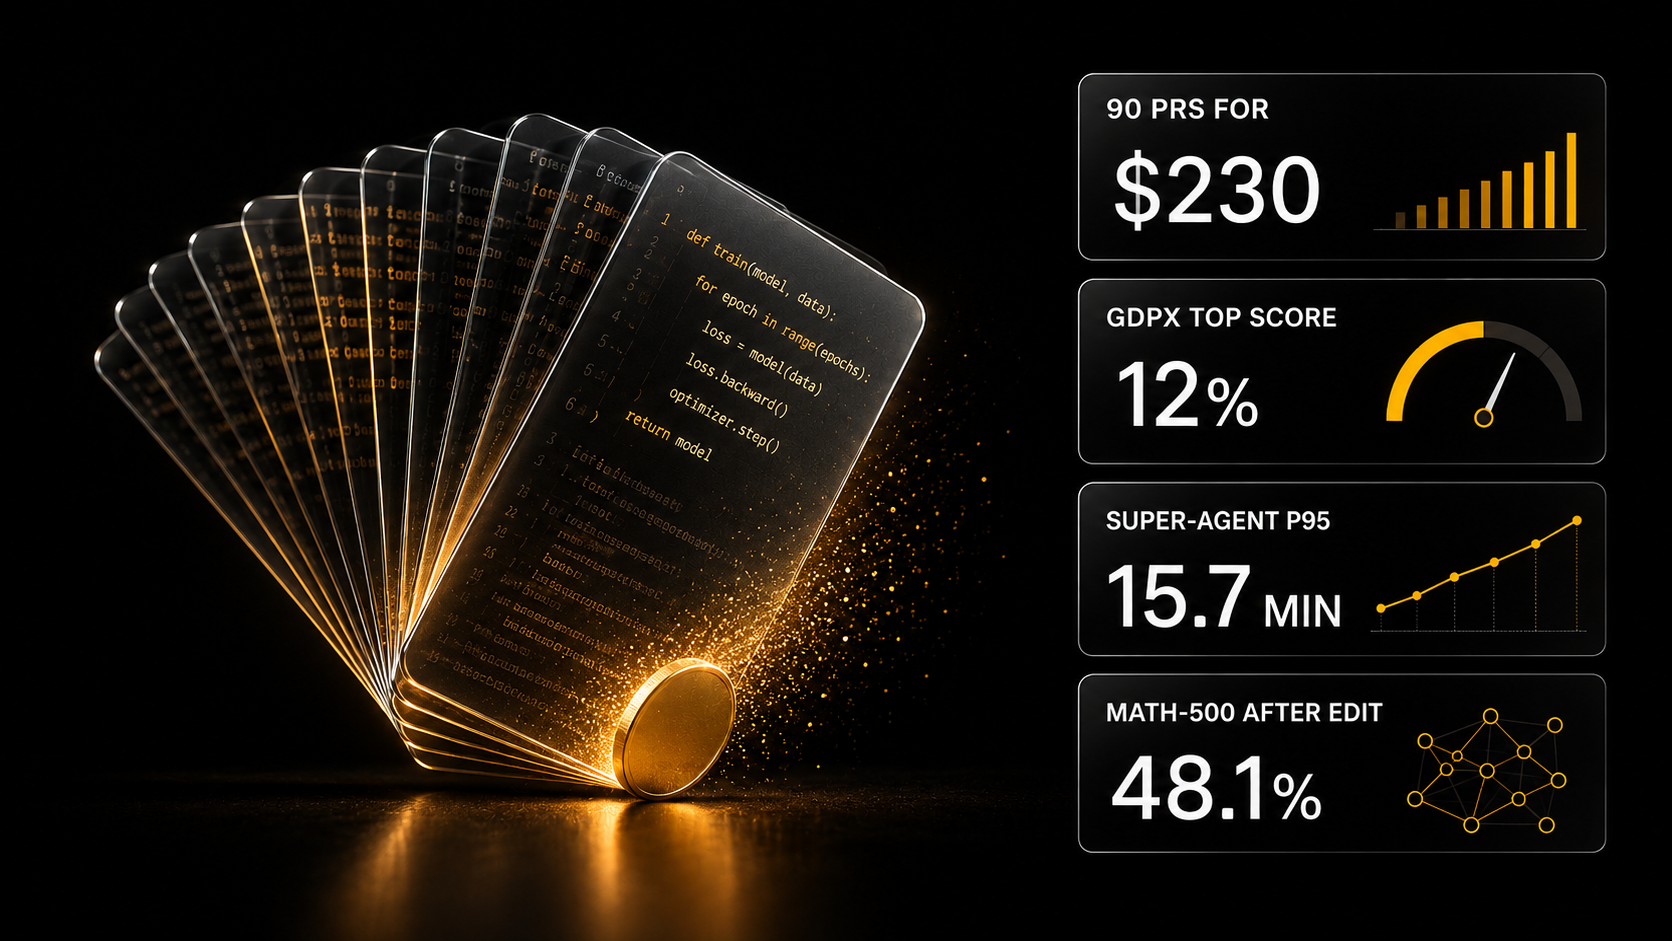
Агент на Opus 5.5 сделал около 90 правок кода для ASP.NET Core за $230 — примерно $2,6 за правку. В бенчмарке GDPx лучшая модель решает лишь 12% экономических задач, а DeepSeek открыла схему суперагента.
Главное для вас сегодня: агент на Opus 5.5 закрыл около 90 задач по коду за $230, то есть примерно по $2,6 за задачу, — себестоимость технической работы снова упала, а вот самые сложные задачи в экономике модели по-прежнему решают только в 12% случаев. Продавать стоит результат и проверку, а не время.
Главное сегодня
Opus 5.5 и облачные агенты GitHub: около 90 PR в ASP.NET Core за $230
Дэвид Фаулер за один день получил около 90 pull-реквестов с ускорениями для ASP.NET Core, запустив новые облачные агенты GitHub на Claude Opus 5.5; токены обошлись примерно в $230.
Я посчитал: $230 на 90 правок — около $2,6 за одну. ASP.NET Core — веб-фреймворк Microsoft с открытым кодом, то есть это не учебный проект, а большая кодовая база с ревью. Pull-реквест — это предложенная правка кода, которую человек проверяет и принимает или отклоняет.
Что это значит: работа на заказ. Себестоимость правки агентом — единицы долларов, а медиана разовой работы на рынке — около $60 (лента заказов, 5 986 заказов за 4 месяца, наш прайс-лист). Деньги остаются в постановке задачи и в проверке: 90 правок кто-то должен прочитать, прежде чем их примут.
Источники: Дэвид Фаулер
Карпатый: сервис из 43 млн комментариев Hacker News за 2 часа
Андрей Карпатый собрал HackerTube — каталог из 6 454 видео, которые за 20 лет чаще всего советовали в 43 млн комментариев Hacker News; Claude отфильтровал комментарии, а на всю сборку ушло около 2 часов.
Работал он в Claude Code desktop на Opus 5.5 со средним уровнем усилий (Medium effort), и в эти 2 часа вошли защита сервера VPS и развёртывание. Средний уровень по умолчанию снова поднял спор, когда стоит включать более дорогие режимы (Yuchen Jin, swyx). DAIR сразу сделала такую же подборку для научных статей — больше 1 000 работ.
Что это значит: работа на заказ. «Собрать из большого архива полезную витрину» — понятная клиенту услуга: на рынке многостраничный сайт у новичка стоит $245–730. Время сборки ушло в часы; продаётся идея, какие данные отобрать и для кого.
Источники: Андрей Карпатый · DAIR, Hacker Papers
Локальные модели против Claude на 9 реальных багах: 0,50 против 0,74
В независимом тесте на 9 закрытых задачах по исправлению багов в C++/CUDA лучшая локальная модель, Qwen3.8-Flash-Next в формате NVFP4, набрала 0,50 балла против 0,74 у Claude Opus 5.5 и 0,58 у Claude Sonnet 5.5.
То есть локальная модель даёт примерно две трети результата Opus 5.5. Квантизация — это сжатие весов модели до меньшего числа бит, чтобы она поместилась на домашнюю видеокарту. В этом маленьком тесте сжатие почти не снизило точность, но у Qwen3.8-27B в 3-битной версии на задачу уходило в 1,4 раза больше токенов, поэтому скорость в токенах в секунду обманчива — считать надо исправленные баги в минуту.
Что это значит: бизнес. Если код или документы нельзя отдавать в облако, локальная модель уже закрывает заметную часть задач — но не наравне с Opus. Про выбор модели под свои данные — в гайде по открытым LLM.
Источники: r/LocalLLaMA, тест на 9 багах
GDPx от SemiAnalysis: лучшая модель решает 12% задач из экономики
SemiAnalysis выпустила бенчмарк GDPx — 206 задач для агентов из 11 экономически ценных областей, включая проектирование чипов, разработку, финансы и биологию; лучший результат — 12% у Claude Opus 5.5.
Gemini 4 Carbon набрала 10,9% и, по разбору kimmonismus, обходится примерно в 4 раза дешевле. Аналитик Эли Бакуш показал, что если убрать задачи, где модели упираются в защитные ограничения, картина меняется, а Sol 6.1 становится ещё дешевле. Бенчмарк закрытый, и его проверка стоит дорого — это отмечают и критики.
Что это значит: профессия и доверие. Для финансиста, инженера или биолога это ответ на вопрос «заменит ли меня агент»: на длинных профессиональных задачах — пока нет, 88% задач лучшая модель не решает. Агент ускоряет куски работы, а за итог по-прежнему отвечает специалист.
Источники: SemiAnalysis · kimmonismus · Эли Бакуш
DeepSeek открыла прототип суперагента: p95 с 29,5 до 15,7 минуты
DeepSeek опубликовала статью и репозиторий dsh-superagent-prototype — харнес, в котором одна долгоживущая сессия-диспетчер общается с человеком и раздаёт работу изолированным исполнителям; по собственному тесту компании, время выполнения 95% задач сократилось с 29,5 до 15,7 минуты.
Харнес — это обвязка вокруг модели: инструменты, память, правила и порядок работы; на бытовом языке — кухня вокруг повара. Исполнители работают параллельно и запускаются событиями GitHub. Сравнение шло с одной сессией, которая сама вызывает субагентов. Рецензент проекта Цуй Тяньи пишет, что «Super» значит «слой над агентом», а не «сверхинтеллект», и перечисляет пробелы: нет долгой памяти между сессиями, безопасность не проверена, тест шёл во внутренней доверенной среде.
Что это значит: для технаря — готовая схема «диспетчер плюс исполнители». Как собрать её на n8n для рабочего чата, мы разбирали в мастер-классе по схеме суперагента DeepSeek.
Источники: DeepSeek Harness · kimmonismus · Zhihu Frontier
DeepSeek-V4.1-Flash-1017 на 1 бит: 72 ГБ вместо 138 ГБ
Лаборатория ISTA DAS Lab выпустила кодинговую сборку DeepSeek-V4.1-Flash-1017 на 763 млрд параметров при 1,05 бита на параметр: веса трансформера занимают 72,1 ГБ против 138,2 ГБ у прежней сжатой версии.
Половина экспертов в каждом слое отрезана, остальные сжаты. Модель сохранила 98,7% результата на LiveCodeBench v6 (88,57 против 89,71) и 94,8% на SWE-bench Verified (77,00 против 81,20). Общие веса Engram добавляют ещё 110,6 ГБ. Параллельно энтузиаст пропатчил движок Strata: на игровой видеокарте RX 9070 XT с 16 ГБ и 64 ГБ памяти новая сессия агента на DeepSeek V4.1 Flash стартует за 5 секунд вместо 100.
Что это значит: кошелёк. Модель уровня облачных переезжает на домашнее железо, но комментаторы справедливо спрашивают, зачем 763 млрд параметров, если Qwen3.8-27B по их данным даёт 90,3 на LiveCodeBench.
Источники: r/LocalLLaMA, ISTA · Hugging Face · r/LocalLLaMA, Strata
Weight-Space Programming: правка 0,016% весов подняла MATH-500 с 7,9% до 48,1%
Исследователи MIT CSAIL показали, что передовые модели могут читать и править веса небольших нейросетей по заданию на естественном языке, без обучения градиентным спуском; правка 131 072 весов (около 0,016%) у Qwen3.5-0.8B подняла результат на MATH-500 с 7,9% до 48,1%.
В других опытах модель по сырым весам определяла поведение маленьких сетей, писала с нуля сети для простых игр и чинила сломанную политику управления, меняя 3,5% весов. Скептики на r/LocalLLaMA указывают: низкая исходная цифра объясняется тем, что модель зацикливалась и упиралась в лимит токенов (93% таких сбоев до правки, 33% после), а на Gemma 3 270M без этой проблемы приём не сработал.
Что это значит: для технаря — новый инструмент разбора моделей, а не способ «дообучить без данных». Я бы пока ждал независимых повторов на более сложных задачах.
Источники: Takehi и соавторы · r/LocalLLaMA, обсуждение · r/LocalLLaMA, критика MATH-500
Цифры и факты
| Цифра | Что это | Что это в задачах |
|---|---|---|
| 159 | индекс Epoch у DeepSeek V4.1F-1017 — столько же, сколько у GPT 5.5; на 10 пунктов выше V4-Pro (teortaxesTex) | открытая модель держится на уровне прошлого флагмана OpenAI |
| 36 часов и около $2 000 | столько потратил Devin, чтобы перенести модель на дешёвые чипы Trainium (Nader Dabit) | перенос инфраструктуры — уже задача на выходные для агента |
| В 30 раз | дешевле обошлась та же работа на GLM 5.3-Flash, чем на Grok 4.7; без сжатия контекста на 200 тыс. токенов эффективность выросла до 23% (evalstate) | цена задачи важнее цены токена |
| $5,75 в час | аренда одного GPU B300 в кластере из 128 штук (teortaxesTex) | окупаемость своего железа — около года даже при выручке уровня DeepSeek |
| Больше $5 млрд в год | годовой темп оборота через OpenRouter, который даёт Opus (Deedy Das) | спрос на дорогую модель для агентов не падает |
| 15 релизов и 500 млрд токенов | столько Vals прогнала через оценки за октябрь 2026 года (nikilravi) | раз в два дня выходит модель, которую стоит проверить |
| 10 696 | активных скиллов для Claude Code в каталоге AI SKILLS по замеру 3 ноября 2026 года | готовые навыки для агентов из этого выпуска — в каталоге скиллов |
Разные точки зрения: нужен ли агенту один долгоживущий «диспетчер»?
Схема DeepSeek — одна сессия-диспетчер и параллельные исполнители — по собственному тесту компании почти вдвое сократила время 95% задач (с 29,5 до 15,7 минуты). Спор идёт о том, общий ли это рецепт или костыль под конкретную модель.
- За. Автор агента pi пишет, что схема совпадает с тем, куда идёт Earendil: одна долгоживущая сущность, рекурсивное делегирование и запуск от внешних событий (badlogicgames). Исследователь DAIR называет статью мастер-классом по дизайну харнеса (omarsar0).
- Нейтрально. Рецензент Цуй Тяньи признаёт, что похожие архитектуры другие команды пробовали раньше, и пишет, что DeepSeek собирается поддерживать pi и другие крупные харнесы в каждом поколении моделей (tianyi).
- Против. teortaxesTex называет статью «довольно сумбурной» и считает, что DeepSeek строит внутренние костыли под слабости модели, например галлюцинации, вместо общей надёжности системы (teortaxesTex).
Инструменты и приёмы
- Извлечение данных из документов дешевле флагманов. LlamaIndex выпустила режим Extract Max Effort и заявляет, что он точнее вытаскивает данные из документов, чем Astra и Opus на максимальных настройках, и стоит дешевле (Джерри Лю). Что получится: счета, договоры и анкеты превращаются в таблицу без ручного переноса.
- Права агента — только на одобренный план. Vercel выдаёт агенту токены лишь с теми правами, которые указаны в одобренном плане (Deep Learning Weekly). Что получится: агент с доступом к рабочим системам не сделает ничего сверх согласованного.
- 3D-объекты для игр от модели на 4 млрд параметров. GLB-3D-Coder пишет сцены Three.js с экспортом в GLB для Godot и других движков, 25 категорий объектов (r/LocalLLaMA, Hugging Face). Что получится: заготовки персонажей, оружия и построек для прототипа игры на своём компьютере.
Коротко
- Qwen 4.0 и Qwen 5.0 останутся открытыми: руководитель Qwen подтвердил открытые веса; у команды больше 460 открытых моделей и больше 3 млрд скачиваний (r/LocalLLaMA).
- Mythos 5.5: название нашли в коде сайта Anthropic с описанием «самый способный класс моделей для кибербезопасности и биологии»; официального анонса нет (kimmonismus).
- GPT-6.2 Astra: по неподтверждённым данным, модель уже видна в аналитике использования Codex, выход ожидают скоро (kimmonismus).
- Memdoor: команда из 5 моделей Qwen3.8-27B с ролями планировщика, двух генераторов идей, решателя и менеджера обошла Fable 5 на LiveCodeBench Hard (r/LocalLLaMA).
- MiniMax M3.1 Flash на 428 млрд параметров: Unsloth выпустила 2-битные версии GGUF на 143,9 ГБ (MiniMax).
- FineDNA: Hugging Face открыла больше 300 млрд токенов геномных данных и модель Carbon-X — сильнейшую открытую модель на задачах с ДНК (Льюис Танстолл).
- JEPA Лекуна и Балестриеро: сопоставление картинок и текста при в 42 раза меньшем числе примеров — 21,6 млн против 900 млн (heyshrutimishra).
- Sakana Sawara: японская Sakana AI объявила собственную языковую модель, версия Sawara Small запланирована на весну 2027 года (hardmaru).
- Техас и дата-центры: по оценке SemiAnalysis, мощности на 2027 год уже распределены, а заморозка разрешений в Техасе — главный риск стройки 2028 года (SemiAnalysis).
- Производительность в США: Джон Бёрн-Мёрдок показывает, что рост начался раньше ИИ и есть только в США, поэтому на эффект ИИ он не похож (John Burn-Murdoch).
Сколько брать за работу, которую агент делает за $2,6? Напишите боту слово ПРАЙС — пришлю прайс-лист исполнителя на ИИ: девять видов работ и вилку по каждому: https://t.me/consultant_ai_skills_bot?start=PRAIS_blog