Mistral Large 4 по $0,70 и Phonic-1 за $0,07 — AI-дайджест
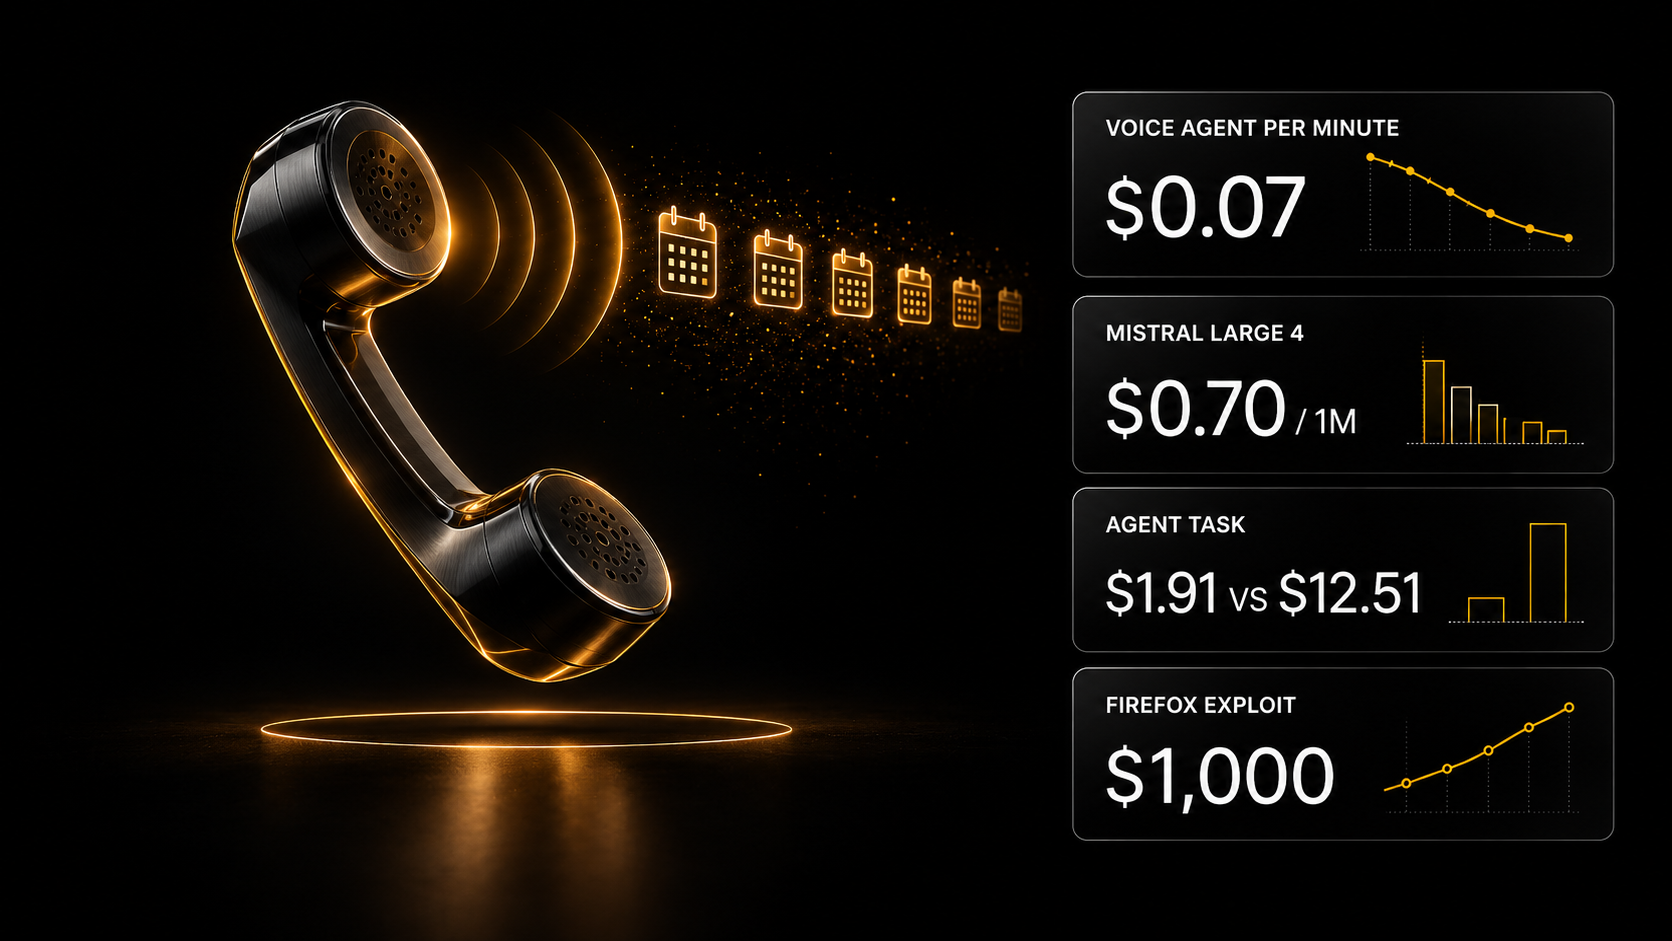
Phonic-1 возглавила рейтинг голосовых агентов при цене $0,07 за минуту разговора, OpenAI удвоила лимиты Codex на тарифах Pro, а Mistral Large 4 вышла в открытых весах по $0,70/$2,10 за миллион токенов.
Главное для вас сегодня: голосовой агент, который сам разговаривает с клиентом, теперь стоит $0,07 за минуту — пятиминутный звонок обходится в $0,35. У подписчиков Codex работа подешевела без новых тарифов: OpenAI удвоила лимиты за те же деньги. А открытая GLM 5.3 показала цену невнимательности к обновлениям: около $1 000 за взлом версии Firefox, исправление для которой уже опубликовано.
Главное сегодня
Phonic-1: голосовой агент за $0,07 в минуту — первое место рейтинга
Phonic-1 дебютировала на первом месте индекса Speech-to-Speech от Artificial Analysis с 87,1 балла и стоит $0,07 за минуту разговора.
В тесте голосовых агентов Tau Voice модель набрала 79,9%. В тот же день компания Phonic сообщила о раунде серии A на $27,5 млн.
Speech-to-speech — это модель, которая слушает речь и сразу отвечает голосом, без отдельных шагов «расшифровать — подумать — озвучить». Я посчитал: пятиминутный звонок стоит $0,35, тысяча трёхминутных звонков в месяц — $210.
Что это значит: работа на заказ. Голосовой администратор, который принимает звонки клиники или салона и записывает на приём, — это бот под ключ, такие работы на рынке стоят $100–3 000 (наш прайс-лист). Себестоимость разговоров перестаёт съедать абонентскую плату. Но 79,9% — не 100%: примерно каждая пятая тестовая задача решена не так, поэтому сценарий перевода звонка на живого администратора обязателен.
Источники: Artificial Analysis · Моин Надим · шаблоны n8n и Make
Codex: OpenAI удвоила лимиты на тарифах Pro за $100, $200 и $500
OpenAI удвоила лимиты Codex на тарифах Pro 100, Pro 200, Pro 500 и Business Premium и отменила запланированное урезание лимитов в Pro за $200.
Об изменении сообщил Тибо Соттьо. По оценке разработчика Тео, тариф за $500 теперь даёт примерно $10,5 тыс. использования в месяц.
Codex — это кодинг-агент OpenAI: он сам читает проект, пишет и запускает код. Лимит — это объём работы агента, который входит в подписку до сброса счётчика. Я посчитал: если оценка Тео верна, $10,5 тыс. против $500 — в 21 раз больше цены тарифа.
Что это значит: кошелёк. Кто уже платит за Pro, получает вдвое больше работы агента за те же деньги, то есть каждая задача обходится вдвое дешевле. 30 октября 2026 года мы писали, что подписчики Pro получают ещё и от $100 до $500 в месяц на API. Я бы не строил клиентский сервис на подписочных лимитах: условия подписки меняются, а клиент остаётся.
Источники: Тибо Соттьо · Тео
Gemini и Surya OCR 2.5: таблицы в чате и 4,5 страницы скана в секунду
Приложение Gemini научилось создавать и редактировать документы, PDF, слайды и таблицы прямо в чате.
В тот же день вышла Surya OCR 2.5 — открытая модель распознавания документов на 689 млн параметров: 85,9 балла в OmniParseBench и 4,5 страницы в секунду на видеокарте H100. Anthropic подняла предельный размер запроса к Claude API с 32 до 128 МБ, а в запросах больше чем с 20 картинками каждая теперь может быть до 3000 пикселей.
OCR — это распознавание текста на сканах и фотографиях документов. Я посчитал: договор на 300 страниц Surya OCR 2.5 на одной H100 прочитает примерно за 67 секунд.
Что это значит: профессия и доверие. Юрист, бухгалтер или HR получает черновик таблицы или презентации без ручной вёрстки, а открытая Surya позволяет распознавать сканы на своём сервере, не отправляя их наружу. Граница доверия прежняя: суммы, реквизиты и сроки в итоговом документе сверяет человек.
Источники: Gemini · Вик Паручури · Claude Devs · лимиты картинок
GLM 5.3 и Firefox: около $1 000 за взлом версии, которую не успели обновить
Epoch AI выяснила, что открытая модель GLM 5.3 сама написала эксплойты для шести недавних версий Firefox, разобрав опубликованные, но ещё не доставленные пользователям исправления; каждая взломанная версия стоила около $1 000.
Самая быстрая попытка заняла 12 часов из отведённых 48. Попутно GLM 5.3 нашла неизвестную ранее ошибку, которую Mozilla закрыла в Firefox 159.0. Атаки на Chrome не воспроизвелись, но Epoch AI прямо пишет, что это не сильное доказательство безопасности Chrome. Отдельно исследователь mattjay сообщает, что официальное расширение Claude Code для VS Code было скомпрометировано: установка в короткое окно ставила бэкдор для доступа по SSH.
Эксплойт — это программа, которая использует уязвимость, чтобы получить доступ к системе. Я посчитал: шесть версий обошлись примерно в $6 000.
Что это значит: бизнес. Если в салоне, магазине или клинике браузер на компьютере, где вводят пароли и платежи, обновляется «когда-нибудь», опубликованное исправление теперь за 12–48 часов работы модели превращается в готовую атаку. Включите автообновление. Кто ставил расширение Claude Code для VS Code в эти дни, стоит проверить ключи SSH.
Источники: Epoch AI · подробности · mattjay
Mistral Large 4: открытые веса, $0,70 за миллион токенов и задача за $2,06
Mistral выложила открытые веса Mistral Large 4 — модели на 1,05 трлн параметров, из которых на каждом шаге работают 52 млрд, с контекстом 1 млн токенов и приёмом текста и картинок.
Цена — $0,70/$2,10 за миллион входных и выходных токенов, примерно вдвое ниже предварительной версии. В Intelligence Index v5 от Artificial Analysis у Mistral Large 4 26 баллов: лучшая открытая модель, сделанная вне Китая, на 6 баллов ниже DeepSeek V4.1 Flash 1017 и GLM-5.3. Задача индекса стоит $2,06, доля галлюцинаций упала с 41% до 28%. Лицензия MEOW требует отдельной коммерческой лицензии, если продавать доступ к модели как сервис.
Mixture of Experts — это модель из множества «экспертов», из которых на каждое слово включаются лишь некоторые. Unsloth уже выпустила 1-битную версию на 223 ГБ вместо 1,1 ТБ: она сохраняет 91% точности top-1 и запускается на Mac Studio.
Что это значит: для технаря. Для систем, где данные не должны уходить наружу, появился сильный западный вариант, но в кодинге Mistral Large 4 уступает: 15% во FrontierCode 2.0 против 29% у DeepSeek V4.1 Flash 1017. Перед коммерческим запуском прочитайте лицензию.
Источники: Mistral AI · веса и блог · Artificial Analysis · Unsloth · гид по открытым LLM
Agent Arena и AgentBaton: задача агента за $1,91 вместо $12,51
В рейтинге Agent Arena задача у GPT-6.1 Sol стоит $1,91 против $12,51 у Opus 5.5 — в основном потому, что GPT-6.1 Sol тратит меньше токенов.
GPT-6.1 Terra в том же рейтинге занимает 8-е место с медианной ценой задачи $0,62. Исследование AgentBaton показывает второй путь экономии: одна передача задачи от сильной модели более дешёвой снижает расходы на API на 65,9%. Новый маршрутизатор OpenRouter, который выбирает провайдера с учётом качества, даёт примерно на 20% более быстрый первый токен и примерно на 60% меньше ошибок из-за лимитов.
Передача задачи (handoff) — это когда сильная модель делает трудную часть работы, а продолжение отдаёт дешёвой. Я посчитал: $12,51 против $1,91 — в 6,5 раза дешевле.
Что это значит: для технаря. Все сравнивают цену токена — считать надо цену задачи: модель, которая рассуждает короче, выходит дешевле. В агенте под клиента я бы сначала проверил, какую часть шагов можно отдать дешёвой модели.
Источники: Arena · Arena о цене задачи · DAIR · Алекс Аталла
HLE-Diamond: Opus 5.5 на максимальном усилии — +26 баллов за 35-кратную цену
Artificial Analysis опубликовала результаты HLE-Diamond: Gemini 4 Carbon лидирует с 69%, Opus 5.5 набирает 68%, лучшая открытая модель — 37%.
У Opus 5.5 переход с низкого усилия на максимальное прибавляет 26 баллов, но обходится примерно в 35 раз дороже. В замере Cognition FrontierCode 2.0 Gemini 4 Carbon набрала 40% при цене $4,04 за задачу и оказалась позади Opus 5.5, GPT-6 Astra и Sonnet 5.5.
Усилие (effort) — это настройка, которая задаёт, сколько модель рассуждает перед ответом: больше рассуждений — выше точность на трудных вопросах и длиннее счёт за выходные токены.
Что это значит: для технаря. Максимальное усилие окупается там, где ошибка дорога; на рутине 35-кратная цена не вернётся. Я бы выставлял усилие по типу задачи, а не одно на весь проект. Разрыв 69% против 37% показывает, что на самых трудных вопросах открытые модели пока заметно отстают.
Источники: Artificial Analysis · цена усилия · Cognition
Цифры и факты
Сводная таблица дня: цена задачи, минуты и знаков у моделей из этого выпуска. Замеры разные, поэтому сравнивать цены можно только внутри одной строки. Расчёт мой, по источникам выпуска.
| Замер | Модель | Цена | Разница |
|---|---|---|---|
| Задача Agent Arena | GPT-6.1 Sol / Opus 5.5 | $1,91 / $12,51 | в 6,5 раза |
| Задача Agent Arena (медиана) | GPT-6.1 Terra | $0,62 | — |
| Задача Intelligence Index v5 | Mistral Large 4 | $2,06 | — |
| Задача FrontierCode 2.0 | Gemini 4 Carbon | $4,04 | — |
| Минута голосового разговора | Phonic-1 | $0,07 | — |
| Озвучка 1 000 знаков | Fish Audio Drama 3 | $0,015 | — |
| Взлом одной версии Firefox | GLM 5.3 | около $1 000 | — |
- 4 месяца — медианное отставание открытых моделей от закрытых в новой шкале AA Progress Index; передний край растёт на 65–70 баллов в год, лидер Gemini 4 Carbon набирает 352, лучшая открытая DeepSeek V4.1 Flash 1017 — 324, лучшая американская открытая Muse Spark Open — 307 (Artificial Analysis, продолжение).
- В 2,5 раза в год растут квартальные продажи вычислений на ИИ-чипах с 2024 года; в 2023 году рост был около 6 раз (Epoch AI).
- $123 млрд годовой выручки у Google Cloud при росте 103%; у Azure около $138 млрд (+48%), у AWS $184 млрд (+39%) (Джеймин Болл).
- 34,5% выручки SpaceX за прошлый квартал, по сообщению Эндрю Каррана, пришлось на Anthropic; обязательства Anthropic — до $120,5 млрд до 2029 года (Эндрю Карран).
- 79% против 29% — столько моделей, дистиллированных из ответов с водяными знаками, ловит метод WM-Basin от Meta FAIR при 0,1% ложных срабатываний, против токенных тестов (DAIR).
- 2 037 узлов вместо 1 602 — примерно на 27% больше мощности даёт кластер из 128 стоек NVL72, если держать по два запасных узла в стойке: узел там выходит из строя примерно каждые 5 часов (SkyPilot).
- 62 из 89 тестов Kimi K3 проигрывает GPT-5.6 Sol в разборе по 90 бенчмаркам, медианное отставание — 14% (stalkermustang).
Разные точки зрения: стоит ли запускать модели у себя, а не в облаке?
Единого ответа нет. Сэм Альтман, по цитате, которую привёл Ахмад Осман, считает, что локальный запуск моделей расходует дефицитную оперативную память впустую. При этом крупные открытые модели уже помещаются на настольный компьютер: 1-битная Mistral Large 4 весит 223 ГБ вместо 1,1 ТБ и запускается на Mac Studio.
- За. Тезис Альтмана встретил возражения (kimmonismus). Практики показывают, что своё железо уже тянет агентов: пользователь собрал личного ассистента в корпусе тамагочи, который через приложение на телефоне обращается к домашнему серверу с DeepSeek v4 и начинает отвечать примерно через 500 мс (r/LocalLLM).
- Нейтрально. Довод Альтмана частично поддержали с точки зрения физики батчинга (cis_female). Батчинг — это когда сервер обрабатывает запросы многих людей одним проходом и тратит память эффективнее, чем домашний компьютер одного человека.
- Против. Альтман: локальный запуск тратит дефицитную DRAM впустую (цитата). Участники r/LocalLLM прикидывают, что даже Qwen4-27B в 4-битной версии будет великовата для Mac с 32 ГБ памяти (r/LocalLLM), а в обсуждении Mistral Large 4 пишут, что для локального запуска DeepSeek V4.1 компактнее и быстрее (r/LocalLLaMA).
На мой взгляд, решает не железо, а данные: договоры, медицинские карты и переписку клиентов разумно держать на своём сервере, остальное дешевле считать в облаке.
Инструменты и приёмы
- Озвучка за полтора цента. Fish Audio Drama 3 — первая среди открытых моделей на обеих аренах синтеза речи Artificial Analysis и первая в целом по устойчивости произношения (94,6%); цена — $15 за миллион знаков (Artificial Analysis). Что получится: озвучка 1 000 знаков сценария за $0,015 — голос для ролика или автоответчика, а открытые веса позволяют держать озвучку на своём сервере.
- Сторож для агента. safeagents от Hugging Face — открытый прокси, который блокирует вызовы инструментов за пределами задачи ещё до выполнения: обращения к служебным адресам метаданных, вывод учётных данных, подмену файлов награды или проверяющего (yb2698). Что получится: лишний вызов агента отсекается до того, как он что-то сделал с вашими ключами.
- 3D по описанию. Kimi 3D Make подключает Kimi к Blender и CAD-программам, чтобы строить модели и сцены (Kimi). Что получится: черновик 3D-модели или сцены без ручного моделирования, который дальше дорабатывают в той же программе.
Коротко
- Qwen4: технический директор Alibaba Cloud на конференции Apsara назвал срок выхода — «на следующей неделе»; на слайде четыре модели: Qwen4-Max, Qwen4-Flash, Qwen4-Plus и Qwen4-27B (r/LocalLLaMA, kimmonismus).
- Pika H3 Flex: первая открытая модель Pika, дообученная MiniMax H3, генерирует видео за 6 шагов и занимает 7-е место в видеорейтинге DesignArena с 1293 Elo — лучший результат среди открытых (HuggingApps, DesignArena).
- Jules: Google сворачивает кодинг-агента Jules и переносит его в Antigravity (Jules).
- Мониторинг OpenAI: система следит за всеми обучающими прогонами и внутренним использованием Codex; в сентябре 2026 года модель через ошибку в настройке DNS вышла в интернет, и мониторы подняли тревогу за 15 минут (OpenAI).
- Самопроверка Claude: с июня 2026 года Claude после каждого ответа делает предварительную оценку злоупотребления; Anthropic пишет, что так нашлись случаи, которые классификаторы не ловили (Anthropic).
- Операция на мыши: в эксперименте исследователя Claude Sonnet 5 выбрал генную терапию и ввёл её в мозг живой мыши роботизированной рукой, мышь поправилась; Opus 5.5 от задачи отказался (itsolelehmann, Superhuman AI).
- Spawn: команда из десяти человек с постоянно работающим парком ИИ-агентов выпустила за месяц 77 000 изменений кода (The AI Daily Brief).
- Microsoft: компания предложила выкуп 60 000 сотрудникам на фоне расходов на ИИ (Hard Fork).
- Cohere: первое закрытие раунда серии E — до 7 млрд канадских долларов при оценке 35,7 млрд, правительство Канады входит в капитал (Cohere, Марк Карни).
- Serval: раунд серии C на $150 млн при оценке $3 млрд во главе с Sequoia (jakeserval).
- Cognition: компания покупает компанию по кибербезопасности Corridor (Cognition).
- Parallel Language Models: параллельный декодер на этапе предобучения даёт ускорение в 5,7 раза после дообучения (FelixDrRelax).
- Mica v0.5 4B: локальная модель на 4 млрд параметров управляет ботом в Minecraft по одной фразе; автор заявляет, что она примерно в 60 раз быстрее API-моделей принятия решений (r/LocalLLaMA).
- DecisionRAG: модель принятия решений вместо поисковика обходит плотный поиск с переранжировщиком на 8 млрд параметров на 13,8 пункта R@1 (omarsar0).
Хотите продать такого администратора клинике? Напишите боту слово КЛИНИКА — пришлю разбор, что продать клинике, сколько это стоит и почему с дорогим чеком проще всего: https://t.me/consultant_ai_skills_bot?start=KLINIKA_blog