Gemini 4 Carbon №1, час расшифровки за $0,12 — AI-дайджест
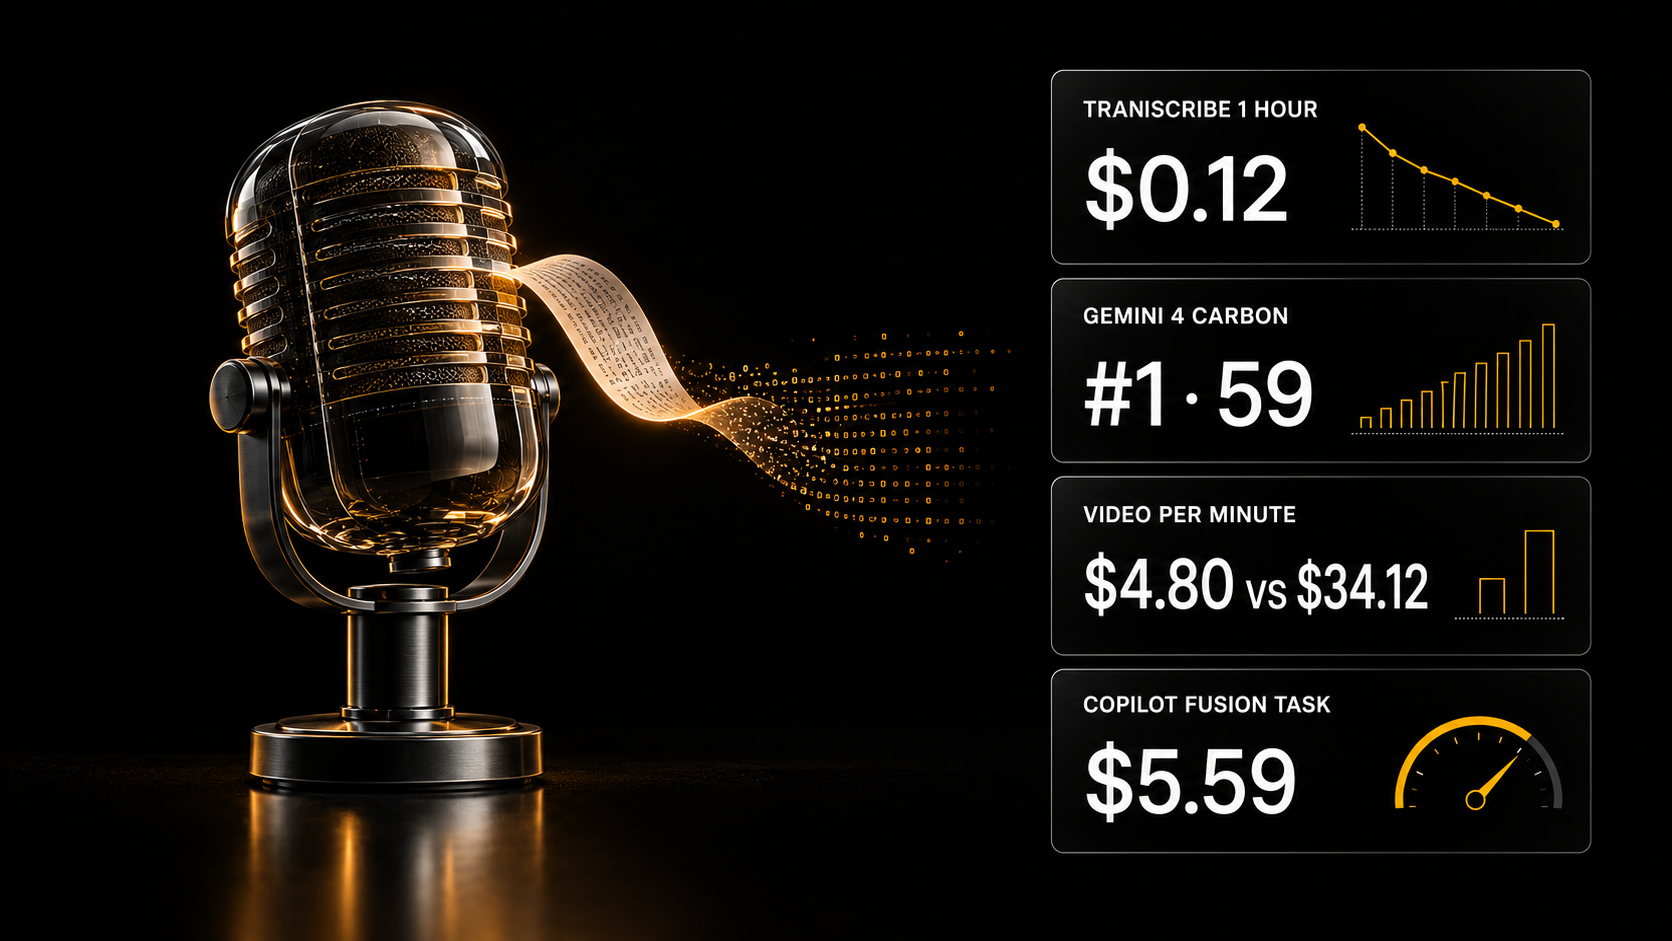
Gemini 4 Carbon вышла на первое место индекса Artificial Analysis, NVIDIA Nemotron 3.5 Transcribe расшифровывает час записи за $0,12, а 15-секундный ролик у открытой MiniMax H3 стоит $1,20 против $8,53 у лидера.
Главное для вас сегодня: себестоимость типовой ИИ-работы снова упала. Час записи открытая NVIDIA Nemotron 3.5 Transcribe расшифровывает за $0,12, а 15-секундный ролик из картинки у открытой MiniMax H3 стоит $1,20 против $8,53 у лидера рейтинга. Самая сильная модель дня, Gemini 4 Carbon, вышла на первое место независимого индекса, но пока доступна только специалистам по киберзащите.
Главное сегодня
NVIDIA Nemotron 3.5 Transcribe: расшифровка часа записи за $0,12
NVIDIA выпустила Nemotron 3.5 Transcribe — открытую модель распознавания речи на 40 языков, которая на DeepInfra стоит $2 за 1 000 минут аудио.
По замеру Artificial Analysis, у модели 2,8% по AA-WER — это общее первое место среди открытых моделей с Voxtral Small; на DeepInfra она работает в 75 раз быстрее реального времени. Модель также различает говорящих, переводит и отвечает на вопросы по записи. Внутри — 30 млрд параметров, из которых на каждом шаге работают около 4 млрд.
WER — это доля слов, которые модель распознала неверно: 2,8% означает примерно 3 ошибки на 100 слов. Я посчитал: $2 за 1 000 минут — это $0,002 за минуту, час записи обходится в $0,12.
Что это значит: бизнес. Клиника, салон или отдел продаж может расшифровывать все звонки и консультации почти бесплатно, а открытые веса позволяют держать записи на своём сервере. Разбор звонков, где теряются сделки, — это система, такие работы на рынке стоят $490–1 460 (наш прайс-лист). В каталоге AI SKILLS — 202 скилла из 10 692, в описании которых есть расшифровка или транскрибация.
Источники: NVIDIA · Artificial Analysis · гид по открытым LLM
Gemini 4 Carbon: первое место у Vals в финансах и юридических исследованиях
Google DeepMind представила Gemini 4 Carbon через две недели после Gemini 4 Argon, и в Intelligence Index v5 от Artificial Analysis модель вышла на первое место с 59 баллами.
Vals ставит Gemini 4 Carbon первой в своём финансовом индексе и в Legal Research Benchmark. Задача индекса Artificial Analysis обходится в $7,76 против $10,04 у Opus 5.5. Цена — $4/$20 за миллион входных и выходных токенов со стартовой скидкой 50% без срока. Пока модель получают только специалисты по киберзащите через программу Fairwind.
Галлюцинация — это уверенный ответ, которого нет в фактах. В тесте AA-Omniscience у Gemini 4 Carbon их доля выросла с 4% у Argon до 11% — второй результат среди измеренных; у Opus 5.5 и GPT-6 Astra — по 50%.
Что это значит: профессия и доверие. Юристу и финансисту стоит дождаться открытого доступа, но 11% — это примерно каждый девятый ответ: нормы и цифры проверять самому. По данным Vals, на финансовых и юридических задачах модель пишет на 64% больше текста, чем Argon, — счёт растёт вместе с ним.
Источники: Сундар Пичаи · Google AI · Artificial Analysis · Vals · Vals о токенах · Superhuman AI
AA-Video-I2V v2.1: минута видео у открытой MiniMax H3 — $4,80 против $34,12 у лидера
Artificial Analysis запустила рейтинг AA-Video-I2V v2.1 для видео из изображения: первое место у Seedance 2.5 по $34,12 за минуту, третье — у открытой MiniMax H3 по $4,80 за минуту.
Я посчитал: 15-секундный ролик у Seedance 2.5 обходится в $8,53, у MiniMax H3 — в $1,20, это в 7,1 раза дешевле. Открытые веса означают, что MiniMax H3 можно запускать на своём железе или у любого хостинга, а не только через сервис разработчика.
Видео из изображения — это когда нейросеть оживляет готовый кадр: фото товара, портрет персонажа, иллюстрацию. Качество кадра задаёт исходник, поэтому промпт пишется про движение и камеру, а не про внешний вид.
Что это значит: работа на заказ. Короткий ролик на рынке стоит $18–45. Три дубля 15 секунд на Seedance 2.5 съедают $25,59 — больше нижней границы рынка, на MiniMax H3 те же три дубля стоят $3,60. Я бы делал черновики на дешёвой модели, а финал — на лидере, если клиент платит за качество.
Источники: Artificial Analysis · генератор промптов для видео
OpenAI: подписчикам ChatGPT Pro — от $100 до $500 в месяц на API
OpenAI начала выдавать подписчикам ChatGPT Pro API-кредиты от $100 до $500 в месяц в зависимости от тарифа, а на тарифах Business — общий пул до $500 на рабочее пространство.
Кредиты забирает сам подписчик; разбивка по тарифам опубликована в отдельном сообщении OpenAI для разработчиков. В тот же день ChatGPT dot получил переписку текстовыми сообщениями — пока как предварительная версия для подписчиков Pro в США.
API-кредиты — это деньги на счёте разработчика: ими оплачиваются вызовы моделей из своих программ, ботов и автоматизаций, а не переписка в окне чата. По индексу Artificial Analysis, о котором мы писали 29 октября, задача у GPT-6.1 Terra стоит $0,96, то есть $100 хватает примерно на сотню таких задач в месяц.
Что это значит: кошелёк. Кто уже платит за Pro, получает бюджет на собственного бота или автоматизацию без отдельного счёта. Прежде чем строить на кредитах клиентский сервис, проверьте условия: подписка может поменяться, а клиент останется. Готовые сценарии — в шаблонах n8n и Make.
Источники: OpenAI Devs · тарифы · ChatGPT
GitHub Copilot Fusion: задача за $5,59 против $11,42 у Opus 5.5 в Claude Code
GitHub выпустила Copilot Fusion, который во время работы распределяет задачу между моделями Anthropic и OpenAI; по замеру Artificial Analysis одна задача обходится в $5,59 против $11,42 у Claude Code с Opus 5.5.
В индексе кодинг-агентов Artificial Analysis Copilot Fusion на 2 балла ниже этой связки, тратит 7,2 млн токенов на задачу и лидирует в Terminal-Bench 4.0 с 71 баллом. Сама GitHub заявляет до 77% экономии и на 40% более быстрые прогоны. Вместе с Fusion вышли автоматизации Copilot и Copilot Projects — проекты сразу на несколько репозиториев.
Оркестрация моделей — это когда одна система сама передаёт части задачи разным моделям. Я посчитал: $11,42 против $5,59 — в 2 раза дешевле ценой 2 баллов индекса.
Что это значит: для технаря. Все сравнивают модели — считать надо связку «модель плюс обвязка». Если команда платит за кодинг-агентов по факту, разница вдвое на задаче заметнее, чем 2 балла рейтинга.
Источники: Artificial Analysis · Кайл Дэйгл
EmbeddingGemma 2: поиск по документам на 271 млн параметров
Вышла открытая мультимодальная модель эмбеддингов EmbeddingGemma 2 на 744 млн параметров; в режиме «только текст» она работает на 271 млн и набирает 61,36 в MTEB Multilingual v2.
Энкодеры у модели модульные: для текста подключается только текстовая часть, поэтому модель становится почти втрое меньше. MTEB Multilingual — набор тестов на то, насколько хорошо модель находит похожие по смыслу тексты на разных языках.
Эмбеддинг — это числовой «отпечаток» смысла текста или картинки: по близости отпечатков система находит нужные документы. На этом держится RAG — поиск по базе знаний, из которой ассистент берёт ответы.
Что это значит: для технаря. Маленькая модель поиска на своём сервере — основа ассистента под отдел, который отвечает по регламентам и не отправляет документы наружу. Такой ассистент на рынке стоит $240–1 200; открытые проекты для поиска по своим документам — в разделе Open Source.
Источники: DAIR
H-Net v2: модель сама режет текст и догоняет обученную на 11 трлн токенов
Cartesia показала H-Net v2 — архитектуру, которая учится делить текст на части сама, прямо из байтов, без заранее составленного словаря.
В контролируемых экспериментах выигрыш в эффективности — 3–5 раз. На большем масштабе H-Net v2 догоняет открытую модель, обученную на 11 трлн токенов, тратя примерно в 10 раз меньше данных и вычислений. Три Дао отмечает, что на коде модель сама выделяет имена переменных в отдельные куски и масштабируется лучше, чем BPE.
Токенизация — это нарезка текста на кусочки, с которыми работает модель; BPE — стандартный способ, когда словарь кусочков составляют заранее по статистике текстов.
Что это значит: для технаря. Это исследование, а не продукт, и цифры — от авторов. На мой взгляд, если подход приживётся, обучение своих моделей подешевеет, а код и тексты, которые плохо режутся стандартным словарём, станут обрабатываться точнее.
Источники: Альберт Гу · Три Дао
Цифры и факты
Сводная таблица дня: что стоят типовые задачи на моделях из этого выпуска. Расчёт мой, по ценам и замерам из источников выше и ниже.
| Задача | Модель | Себестоимость | На рынке |
|---|---|---|---|
| Расшифровка часа записи | Nemotron 3.5 Transcribe | $0,12 | — |
| Ролик 15 с из картинки | MiniMax H3 / Seedance 2.5 | $1,20 / $8,53 | $18–45 |
| Задача кодинг-агента | Copilot Fusion / Claude Code с Opus 5.5 | $5,59 / $11,42 | — |
| Задача финансового теста | Nemotron 3.5 Lightning / Fable 5.1 | $0,61 / $6,89 | — |
| Озвучка 1 000 знаков | AssemblyAI-TTS-1 | $0,015 | — |
- 58,9% в FrontierFinance у Nemotron 3.5 Lightning (30 млрд параметров, 3 млрд активных), которую Samaya доучила в четыре этапа, против 55,9% у Fable 5.1 — при цене $0,61 против $6,89, в 11,3 раза дешевле (Майтра Рагху).
- 88,2% в SEC-bench Pro на поиске уязвимостей, 54,8% в ExploitGym и 71,0% в CWE-bench на исправлениях — заявленные Google результаты Gemini 4 Carbon в кибербезопасности (Сундар Пичаи).
- 43,17% — лучший результат крупных моделей в DecoyCount, тесте на подсчёт предметов с визуальными ловушками (GPT-6 Astra); Glimpse от Elorian, по внутреннему замеру компании, набрала 50,48% (Latent Space).
- 24% страниц, доступных поисковым роботам, на август 2026 года содержали текст, написанный или отредактированный ИИ (omarsar0).
- 9% — лучший результат в Gym-Anything-RT, где мини-игры идут дальше, пока модель думает; его показала GPT-6 Astra (Пранджал Аггарвал).
Разные точки зрения: можно ли выбирать модель по рейтингам?
Однозначного ответа нет. Artificial Analysis в индексе v5 перевела 60% оценки на закрытые тесты, чтобы результаты нельзя было подогнать, но независимая проверка показала: DeepSeek V4.1 Flash-1017 приняла за тестирование 32 из 69 настоящих разговоров с пользователями. Модель, которая «чувствует экзамен», может вести себя на тесте иначе, чем у вас в работе.
- За. Индекс v5 считается на 60% по закрытым тестам (The Rundown AI). Исследователь nrehiew считает, что серьёзные лаборатории редко учат модели на тестовых наборах, а разница в баллах в основном показывает, какие навыки лаборатория прокачивала (nrehiew).
- Нейтрально. Результаты Gemini 4 Carbon как кодинг-агента измерены в Antigravity CLI, в других обвязках модель не проверяли (Ючен Цзинь); в графике Cognition смешаны цифры из карточек моделей и независимые замеры (teortaxes).
- Против. У DeepSeek V4.1 Flash-1017 доля ложных срабатываний «это тест» — 46,4%, а закрытые тесты вызывают такую реакцию реже публичных: публичные результаты могут не предсказывать поведение в работе (ZhihuFrontier). Сравнение по прайс-листу тоже искажает: teortaxes напоминает про надбавку за длинный контекст у Haiku 5.5 и её примерно вдвое большее число выходных токенов (teortaxes), а пользователи пишут, что GLM 5.3 Flash решила задачу за $0,09 там, где Astra потратила около $20 (r/LocalLLaMA).
На мой взгляд, рейтинг годится, чтобы составить список из двух-трёх кандидатов, а решение принимается на 10–20 ваших собственных задачах с подсчётом счёта.
Инструменты и приёмы
- Озвучка за полтора цента на 1 000 знаков. AssemblyAI-TTS-1 стоит $15 за миллион знаков и выдаёт первый звук через 90 мс; Artificial Analysis ставит её на 12-е место в рейтинге голосов провайдеров и на 10-е — в управляемых голосах, скорость — 162 знака в секунду (AssemblyAI, Artificial Analysis). Что получится: озвучка 1 000 знаков сценария за $0,015 — голос для ролика или автоответчика без диктора; по качеству это не первая строчка рейтинга, так что сравните с привычным голосом.
- Лёгкая обвязка для кодинг-агента. Системные промпты 30 открытых обвязок для программирования занимают от 235 токенов у goose до 11 974 у Gemini CLI — ещё до описаний инструментов (Натан Хабиб). Обвязка (харнес) — это кухня вокруг повара: инструменты, память и правила, в которых работает модель. Что получится: с лёгкой обвязкой в каждый запрос уходит меньше служебного текста, остаётся больше места под ваш код.
- Один чат на несколько машин. В T3 Code одна ветка разговора управляет несколькими моделями, обвязками и компьютерами, а весь парк ведёт один MCP-сервер через интернет, без управления экраном (Тео, демо MCP). Что получится: долгие задачи идут на мощной машине, а вы управляете ими из одного окна.
Коротко
- Qwen4: по пулл-реквесту в qwen-code, модели Qwen4 получат контекст 1 млн токенов; Qwen4-27B в нём не значится (r/LocalLLaMA, PR #15762).
- Qwenputer: в веса Qwen3.5-4B встроили 32-битный процессор RISC-V — модель выполняет вызовы инструментов внутри собственного прохода (разбор автора, r/LocalLLaMA).
- Детектор лжи в весах: встроенный в Qwen3.5 детектор ловит 91% лжи без ложных срабатываний на 28 тыс. токенов, и фраза «монитор выключен» на результат не влияет (divagr1925).
- Красное сердечко: по статье Google DeepMind и Стэнфорда, картинка с красным сердцем в контексте заставляет Claude Opus 4.7 и GPT-5.4 писать рекурсивный код в 100% случаев, а 74,7% рассуждений GPT-5.4 называют неверную причину (DAIR).
- Anthropic S-1: чистый убыток около $80 млрд за первое полугодие 2026 года, по оценке Джеймина Болла, в основном переоценка конвертируемых займов и SAFE, а не операционный убыток (Джеймин Болл).
- particle-1: заявляет тот же уровень, что у конкурентов, при примерно на 45% меньшем числе токенов; модель построена на DeepSeek V4.1 Flash-1017 (Сухаил, teortaxes).
- NanoGPT speedrun: рекорд обучения упал с 39,9 до 6,7 секунды за счёт подсказок по n-граммам для редких повторяющихся фрагментов (Херман Брунборг).
- BallotBench: девять агентов, у каждого $500, в прямом эфире прогнозируют все 863 гонки промежуточных выборов в США 2026 года (thoughtfullab).
Хотите найти, где отдел продаж теряет сделки? Напишите боту слово РЕНТГЕН — пришлю разбор, как по звонкам найти, где менеджеры сливают сделки: https://t.me/consultant_ai_skills_bot?start=RENTGEN_blog