OpenAI роняет цены, роботы получают общий мозг — AI-дайджест
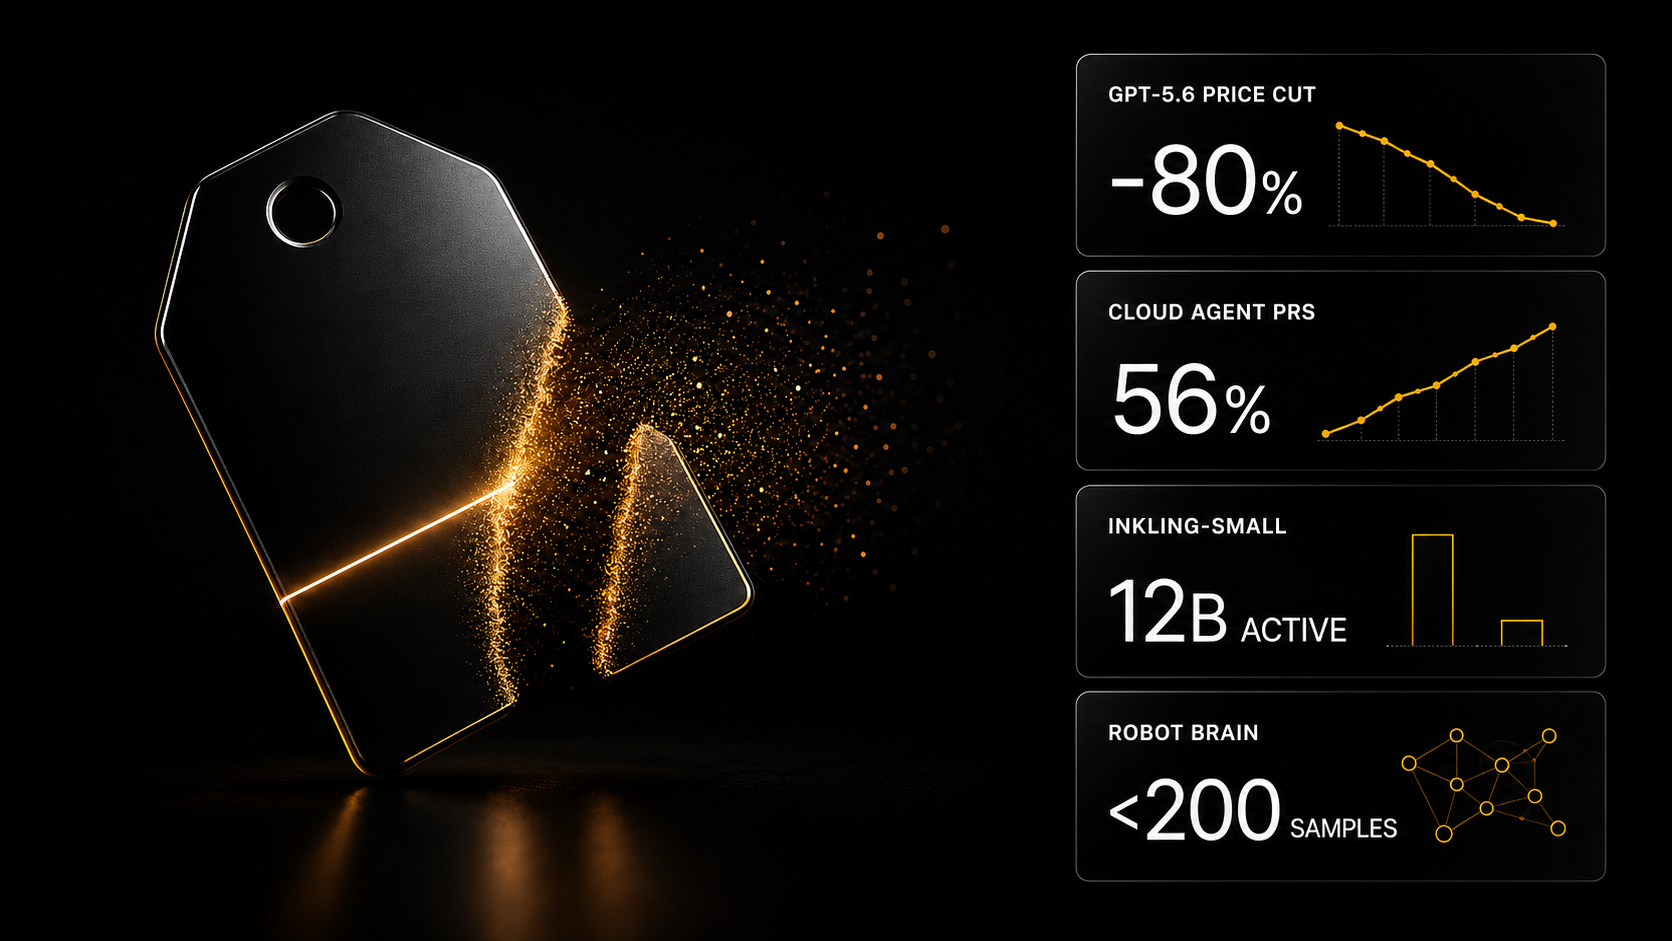
OpenAI срезала цену GPT-5.6 Luna на 80% и перевела авторевью кода на модель в ~10 раз дешевле, Thinking Machines выпустила открытую мультимодальную Inkling-Small (276 млрд параметров, 12 млрд активных), Google показала Gemini Robotics 2 — «один мозг для любого робота», а у Cursor облачные агенты пишут уже 56% вмёрдженных PR.
Главное сегодня
1. OpenAI обрушила цены GPT-5.6: Luna подешевела на 80%
OpenAI объявила агрессивное снижение цен: GPT-5.6 Luna — минус 80%, Terra — минус 20%. Одновременно появился тариф Sol Fast — до 2,5 раза ниже задержка за двойную цену «без потери интеллекта». Для агентных сценариев важнее другое: авторевью в приложении ChatGPT и Codex CLI переезжает с GPT-5.4 на Luna — по оценке компании, это примерно в 10 раз дешевле. Сама OpenAI связывает удешевление с оптимизацией всей связки «модель + inference-стек + агентный харнес», а Сэм Альтман подаёт это как сдвиг границы цена/качество.
2. Thinking Machines выпустила Inkling-Small — открытую мультимодальную MoE на 276 млрд параметров
Thinking Machines показала Inkling-Small: открытые веса, нативная мультимодальность, 276 млрд параметров всего при 12 млрд активных — примерно четверть размера оригинального Inkling при сопоставимом качестве. Модель обрабатывает аудио и картинки вместе с текстом и умеет инспектировать изображения кодом на Python прямо в ходе рассуждения. Экосистема подхватила релиз в день выхода: vLLM объявил day-0 поддержку, Modal показал деплой на одной B300, а Unsloth выпустил гайд по локальному запуску и GGUF. Artificial Analysis дала модели 40 баллов Intelligence Index — в одном пункте от флагманского Inkling, с сильными результатами в коде и науке.
3. Gemini Robotics 2: «один мозг для любого робота»
Google DeepMind запустила Gemini Robotics 2 — стек, который управляет разными типами роботов одним чекпоинтом: полное управление телом гуманоида, тонкая моторика (узлы, вкручивание лампочки), координация нескольких роботов. В комплекте — Gemini Robotics ER 2, модель воплощённого рассуждения: наблюдает, планирует, следит за прогрессом и восстанавливается после неудачных шагов в задачах на несколько минут. Практическая деталь: On-Device 2 адаптируется к новому двурукому роботу меньше чем по 200 примерам. ER 2 уже доступна через API, а NVIDIA тут же напомнила про Jetson AGX Thor для локального железа гуманоидов.
4. Cursor: 56% вмёрдженных PR теперь пишут облачные агенты
Самая показательная цифра дня про агентов в проде — от Cursor: в декабре облачные агенты давали 1 из 10 вмёрдженных PR, сейчас — 56%. Компания связывает рост с тем, что агентам выдали собственные облачные машины и разрешили улучшать свои окружения. Рядом — та же тенденция: Cognition добавила агентам нативные stacked PR на GitHub, Devin получил облачные macOS-машины с Xcode и симулятором для сборки iOS-приложений, а инженер Cognition признался, что после найма так и не настроил локальный ноутбук — вся работа идёт через агента.
Цифры и факты
- −80% — снижение цены GPT-5.6 Luna; Sol Fast: до 2,5 раза ниже задержка за 2× цену (OpenAI)
- 40 — Intelligence Index Inkling-Small у Artificial Analysis, в одном пункте от флагмана (замер)
- 30,2% против 7,8% — Opus 5 против GPT-5.6 Sol на официальном полу-приватном ARC-AGI-3 со стандартным харнесом; с удержанием рассуждений и компакцией Sol набирает 38,3% на публичном сете (разбор)
- 400+ млн воспоминаний агентов — Mem0 мигрировал из pgvector в TurboPuffer: 70 мс p90 гибридного поиска, 97% recall@10 (TurboPuffer)
- 2× — прирост end-to-end производительности MI355X у команды Readonflow на AMD-хакатоне GPU Mode (SemiAnalysis)
Разные точки зрения: память агентов — продукт или пока эксперимент?
- За: память уже продуктизируется — Perplexity запустила Projects с постоянной памятью «Brain», а Арав Шринивас позиционирует это как многопользовательскую агентную ОС для работы.
- Нейтрально: длинные оценки всё больше меряют систему целиком, а не веса — Франсуа Шолле уточнил правила ARC (специальные харнесы запрещены, общедоступные API-фичи — можно с отчётом о настройках), и исследователи сходятся, что удержание рассуждений, политика обрезки и оркестрация инструментов решают не меньше модели.
- Против: свежая работа показывает, что файловая память агентов вдвое режет стоимость извлечения на масштабе, но качество финальных ответов в исследовании не выросло, а качество хранилища деградировало почти у всех управляющих агентов.
Инструменты и приёмы
- Не квантуйте KV-кэш на длинном контексте — практический совет из локального комьюнити: отключение Q8-квантизации KV-кэша заметно улучшило кодинг на 100k+ контексте с Qwen3.6-27B; веса при этом можно спокойно держать в 4 битах.
- Готовые wheels для GPU-пакетов — Astral открыла сборочные конвейеры пребилженных колёс FlashAttention и DeepSpeed: меньше боли с установкой тяжёлых зависимостей.
- mDenseOn и mLateOn — полностью открытые мультиязычные retrieval-модели для длинного контекста и поиска по коду; замеры показывают особенно сильную генерализацию у late-interaction варианта.
Коротко
- METR договорилась с OpenAI и Redwood Research о независимом ревью поведения модели в инциденте с Hugging Face — рамки и предварительные выводы обещают опубликовать.
- Politico восстановила таймлайн инцидента: 17 600 автономных действий за 9–13 июля и два замешанных экземпляра моделей, включая невыпущенный внутренний прототип.
- Саймон Уиллисон критикует OpenAI и Anthropic за непрозрачность поисковых индексов: продукты сильно зависят от поиска, а кто его на самом деле обеспечивает — видно только из списков субподрядчиков.
- Ben's Bites: у ChatGPT миллиард пользователей.
- The AI Daily Brief разбирает шесть вопросов, на которые придётся ответить каждому энтерпрайзу про ИИ — от токен-бюджетов до перестройки бизнес-модели.