Модель OpenAI решила 10 открытых задач за $2000 — AI-дайджест
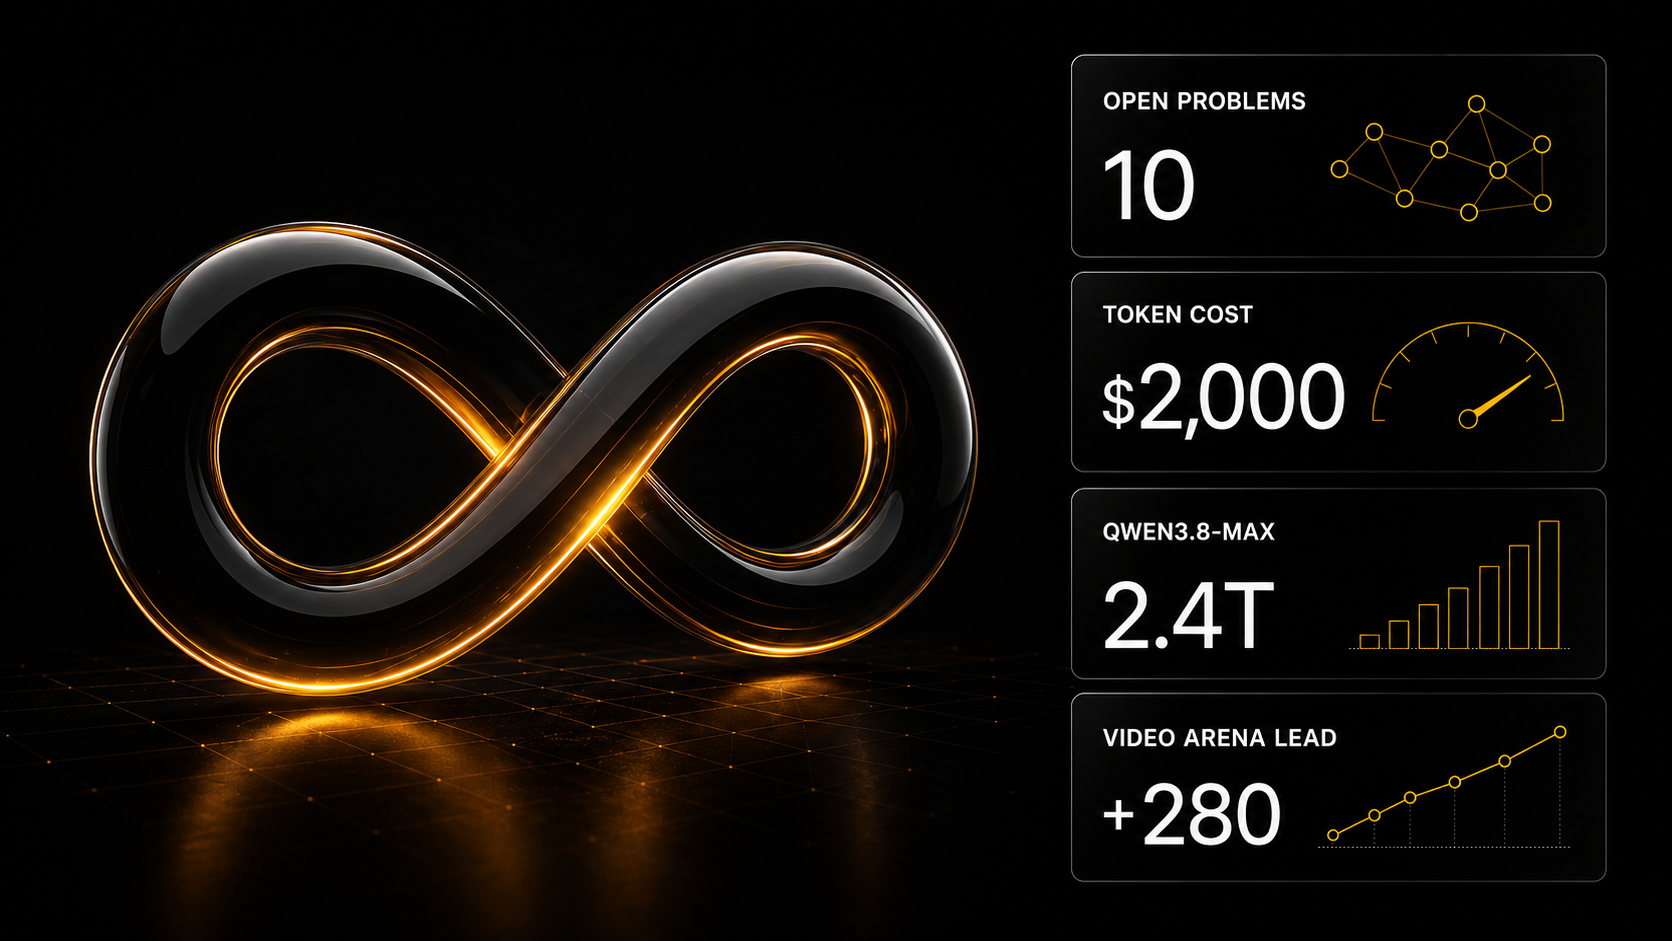
Внутренняя модель OpenAI выдала 10 новых результатов по открытым математическим задачам при затратах около $2000. Alibaba анонсировала открытый флагман Qwen3.8-Max на 2,4 трлн параметров, MiniMax H3 возглавила Video Arena среди открытых моделей, а GPT-Live научился слушать и говорить одновременно.
Главное сегодня
OpenAI: внутренняя модель выдала 10 новых результатов по давним открытым проблемам. По заявлению компании, внутренняя версия следующей крупной модели получила 10 новых результатов по давно стоявшим открытым задачам математики и теоретической информатики — при затратах порядка $2000 в токенах. Сюжет разошёлся по профильным рассылкам: разбор The Rundown и сводка Superhuman. Главный вопрос, который он поднимает: что делать, когда прорывы моделей опережают возможности экспертов их проверять.
Alibaba анонсировала Qwen3.8-Max — открытый флагман на 2,4 трлн параметров. Открытые веса обещаны на следующей неделе (вместе с компактной Qwen3.8-27B), цены — $2/$6/$0,25 за миллион входных, выходных и кешированных токенов. Первые независимые замеры: #4 в Frontend Code Arena, #2 в Vision Arena, 66,1 в индексе Vals — #2 среди открытых моделей. Отраслевой контекст: открытый фронтир всё заметнее задают китайские лаборатории — Kimi, Qwen, DeepSeek, GLM, MiniMax; Vals называет DeepSeek V4 Flash 0731 самой дешёвой моделью индекса с баллом выше 60 — в 35 раз дешевле ближайшего конкурента на этом пороге.
MiniMax H3 — открытый лидер видеогенерации. Video Arena поставила H3 на #1 среди открытых моделей с отрывом +280 пунктов, а в image-to-video — практически #1 в общем зачёте. Важное уточнение по лицензии: ограничения для США/ЕС/Британии/Кореи оказались процедурой формальной авторизации, а не полным запретом — существенная разница для команд, оценивающих деплой (исходная тревога).
OpenAI перестроила realtime-голос: GPT-Live слушает и говорит одновременно. Новая архитектура разделяет быстрый аудио-тракт и медленные асинхронные пути рассуждений и инструментов, а старт сессии сократился с шести сетевых раундтрипов до одного.
Цифры и факты
- 10 результатов по открытым математическим задачам при ~$2000 затрат в токенах (OpenAI).
- Qwen3.8-Max: 2,4 трлн параметров; $2/$6/$0,25 за миллион токенов (Alibaba Qwen).
- DeepSeek V4 Flash 0731 — в 35 раз дешевле ближайшей модели индекса Vals с баллом выше 60 (Vals).
- Kimi K3 в сервинге: 239 токенов/с на Databricks (замер) и 947 токенов/с decode при батче 32 на одном узле B300 (замер).
- Zero-Mem: минус 57,6% стоимости операций памяти агента без потери качества (конспект).
Разные точки зрения
Илон Маск заявил, что исходный код вот-вот станет «как ассемблер» — ИИ будет компилировать намерение сразу в бинарники. Скептическая рамка из исследований того же дня: свежая систематизация 41 режима отказа агентов показывает, что сбои рождаются на стыках модели, обвязки, инструментов и памяти — а значит «прямая компиляция намерений» упирается не в интеллект модели, а в инженерию всей системы. Середина: долгосрочная агентная способность — это коэволюция модели и рантайма, и хоронить код рано.
Инструменты и приёмы
- Дайте модели работать так, как её обучали. Cline замечает, что многие открытые модели RL-обучены перепроверять свою работу — перезапускать тесты, перечитывать диффы — и не мешать им это делать даёт около 20% прироста только за счёт обвязки.
- Память без LLM-вызовов. Zero-Mem выносит обслуживание памяти агента из LLM: модель вызывается только за финальным ответом.
- Cursor подключился к Google Workspace. Плагины для Gmail, Drive, Calendar, Docs и Sheets — агенты в редакторе получают доступ к рабочим документам.
Коротко
- Cloudflare представила @cloudflare/computer — рантайм агентов с переключением между изолятами и полноценными контейнерами.
- Photon 2.0 компилирует модели в мегаядра — весь форвард-пасс как одна GPU-программа.
- TokTier ускоряет токенизацию агентных сессий: минус 16–34% к времени первого токена под vLLM.
- Jina выпустила reranker v3.5 на 0,6B параметров — 63,20 nDCG@10 на BEIR при в ~7 раз меньшем размере, чем у конкурента.