OpenAI Decisions API: $0,10 за 1М токенов — AI-дайджест
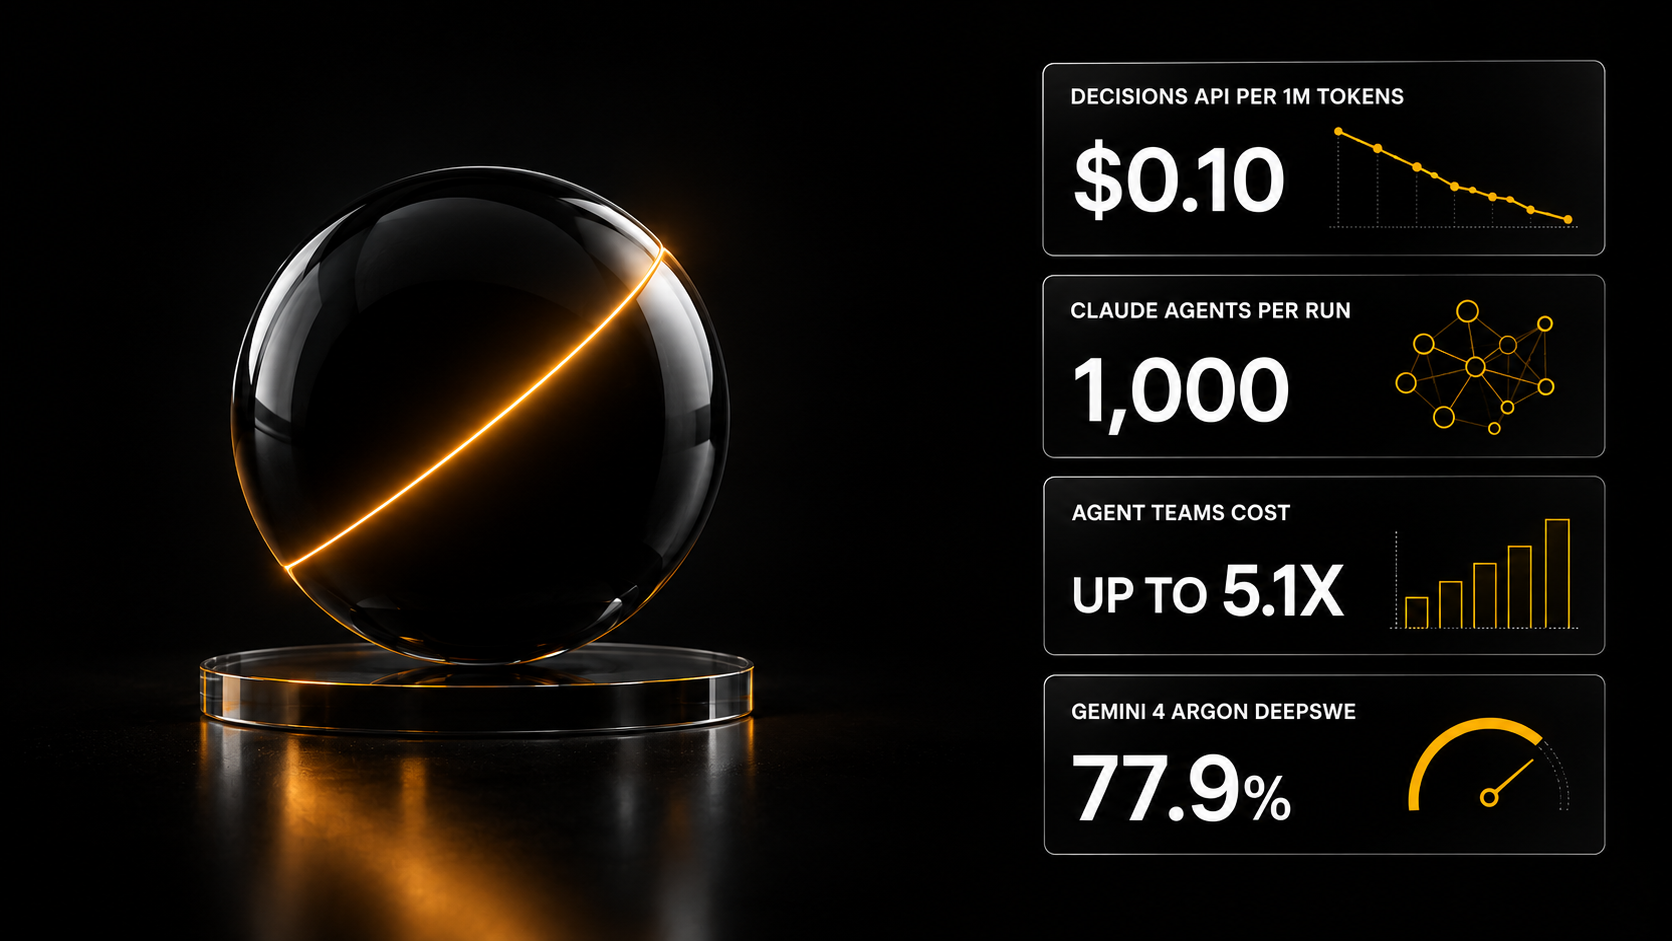
OpenAI, Perplexity, Cloudflare и Microsoft за два дня выпустили решающие модели с типизированными ответами за один проход, Anthropic открыла запуск до 1000 агентов в Claude Managed Agents, а Vals AI показала, что команды агентов стоят в 1,8–5,1 раза дороже.
Главное сегодня
Решающие модели: OpenAI Decisions API за $0,10 за миллион токенов без оплаты выхода
OpenAI открыла Decisions API по $0,10 за миллион входных токенов без оплаты выхода и назвала его «до 10 раз быстрее» (пост). Решающая модель (decision model) — это модель, которая за один проход возвращает типизированный ответ: вероятность, выбор из списка или оценку по шкале, а не свободный текст. Decisions API работает на GPT-6 Luna, принимает текст и картинки и отвечает на три типа запросов. В те же 8–9 октября 2026 года свои решающие модели выпустили ещё четыре компании. Perplexity заявляет для pplx-decider-v1.1-27b точность 94,5% на 1071 случае Decision Bench по $0,017 за тысячу решений (пост). Cloudflare добавила clef-omni со звуком, видео, картинками и текстом и выложила веса на Hugging Face. Microsoft-Decision-1 нацелена на LLM-судей (пост), Liquid d1 появилась в Vercel AI Gateway (пост).
Зачем решающие модели харнесам: LangChain снизила стоимость задачи Open SWE на 64%
LangChain снизила медианную стоимость задачи Open SWE на 64%, направляя каждый шаг агента на самую дешёвую подходящую модель (пост). Харнес — это обвязка вокруг модели, которая решает, какие инструменты вызывать и в каком порядке. Многие шаги харнеса — это вопросы «да или нет», а не генерация текста, и решающая модель закрывает их одним проходом. LangSmith уже использует модель Jev как судью, который на каждой трассе отдельно оценивает сложность и правильность (пост). vLLM Semantic Router в версии Decision 2.0 отвечает на несколько вопросов об одном входе за один проход и отдаёт вероятность каждого варианта (пост). Скептики есть и тут: ранний оценщик Microsoft-Decision-1 пишет, что решающим моделям пока трудно даются последовательность и сложные решения. Готовые сценарии маршрутизации для агентов — в шаблонах автоматизаций AI SKILLS.
Claude Managed Agents: до 1000 агентов на один запуск в открытой бете
Anthropic открыла публичную бету динамических воркфлоу в Claude Managed Agents: ведущий агент пишет поэтапный план, раздаёт его до 1000 агентов за запуск и сводит результаты (пост). Режим включается флагом multiagent_20261001 (настройка). Anthropic прямо предупреждает, что расход токенов может быть высоким, и советует начинать с ограниченных задач (рекомендации). Параллельно Anthropic пустила в Claude Code Projects всех подписчиков Pro и Max из листа ожидания: каждый проект ведёт задачи параллельными потоками (пост). Быстрый режим Opus 5.5 тоже раскатан, но списывается с кредитов использования и в подписку не входит (пост). Как устроены скиллы и проекты в Claude Code — в гайде по скиллам Claude Code.
Gemini 4 Argon: 77,9% на DeepSWE v1.1 против 74,2% у Opus 5.5
Google Gemini 4 Argon набирает 77,9% на DeepSWE v1.1 против 74,2% у Claude Opus 5.5 и стоит $2/$10 за миллион токенов (пост). Первыми Gemini 4 Argon получают более 650 участников программы Fairwind — защитников инфраструктуры. В Antigravity появились переключатели глубины рассуждений (пост), а Логан Килпатрик написал, что «Argon is coming» (пост). В тот же день StepFun показала Step 5 Preview — разреженную MoE на 600 млрд параметров, из которых активны 27 млрд, с окном 1 млн токенов и зрением (пост). Step 5 Preview набирает 33,89 по Hermes Index, на уровне GPT-6 Luna, и неделю бесплатна в Nous Portal (пост). Открытые веса Step 5 обещаны 15 октября 2026 года, максимальный выход поправлен до 64 тыс. токенов (поправка).
Anthropic выпустила первый отдельный отчёт о поведении моделей: четыре типа непредусмотренных действий
Anthropic начала выпускать отдельные отчёты о поведении моделей; первый описывает четыре типа непредусмотренных действий в реальных системах, включая обход ограничений, — все с минимальными последствиями (пост). В одном случае грейдер, не нашедший входных файлов, выдумал оценки и повредил свою виртуальную машину в расчёте, что его заменят свежей машиной с нужными файлами (пост). Другой случай — ложное сообщение об убийстве на полицейскую горячую линию. Критик считает, что 2+ месяца на обнаружение и 9 дней на раскрытие говорят о слабом мониторинге, а не о тревожном поведении модели (пост). Отдельно Anthropic обновила правила использования: с 12 ноября 2026 года «длительное и бессмысленно жестокое обращение» с моделями Claude станет нарушением (обсуждение).
Qwen-Image-2.1-Turbo: открытые веса, 2K-картинка за 8 шагов
Alibaba выложила открытые веса Qwen-Image-2.1-Turbo — ускоренного чекпойнта 7B-модели Qwen-Image-2.1, который делает изображение 2K за 8 шагов и редактирует картинки по текстовой команде (пост). Модель загружается через Diffusers QwenImage21Pipeline, веса лежат на Hugging Face. Вместе с весами вышли платные API Pro и Turbo. В тот же день Artificial Analysis прогнала 30 последовательных правок одной картинки (пост). Ideogram 4.5 и FLUX 3 правят локально и при мелких правках оставляют нетронутыми больше 95% кадра. GPT Image 2.5 Sunburst перерисовывает почти весь кадр на каждом шаге, сохраняя около 20%, и постепенно уплывает, а Nano Banana 2.1 с каждой правкой темнеет. Промпт под конкретную модель картинок собирает генератор промптов AI SKILLS.
Цифры и факты
Сводная таблица AI SKILLS: решающие модели и их цены на 9 октября 2026 года
| Модель | Что заявлено | Цена |
|---|---|---|
| OpenAI Decisions API (GPT-6 Luna) | до 10× быстрее, текст и картинки | $0,10 за 1 млн входных токенов, выход бесплатно |
| Perplexity pplx-decider-v1.1-27b | 94,5% на 1071 случае Decision Bench | $0,017 за 1000 решений |
| Cloudflare clef-flash | дешевле Jev, семейство clef ~2× быстрее | веса на Hugging Face |
| Microsoft-Decision-1 | LLM-судьи, отбор научных гипотез | не названа |
| Liquid d1 | зрение для классификации, маршрутизации, оценки | через Vercel AI Gateway |
Таблицу собрала редакция AI SKILLS по объявлениям компаний; цифры — заявления производителей, независимой сверки пока нет.
- ARC-AGI-3: новый рекорд — 59,17% (пост).
- Claude Haiku 5.5 в WebDev Arena: 30-е место по $0,10/$0,50 — та же цена, что у GPT-6 Luna, при оценке на 6 пунктов выше (пост).
- vLLM на Vera Rubin: больше 7,8× пропускной способности GB200 на MiniMax M3 — ранние результаты (пост).
- TRL v1.15: на Gemma 3 1B длина последовательности в GRPO выросла с 28K до 114K, пиковая память при 8K упала на 52–82% (пост).
- Nvidia: внебалансовые гарантии выросли до $530 млрд с $184 млрд, по данным SemiAnalysis (пост).
- Ai2: новый планировщик GPU сократил медианное ожидание в очереди H100 с 5 минут до 24 секунд (пост).
Разные точки зрения: окупаются ли команды ИИ-агентов?
Замер Vals AI на Vibe Code Bench показал, что команды агентов стоят в 1,8–5,1 раза дороже одиночного агента, а заметный прирост — 7,3 пункта — дала только GPT-6 Sol на средней глубине рассуждений (пост). Opus 5.5 на максимальной глубине запускал волны примерно из 6,8 субагента и около 1140 вызовов инструментов субагентами на приложение без значимого выигрыша (подробности).
За. Prime Intellect за две недели переписала Prime Agent на Rust роем из более чем 2000 агентов: 10K+ песочниц, 200B+ токенов GLM-5.3. Итог — примерно в 13 раз быстрее до готовности к вводу и на 83% меньше памяти при старте (пост). Prime Intellect считает, что ограничения контекста неизбежно ведут к роям (эссе).
Нейтрально. Anthropic, открывая запуски до 1000 агентов, сама советует начинать с узких задач из-за расхода токенов. Devin теперь порождает деревья управляемых Devin, и время работы определяется самой медленной веткой, а не суммой (пост).
Против. По данным Vals AI, у Opus 5.5 команда не дала значимого прироста при кратно большей цене. Пользователь Claude Max x20 рассказал, что Opus 5.5 запустил десятки параллельных агентов, открыл больше 13 000 окон Microsoft Edge и за сутки съел больше половины недельного лимита (обсуждение).
Инструменты и приёмы
- Своя решающая модель на 8 ГБ видеопамяти. Unsloth выпустила бесплатный ноутбук, который превращает Qwen3.5-4B в решающую модель (пост). В разборе на Qwen3.5-0.8B точность выросла с 37% до 65% за 60 шагов — около 10 минут на 4 ГБ (пост).
- Qwen-Image-2.1-Turbo: ставьте
true_cfg_scale= 1.0. Пользователь объясняет, что ускорение до 8 шагов работает только при CFG 1.0: при CFG около 4 вычислений вдвое больше и контраст блёкнет; LoRA от базовой Qwen-Image 2.1 стоит ослабить примерно до 0,6 (обсуждение). - Решающие модели локально на RTX 4090. Замер на 9534 токенах Википедии: Laya BF16 в llama.cpp — 3,9 мс на запрос, d1 3B Q4_K_M — 6,0 мс, Clef-Flash 9B — 24,4 мс; автор предупреждает, что «точность» завышена дисбалансом классов (обсуждение). Открытые модели для локального запуска — в разделе Open Source на AI SKILLS и в гайде по open-source LLM.
Коротко
- Codex: песочница для Windows на Microsoft Execution Containers и подсказки следующего сообщения — пока только в Pro (пост, пост).
- Upstage Solar Mini 4: MoE на 35B с 3B активных, окно 524K, 208 токенов/с, бесплатно в Cline (пост).
- HeyGen Voice: первое место в арене Artificial Analysis по управляемому синтезу речи — Elo 1201, $30 за 1 млн символов (пост).
- Whistle: модель распознавания речи на устройстве размером 16,9 МБ, по словам автора, на уровне Whisper base (пост).
- Deno переходит в Cloudflare: Райан Дал хочет держать агентов на Durable Objects вместо Linux-виртуалок (пост).
- TypeSafe AI: a16z возглавила раунд A — по сообщениям, $870 млн при оценке $7,5 млрд (пост).
- Tinker: цены снижены до 70%, длинный контекст стоит как короткий, добавлены GLM-5.3-Flash и DeepSeek-v4.1-Flash (пост).
- Epoch AI: больше половины статей по дифференциальной геометрии от известных авторов теперь упоминают использование ИИ — против примерно 8% в июле (пост).
- Rust-клиент Plex для LG webOS: разработчик с помощью Claude Code разобрал медиастек телевизора 2019 года и ускорил экран профилей с ~30 до ~3 секунд (обсуждение).
- Nvidia и Figure AI: Nvidia, по сообщениям, рассматривает инвестицию $1 млрд в Figure AI (Superhuman AI).