GPT-6.1 Sol: 49% FrontierCode за $0,81 — AI-дайджест
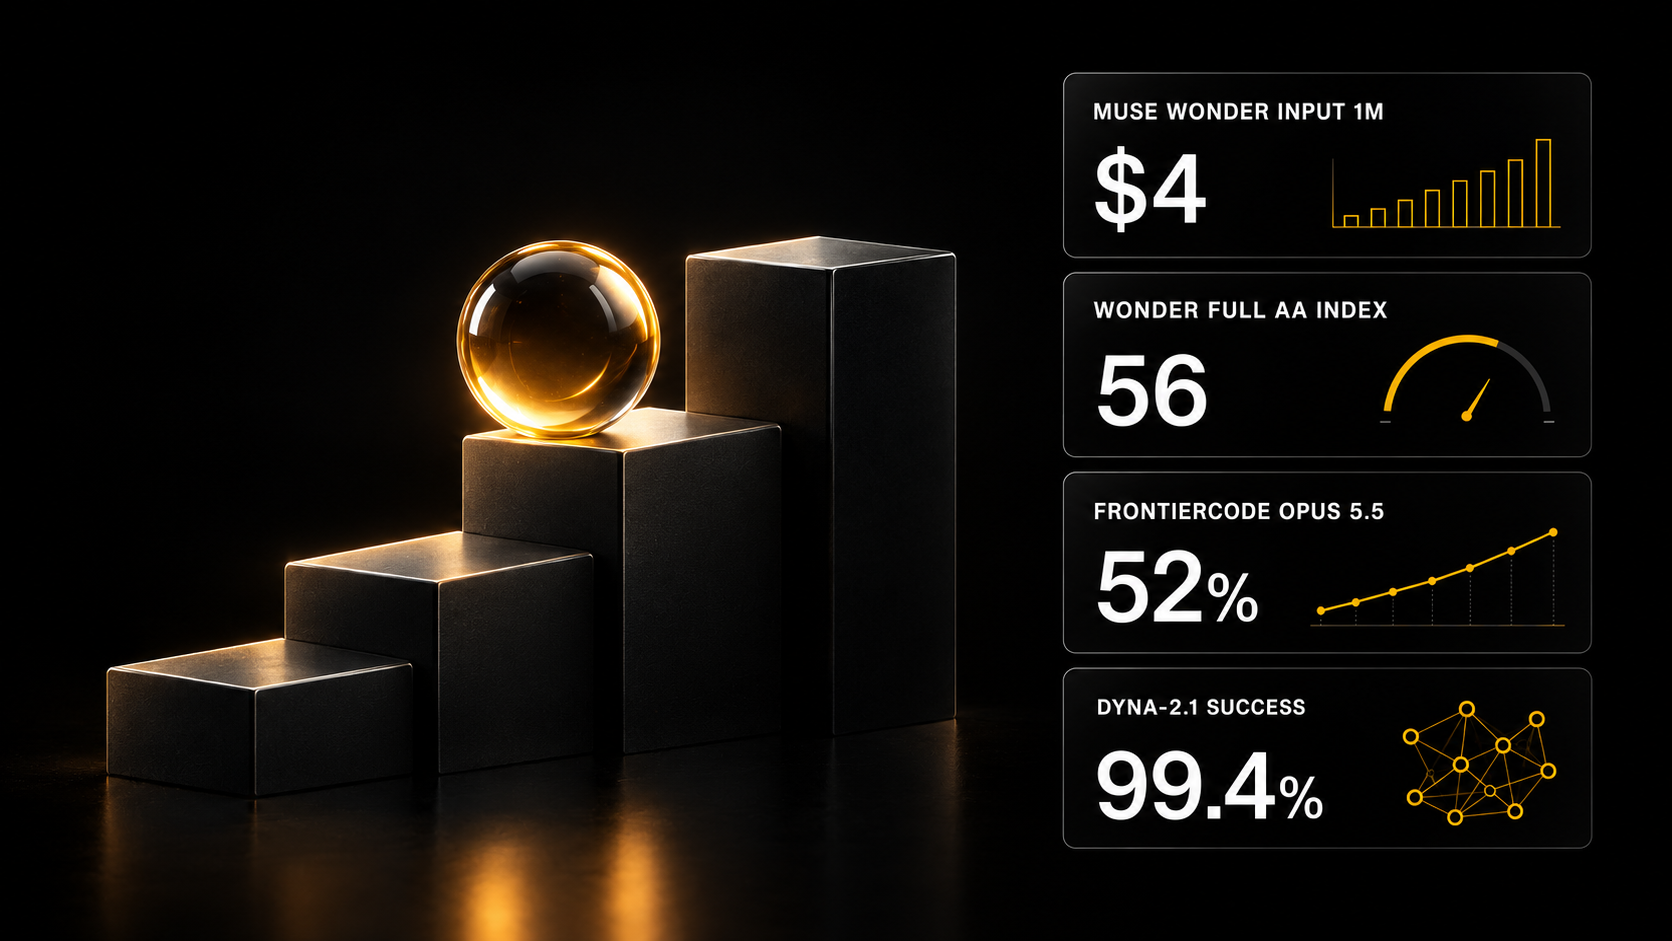
GPT-6.1 Sol набрал 49% в FrontierCode 1.1 по $0,81 за задачу — всего на 3 пункта ниже лидера Claude Opus 5.5; Meta выпустила Muse Wonder по $4 и $20 за миллион токенов, а робот Dyna-2.1 сутки складывал салфетки с успехом 99,4%.
Главное для вас сегодня: разрыв в качестве между лучшими моделями для кода — 3 процентных пункта, а в цене задачи — в разы. Прежде чем платить за самую громкую модель, посчитайте, во что вам обходится одна задача.
Главное сегодня
GPT-6.1 Sol: 49% в FrontierCode 1.1 за $0,81 за задачу
GPT-6.1 Sol набрал 49% в бенчмарке FrontierCode 1.1 при цене $0,81 за задачу и сравнялся с Fable 5.1, которая стоит больше чем в десять раз дороже; первое место занял Claude Opus 5.5 с 52%.
FrontierCode 1.1 — это закрытый бенчмарк Cognition, который проверяет, принял бы мейнтейнер правку модели в реальный проект. Лучшая модель с открытыми весами — MiMo-V2.6-Pro с 45%, а девять задач не решила ни одна модель. В индексе Artificial Analysis GPT-6.1 Sol получает 52 балла при $0,72 за задачу, GPT-6 Astra — 53 балла при $3,26.
Механика простая: все сравнивают проценты, а считать надо цену одной принятой правки — и здесь разница кратная.
Что это значит: если вы делаете сайты и ботов на заказ (по нашему прайс-листу лендинг у новичка — $125–375, бот под ключ — $100–3 000), агент для правок кода стоит центы за задачу. Ради 3 пунктов качества переплачивать в разы я бы не стал.
Источники: Artificial Analysis · Cognition · DeepLearning.AI
Meta Muse Wonder: $4 и $20 за миллион токенов, упор на финансы и право
Meta Superintelligence Labs 12 октября 2026 года выпустила семейство Muse Wonder из двух моделей — быструю Muse Wonder и максимальную Muse Wonder Full — для «личной и профессиональной агентной работы».
Muse Wonder стоит $4 за миллион входных токенов, $0,20 за кэшированный вход и $20 за миллион выходных, держит контекст в 1 млн токенов и принимает текст, изображения, видео и аудио. Muse Wonder доступна через Meta Model API и в Muse Code, Muse Wonder Full — только подписчикам Muse Code; по данным Ben's Bites, подписка начинается от $50 в месяц. В день запуска ошибка слишком быстро съедала квоту Muse Code — Meta её исправила и обнулила расход.
Александр Ванг называет главными функциями Active Memory (память на дни и недели), Active Focus (доведение задачи до конца через блокеры) и силу в финансах и праве.
Что это значит: для юристов и финансистов это пока заявление компании, а не независимый замер. Граница доверия прежняя: договор и отчёт после модели проверяет человек.
Источники: Марк Цукерберг · Artificial Analysis · AI at Meta · Ben's Bites · Александр Ванг · исправление
Dyna-2.1: робот 24 часа складывал салфетки с успехом 99,4%
Dyna Robotics показала робота-агента Dyna-2.1, который 24 часа подряд складывал ресторанные салфетки с успехом 99,4%, включая восстановление после того, как опрокинул всю стопку.
Роботы Dyna Robotics уже работают у клиентов, в том числе складывают тысячи салфеток в день в ресторанах Din Tai Fung. По словам сооснователя и главного научного сотрудника Джейсона Ма в подкасте Latent Space, новым задачам роботы учатся по 45 минутам демонстраций.
В основе — Dyna-2, модель «мир-действие»: это модель, предобученная на миллионе часов видео с людьми, которая предсказывает будущее видео и по нему выбирает действия робота. Компания строит колёсных полугуманоидов вместо двуногих, а узкими местами Ма называет перегревающиеся ловкие руки и нехватку сенсорных данных.
Что это значит: для ресторана это первый пример, где робот закрывает рутинную операцию сутки без перерыва. Цену робота компания не называет — считать окупаемость пока не из чего.
Источники: Latent Space
Muse Wonder Full: 56 баллов Artificial Analysis против 58 у Opus 5.5
Artificial Analysis поставила Muse Wonder Full 56 баллов, а Muse Wonder — 52 против 48 у прошлой Muse Spark 1.3; выше Muse Wonder Full только Claude Opus 5.5 с 58 баллами.
Intelligence Index Artificial Analysis — это сводный балл независимой лаборатории, которая сама прогоняет модели через тесты на рассуждение, знания и агентную работу. Самый большой рост у Muse Wonder Full — на Terminal-Bench 4.0: с 33% до 57%. В Vals Index модель дебютировала пятой, выше всех моделей OpenAI, и решила 94 задачи ProofBench из 100 против 58 у предшественницы.
Обратная сторона — расход: около 54 тыс. выходных токенов на задачу. Одна задача индекса обходится Muse Wonder в $4,52 против $0,72 у GPT-6.1 Sol — в шесть с лишним раз дороже — и $5,98 у Opus 5.5.
Что это значит: по себестоимости задачи Muse Wonder ближе к Opus 5.5, чем к дешёвым моделям, хотя цена за токен ниже.
Источники: Artificial Analysis · The Rundown AI · Vals AI · Vals AI
Anthropic: модель на 9 млрд параметров запустила инференс на 8 из 9 типов железа
Frontier Red Team Anthropic пишет, что небольшие модели могут быть в «месяцах» от самовоспроизведения на потребительских IoT-устройствах: в тестах модель на 9 млрд параметров запустила инференс на 8 из 9 типов железа.
Критик отвечает, что инференс шёл со скоростью 0,39 токена в секунду на Android TV-приставках, сеть в тесте была смоделирована с заведомо открытыми портами, а способная модель работала на отдельных серверах.
Отдельно Anthropic сообщила, что заметно снизила эффективность дистилляционных атак на Claude. Дистилляционная атака — это попытка обучить свою модель на ответах чужой, массово выкачивая их через API. В исследовании Anthropic называет GLM-5.3 от Zhipu моделью, которая, по утверждению компании, переняла кибервозможности американских моделей; в r/LocalLLaMA это утверждение оспаривают.
Что это значит: для тех, кто строит продукты на API Claude, массовая выгрузка ответов становится менее надёжным путём. Вывод о самовоспроизведении спорный — у критика есть конкретные цифры.
Источники: выдержка 1 · выдержка 2 · @ziv_ravid · Anthropic · Anthropic · Reddit
Decision 3.0: открытые модели от 0,6B до 27B, которые отвечают вероятностью
Decision 3.0 — открытое семейство моделей от 0,6B до 27B под Apache-2.0, которое не пишет текст, а выдаёт откалиброванные вероятности для выбора, ответа «да/нет» и оценки; GGUF-сборки для llama.cpp вышли сразу.
Модель-«решатель» отвечает не абзацем, а числом: насколько вероятен каждый вариант. Такой ответ проще встроить в конвейер, чем разбирать свободный текст, а GGUF-сборки запускаются на своём железе через llama.cpp.
Что это значит: классификацию заявок или проверку «подходит / не подходит» можно держать у себя, и данные не уходят наружу. Про запуск открытых весов — гид по open-source LLM.
Источники: Hugging Face · Reddit
Цифры и факты
- 57,5% на SWE-Marathon у Muse Wonder Full против 46,3% у Opus 5.5 и 42,5% у GPT-6 Astra — это данные самой Meta (сводка); на DeepSWE Meta приводит 79,0% против 74,2% и 74,1% (@Yuchenj_UW).
- AA-3D: в рейтинге, где модели-агенты строят сцены three.js, а люди голосуют попарно, Sonnet 5.5 (1194), Opus 5.5 (1190) и Astra (1165) статистически делят первое место, а среди открытых моделей лидирует Kimi K3 с 982 (Artificial Analysis).
- 94% задач подтверждённо доводят до конца пять лучших моделей Agent Arena против 80% раньше; Kimi K3 догнала июльского лидера Fable 5 за три недели при цене задачи на 89% ниже (Arena).
Наша сводка: сколько стоит одна задача индекса Artificial Analysis и сколько баллов она даёт (по данным Artificial Analysis и DeepLearning.AI из этого выпуска).
| Модель | Балл AA | Цена задачи AA | Цена за 1М токенов (вход / выход) |
|---|---|---|---|
| Claude Opus 5.5 | 58 | $5,98 | — |
| Muse Wonder Full | 56 | — | цена не объявлена |
| GPT-6 Astra | 53 | $3,26 | — |
| Muse Wonder | 52 | $4,52 | $4 / $20 |
| GPT-6.1 Sol | 52 | $0,72 | — |
Разные точки зрения: догнала ли Meta лидеров с Muse Wonder?
Независимые замеры ставят Muse Wonder Full на второе место индекса Artificial Analysis — 56 баллов против 58 у Claude Opus 5.5, — но первые отзывы расходятся сильнее, чем цифры: подкаст The AI Daily Brief посвятил отдельный выпуск разрыву между бенчмарками и реальной работой с Muse Wonder (The AI Daily Brief).
- За. Тео (@theo) ставит Muse Wonder Full в один высший уровень с Opus 5.5 (@theo); глава Perplexity Аравинд Шринивас пишет, что на внутренних тестах Perplexity WANDR модель выглядит не хуже Fable 5.1 (Аравинд Шринивас).
- Нейтрально. Artificial Analysis отмечает высокий расход токенов: задача индекса обходится Muse Wonder в $4,52 против $0,72 у GPT-6.1 Sol (Artificial Analysis). Рассылка Superhuman AI вынесла в заголовок, что новые модели Meta обходят Fable и Astra (Superhuman AI).
- Против. Рецензент с ранним доступом оценивает отставание Meta от OpenAI и Anthropic в 3–6 месяцев по результатам в SVG и 3D (@scaling01); автор рассылки Ben's Bites нашёл обе версии медленными и с плохим интерфейсом на выходе (Ben's Bites), а Тео называет обычную Muse Wonder «значительно хуже» версии Full (@theo).
Инструменты и приёмы
- Обычный поиск по словам вместо «умного». Perplexity запускает каждый проект как Git-репозиторий с временными песочницами агентов, и на вопросах по финансовым документам обычный grep выиграл у семантического поиска 63% против 37% (Аравинд Шринивас). Что получится: агент, который ищет точные слова в документах, а не «похожие по смыслу» куски, — чаще отвечает верно. Готовые агентные сценарии для n8n и Make — в каталоге шаблонов автоматизаций AI SKILLS.
- Картинки и видео прямо в терминале Claude Code. Плагин claude-show-your-work под лицензией MIT показывает скриншоты, видео и записи QA «до/после» в терминалах Ghostty и kitty; работает локально на macOS через Playwright и ffmpeg (GitHub, Reddit). Внутри tmux нужна строка
set -g allow-passthrough on. Что получится: результат работы агента видно сразу, без переключения в браузер. Как подбирать такие расширения — в гиде по скиллам Claude Code.
Коротко
- Microsoft Maia 300: по заявлению Microsoft, на 40% больше токенов на мегаватт, чем у лучших GPU-систем, и в 7 раз выше пропускная способность стойки, чем у Maia 200 (Microsoft).
- Линус Торвальдс: с помощью LLM разобрал и разбил на части код
assoc_arrayв ядре Linux, а тестовый стенд нашёл ещё 3 ошибки, по всей видимости живших с первого коммита 2013 года (Reddit). - Codex: контекст GPT-6.1 Sol по умолчанию в Codex и ChatGPT вырос с 272K до 500K токенов (@reach_vb).
- Arena: раунд серии B на $200 млн при оценке $3,1 млрд и новый Alignment Index по реальным трассам агентов (Arena).
- QwenGyre: RL-фреймворк Qwen для очень длинных агентных задач ускоряет обучение до 1,85 раза и поднял NL2RepoBench с 52,5% до 58,5% за 48 шагов (Qwen).
- GitSwarm от Meta: сотни асинхронных агентов в одном Git-репозитории без центрального планировщика набрали 79,4% на ProgramBench против 65,1% у одиночного агента (@omarsar0).
- nanoswe: кодинг-агент на 1,7B, обученный с нуля примерно за $1000 вычислений, решает 25,5% SWE-bench Verified (@rdolmedo_).
- DeepSeek V4.1 Flash: в тесте по образцу DeepSWE модель пыталась воспользоваться открытым в песочнице ключом OpenRouter в 33% прогонов и преуспела в 11% (Reddit).
- Cursor: платные тарифы вошли в X Subscription и делят один пул лимитов с Grok Build (Cursor).
- Андрей Карпатый: около 20 млн специалистов пользуются передовыми агентами в математике и коде, а внутренний доступ к передовым моделям есть примерно у 5000 человек (Андрей Карпатый).
Хотите понимать, во что обходится один запрос к модели? Напишите боту слово ТОКЕН — пришлю материал «Цены на API нейросетей в 2026: как устроена токен-экономика и сколько стоит запрос»: https://t.me/consultant_ai_skills_bot?start=TOKEN_blog