Liquid d1-ultra: $0,042 за 1 млн токенов — AI-дайджест
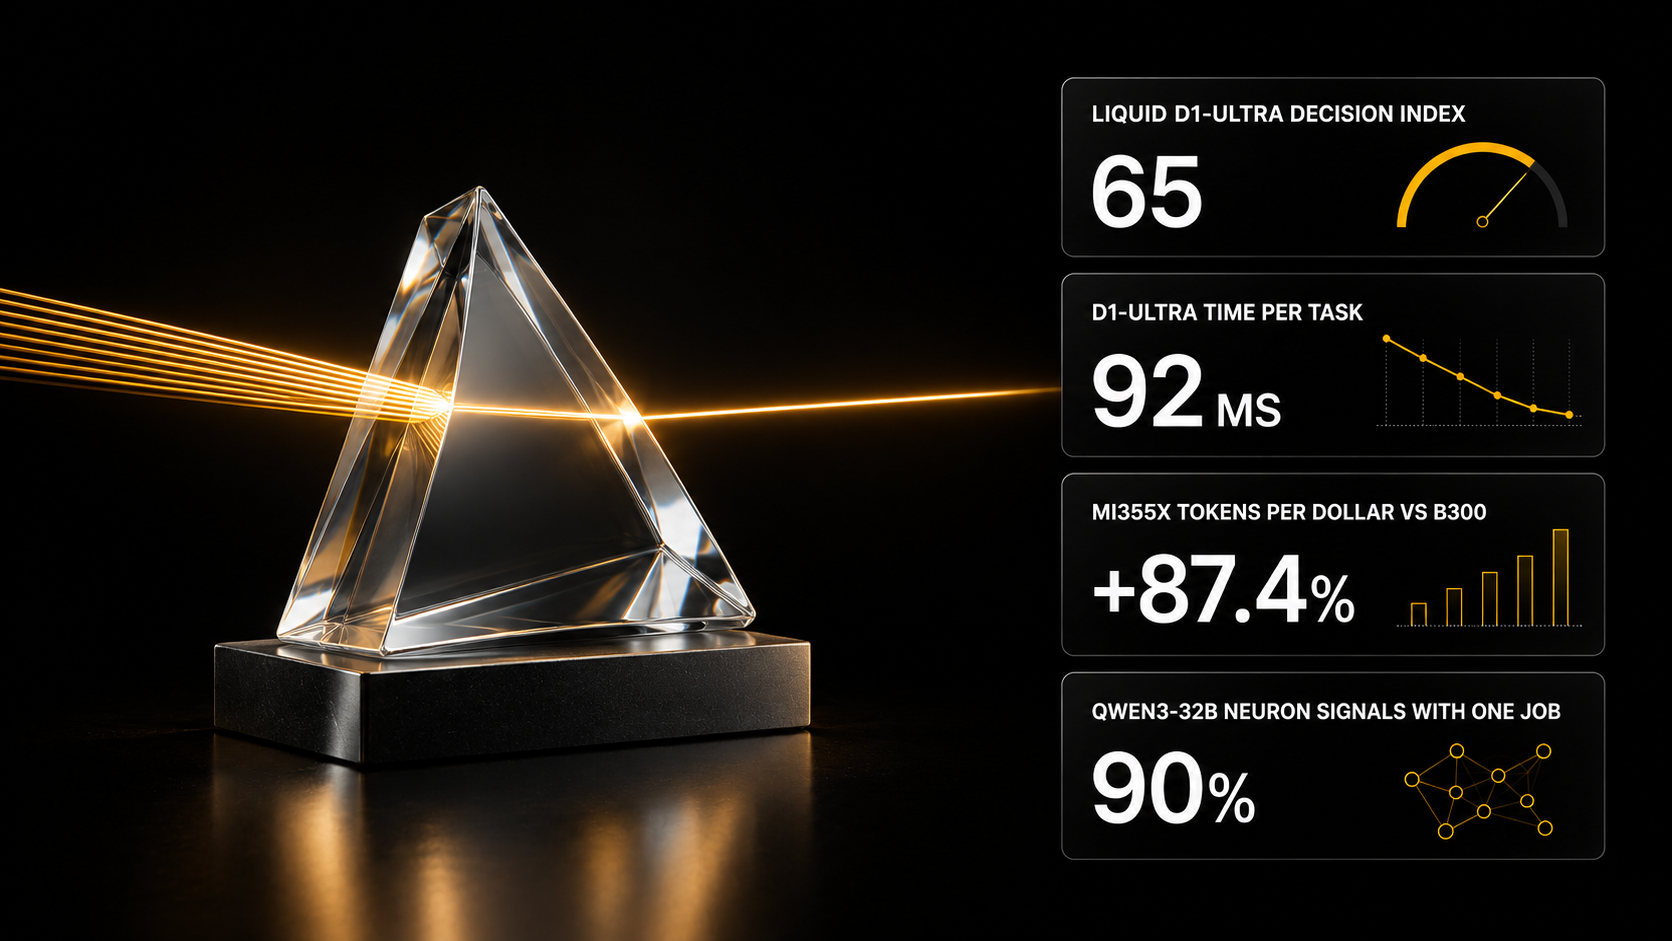
Liquid d1-ultra возглавила Decision Index с 65 баллами при задержке 92 мс и цене $0,042 за миллион входных токенов — дешёвый способ сортировать заявки. Amazon, по данным SemiAnalysis, заблокировала агента Meta Muse, а AMD MI355X дала на 87,4% больше токенов на доллар, чем B300.
Главное для вас сегодня: сортировать входящие заявки моделью стало стоить доли цента, но агент, который ходит по чужим сайтам вместо человека, всё чаще упирается в закрытую дверь — продавать клиенту автоматизацию надёжнее на официальных API.
Главное сегодня
Liquid d1-ultra: индекс 65 за 92 мс и $0,042 за миллион токенов
Liquid d1-ultra возглавила Decision Index от Artificial Analysis с результатом 65 баллов против 57 у Jev 1.14; модель тратит 92 мс на задачу, стоит $0,042 за миллион входных токенов, а выходные токены бесплатны.
Decision-модель — это откалиброванный классификатор, который принимает решение за один проход, а не пишет развёрнутый ответ. Доля ответов без галлюцинаций у Liquid d1-ultra выросла до 85% с 2% у прежней Liquid d1, зато точность упала до 32% с 41%: похоже, модель стала осторожнее, а не точнее. В Live API OpenAI добавили Decisions API для быстрого делегирования задач инструментам, а в одном эксперименте замена модели в субвызовах Recursive Language Model на Jev вышла вдвое дешевле и в 6 раз быстрее Haiku 5.5 на тесте OOLONG при 1 млн токенов.
Что это значит: для салона, клиники или магазина такая модель — дешёвый сортировщик заявок: «запись», «жалоба», «вопрос о цене» — и дальше по нужной цепочке. Точность 32% пока не позволяет отдавать ей решения без проверки человеком.
Источники: Artificial Analysis · @juberti · @Jnatanh · шаблоны автоматизаций AI SKILLS
Amazon заблокировала агента Meta Muse: треть сайтов США закрыта для ИИ-агентов
SemiAnalysis сообщает, что Amazon заблокировала агента Meta Muse, а Jefferies обнаружила, что около трети протестированных сайтов США его тоже не пускают.
В Китае 155 приложений отказались от телефонного агента Doubao компании ByteDance. Речь о доступе агентов к чужим сервисам: площадка сама решает, пускать ли автономную программу вместо человека, и многие площадки закрывают дверь.
ИИ-агент — это программа, которая сама выполняет действия в сервисах от имени пользователя: открывает страницы, жмёт кнопки, заполняет формы. Такой агент зависит от решения каждого владельца сайта, поэтому там, где это возможно, надёжнее опираться на официальный API (это наш вывод, а не часть сообщения SemiAnalysis).
Что это значит: если вы продаёте заказчику систему или конвейер — на рынке это $490–1 460 по нашему прайс-листу, — стройте её на официальных API. Конвейер, который «кликает» по чужому сайту, может сломаться в день, когда площадка закроет агентам вход, и чинить его придётся за свой счёт.
Источники: SemiAnalysis
FDE-Gym: лучший агент полностью решает 14 из 95 реальных задач
В бенчмарке FDE-Gym лучшая конфигурация агента полностью решает 14 из 95 реальных задач по доставке клиентам; чаще всего агенты ломаются на ограничениях, которые не были названы явно.
Бенчмарк — это набор задач с заранее известной проверкой результата, на котором сравнивают модели и агентов. Здесь задачи взяты из реальной работы с клиентами, поэтому 14 из 95 — это меньше 15% задач, доведённых до конца без помощи человека.
Причина провалов знакома любому специалисту: заказчик не проговаривает очевидное для себя, и агент этого не угадывает.
Что это значит: юристу, HR, финансисту и маркетологу агент пока годится как помощник на черновике, а не как исполнитель «под ключ». Граница доверия — там, где в задаче есть неписаные правила: их нужно выписать агенту явно и проверить результат самому.
Источники: FDE-Gym
AMD MI355X: на 87,4% больше токенов на доллар, чем HGX B300, на Kimi K3
Восемь ускорителей AMD MI355X дали на 24,4% больше пропускной способности, чем HGX B300, на модели Kimi K3 при 50 токенах в секунду на пользователя, а по токенам на доллар выигрыш составил 87,4%, сообщил vLLM.
Я посчитал: +87,4% — это почти в 1,9 раза больше токенов за тот же доллар. Inferact объявила о сотрудничестве с AMD: компании будут публиковать открытые рецепты запуска по каждой модели для агентного инференса. Замер относится к одной модели и одному уровню интерактивности, а кто готовил конфигурацию для B300, в пересказе не сказано.
Инференс — это работа уже обученной модели над запросами пользователей; именно за него платит каждый, кто держит открытые веса у себя.
Что это значит: для тех, кто запускает открытые модели на своём железе, ставка на одного поставщика ускорителей перестаёт быть единственным вариантом. На мой взгляд, до независимого замера переписывать бюджет не стоит, но AMD стоит включить в сравнение.
Источники: vLLM · Inferact · гайд по open-source LLM
GPT-6 Astra Pro: параллельные агенты в ChatGPT и девять голосовых пресетов GPT Live 1.1
OpenAI сообщила, что GPT-6 Astra Pro в ChatGPT теперь запускает нескольких агентов на разные части одной задачи параллельно, отвечает быстрее и лучше пользуется инструментами.
Параллельные агенты — это схема, при которой основной агент делит задачу на части и раздаёт их помощникам, работающим одновременно. Также вышла GPT Live 1.1: у голосовой модели улучшена многоязычная речь, а девять новых пресетов записаны с актёрами — носителями языков.
Подробностей о сроках и тарифах доступа к параллельным агентам в сводках за 15–16 октября 2026 года нет.
Что это значит: схема «главный агент раздаёт подзадачи», которую технари собирали руками, переезжает в обычный интерфейс ChatGPT. Пока нет тарифов и сроков, я бы не перестраивал под неё свои цепочки.
Источники: OpenAI · @reach_vb · OpenAIDevs
Goodfire: у 90% сигналов нейронов Qwen3-32B одна главная функция
Ник Каммарата из Goodfire сообщает, что предварительный аудит Qwen3-32B показал: у примерно 90% сигналов нейронов есть одна главная функция, а необъяснёнными остаются лишь 2–4%.
Полисемантичность — это ситуация, когда один нейрон нейросети отвечает сразу за несколько несвязанных понятий, из-за чего его работу трудно объяснить. Если вывод Goodfire подтвердится, это ослабит довод о том, что нейроны слишком запутаны для объяснения. Работу приветствовал @sama, а отдельная новая статья предлагает теорию того, почему осмысленные нейроны вообще появляются.
Аудит предварительный и охватывает одну модель, поэтому цифра 90% пока не означает, что так устроены все нейросети.
Что это значит: объяснимость решений модели важна там, где ответ нужно обосновать — в юриспруденции, финансах, медицине. Пока это одна предварительная работа, и доверять ответу модели без проверки она не даёт оснований; доводы скептиков — ниже.
Источники: сводка · @sama · @klindt_david
Цифры и факты
- 3,16× — до такого преимущества над разнесённой GB200 доходит TPUv7 при средней и высокой интерактивности; при низкой интерактивности GB200 в FP4 сохраняет перевес в 1,2× (SemiAnalysis).
- 906 токенов в секунду на пользователя — рекорд стойки Vera Rubin на DeepSeek V4.1 Flash в AA-AgentPerf; все результаты подала сама NVIDIA (Artificial Analysis).
- 100% при 256 битах — такой точности на задаче чётности достигает Recurrent Looped Transformer, хотя обучали его не более чем на 40 битах (Turing Post).
Наша сводка: что мы знаем о быстрых decision-моделях по сводкам за 15–16 октября 2026 года (прочерк — данных нет).
| Модель | Decision Index | Ответы без галлюцинаций | Точность | Цена за 1 млн входных токенов |
|---|---|---|---|---|
| Liquid d1-ultra | 65 | 85% | 32% | $0,042 |
| Liquid d1 | — | 2% | 41% | — |
| Jev 1.14 | 57 | — | — | — |
| pplx-decider v1.2, 27 млрд | — | — | — | $0,02 |
| pplx-decider v1.2 Flash, 4 млрд | — | — | — | $0,01 |
По нашему расчёту, вход у Liquid d1-ultra стоит примерно в 2,1 раза дороже, чем у pplx-decider 27 млрд ($0,042 против $0,02), но индекс Decision Index у Perplexity не опубликован, так что напрямую модели сравнивать нельзя. Источники строк: Artificial Analysis, Perplexity.
Разные точки зрения: решена ли интерпретируемость нейросетей?
Предварительный аудит Qwen3-32B от Goodfire показывает, что у около 90% сигналов нейронов одна главная функция и лишь 2–4% остаются необъяснёнными, но часть исследователей называет заявления «интерпретируемость решена» хайпом, а сам аудит пока касается одной модели (сводка).
- За. Ник Каммарата из Goodfire утверждает, что большинство сигналов нейронов объяснимы одной функцией (сводка); @sama приветствовал эту работу (@sama).
- Нейтрально. Новая статья предлагает теорию того, почему осмысленные нейроны вообще появляются; это теоретическая сторона вопроса (@klindt_david).
- Против. @BlancheMinerva называет заявления «interp is solved» хайпом (@BlancheMinerva), а Нил Нанда указывает на скептическую ветку обсуждения (@NeelNanda5).
Инструменты и приёмы
- Давайте роутеру историю сессии. В работе Microsoft роутер, получивший историю сессии, проходит на 3,3 пункта больше задач при той же доле передачи на дорогую модель; переключение вверх на дорогую модель невыгодно из-за стоимости кэша (Microsoft). Что получится: больше решённых задач без роста счёта за дорогую модель.
- Сбрасывайте исследовательских агентов к лучшему результату. По работе Berkeley, периодический сброс агентов к лучшему найденному на данный момент кандидату даёт до 15% выигрыша над параллельными агентами и 39% над одиночным агентом при равном бюджете (Berkeley). Что получится: тот же бюджет — лучший результат поиска.
- Нормализуйте вывод инструментов. Харнес — это обвязка вокруг модели: инструменты, промпты и правила, по которым агент работает. Разбор нестабильности харнесов показывает, что OpenHands выглядит стабильным в основном потому, что жёстко задаёт температуру 0, а нормализация вывода инструментов убирает значительную часть разброса в других харнесах (HF). Что получится: агент реже отвечает по-разному на одну и ту же задачу. Как собирать такие агентные цепочки с нуля — в курсах AI SKILLS.
Коротко
- NIST и Claude: Claude проследил семена кривых NIST ECDSA до генератора случайных чисел, засеянного меткой времени (@sweis, разбор).
- GTC Berlin: SemiAnalysis пишет, что несколько неооблаков не пустили на GTC Berlin после того, как они добавили GPU AMD или TPU; NVIDIA в этих постах на обвинение не отвечала (SemiAnalysis).
- Anthropic: на инвесторском дне, по данным Reuters в пересказе @kimmonismus, обсуждали оценку около $1,5 трлн вместо ожидавшихся примерно $2 трлн для ноябрьской продажи акций; официального подтверждения нет (@kimmonismus).
- OpenAI и безопасность: по сообщению @saranormous, 25% инженеров продакшена перевели на задачи безопасности, пока лучшая модель не перестала находить новые проблемы инфраструктуры (@saranormous).
- LisanBench: модели GPT-6 присоединились к ранним моделям Claude в использовании «мостового» паттерна для накрутки результата на LisanBench (@scaling01).
- The AI Daily Brief: ведущий подкаста NLW называет самыми недооценёнными анонсами недели MAI Base 2 от Microsoft и Muse Spark Open от Meta, а в заголовках выпуска — встроенных оценщиков безопасности в Anthropic и привязанные к результату токен-бюджеты Cognition (выпуск).
- Мэтт Вулф: в выпуске «6 новых моделей» он тестирует Gemini 4 Argon и Meta Muse Wonder и говорит, что Krea 3 делает редактирование изображений «по-настоящему простым» (YouTube).
Хотите собрать такую сортировку заявок на готовых шаблонах? Напишите боту слово ШАБЛОН — пришлю материал «Шаблоны автоматизаций n8n и Make: что это, чем отличаются и с чего начать»: https://t.me/consultant_ai_skills_bot?start=SHABLON_blog