DeepSeek V4.1 Flash: $0,22 вместо $2,35 — AI-дайджест
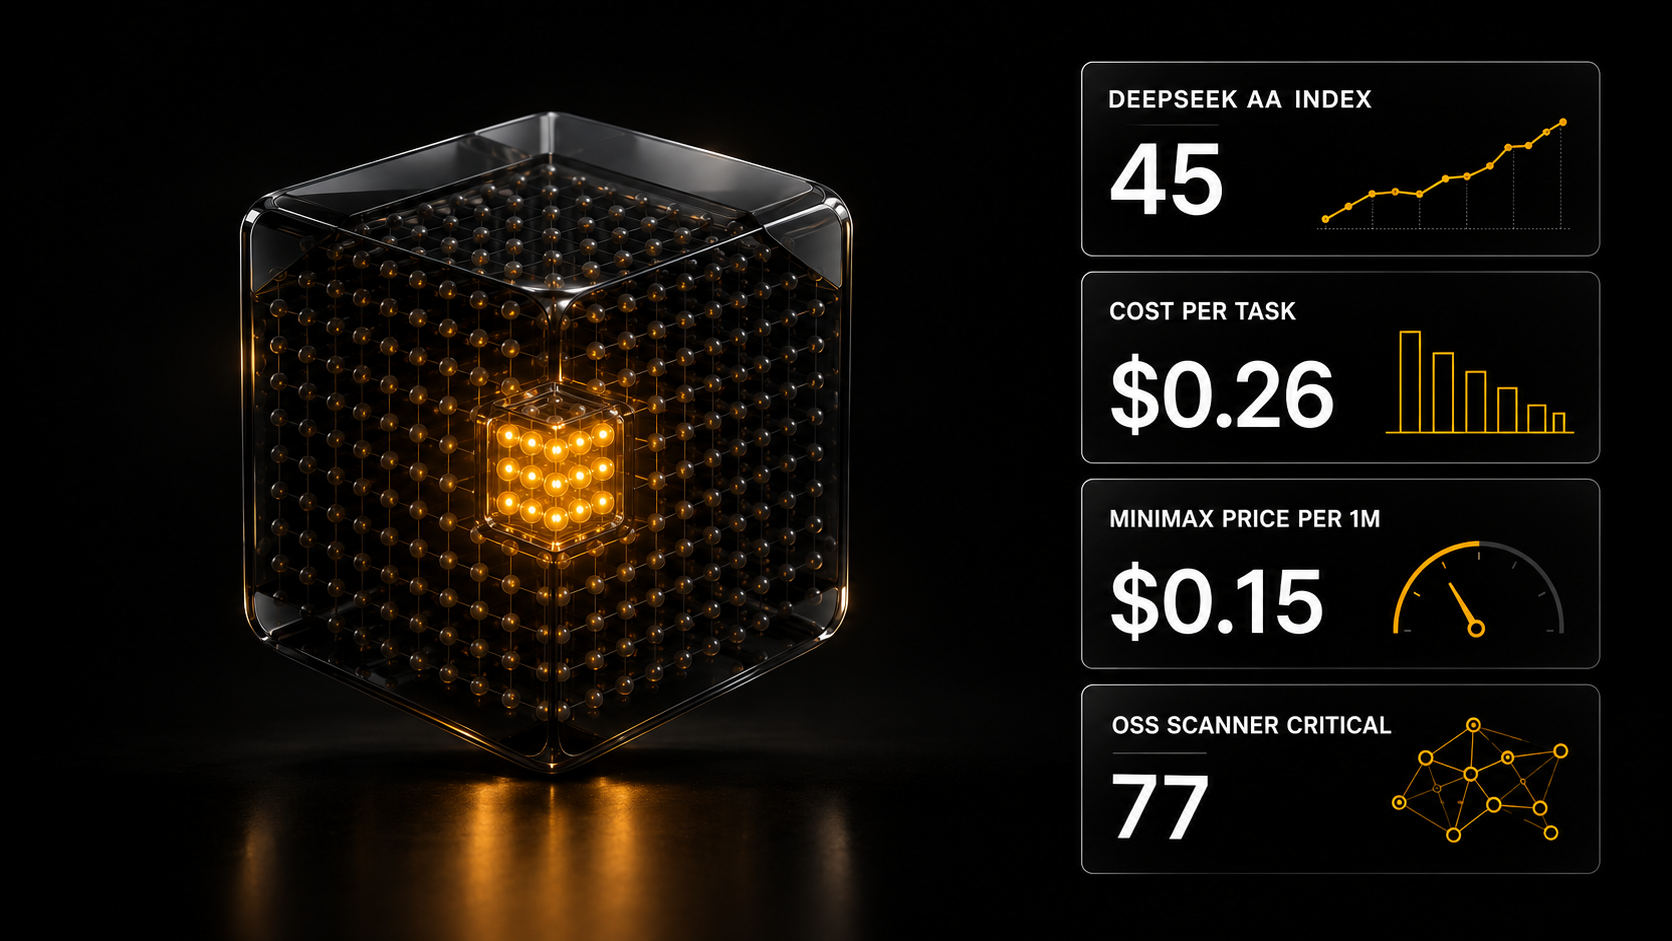
DeepSeek V4.1 Flash 1017 решает долгую задачу в браузере на уровне Opus 5.5, но за $0,22 вместо $2,35 — в десять раз дешевле. Плюс 10-секундный ролик FLUX 3 Max примерно за $1,70, MiniMax M3.1 Flash с 93% галлюцинаций, Google Harness² и Anthropic OSS Scanner.
Главное для вас сегодня: 21 октября 2026 года цена работы ИИ снова упала в разы — открытая модель делает задачу агента в десять раз дешевле флагмана, а 10-секундный ролик стоит меньше двух долларов. Считать теперь надо цену задачи и долю ошибок, а не цену токена.
Главное сегодня
DeepSeek V4.1 Flash 1017: $0,22 вместо $2,35 за задачу — в десять раз дешевле Opus 5.5
DeepSeek выпустила DeepSeek V4.1 Flash 1017 — открытую модель под лицензией MIT, которая в долгих задачах управления браузером набрала 75 из 100, столько же, сколько Opus 5.5, но за $0,22 против $2,35 за задачу.
Цена токенов не изменилась: $0,30 за миллион входных и $1,20 за миллион выходных в часы пик, вне пика вдвое дешевле. В индексе Artificial Analysis модель набрала 45 баллов (+6), делит второе место среди открытых весов с GLM-5.3 и стоит $0,26 за задачу. Доля ответов без галлюцинаций в тесте AA-Omniscience выросла с 4% до 33%, в Code Arena WebDev — 1670 очков и первое место среди открытых моделей.
MoE-модель — это модель, у которой на каждый запрос работает только часть параметров: у DeepSeek V4.1 Flash 1017 активны 16 млрд из 552 млрд, контекст — 1 млн токенов.
Что это значит: все сравнивают цену токена — считать надо цену задачи. $2,35 / $0,22 ≈ 10,7: агент, который ходит по сайтам, в этом тесте обходится в десять раз дешевле при том же результате.
Источники: Artificial Analysis · детали · Arena · browser_use · гид по open-source LLM
FLUX 3 Max: 10-секундный ролик примерно за $1,70 и 12 секунд
Видеомодель FLUX 3 Max от fal и BFL делает 10-секундный ролик примерно за 12 секунд по цене $10,20 за минуту видео в 720p, по замеру Artificial Analysis.
Я посчитал на 10 секунд: $10,20 / 60 × 10 = $1,70 за ролик в 720p. Генерация занимает примерно столько же времени, сколько длится сам ролик: 12 секунд на 10 секунд видео.
Цена за минуту — это тариф одной генерации; каждый переделанный дубль оплачивается заново, поэтому себестоимость готового ролика выше $1,70.
Что это значит: работа на заказ. По ленте заказов (5 986 заказов за 4 месяца) короткий ролик на рынке стоит $18–45, изображение или монтаж — $12–35. При себестоимости одной генерации около $1,70 цена работы складывается не из генерации, а из идеи, отбора дублей и монтажа — за это и платят.
Источники: Artificial Analysis · прайс-лист исполнителя
MiniMax M3.1 Flash: $0,15 за миллион токенов, но 93% галлюцинаций
MiniMax представила MiniMax M3.1 Flash по $0,15/$0,60 за миллион входных/выходных токенов и пообещала открыть веса 23 октября 2026 года.
По заявлению MiniMax, модель втрое быстрее M3, стоит втрое меньше и набирает 74% в DeepSWE. Независимый замер Artificial Analysis дал 42 балла индекса — вровень с GLM-5.3-Flash и ниже 45 у DeepSeek V4.1 Flash 1017, около $0,22 за задачу. Анонимная модель «Space Bunny», возглавлявшая рейтинги использования, оказалась ранней сборкой MiniMax M3.1 Flash.
Галлюцинация — это уверенный ответ модели, не подкреплённый фактами. Доля галлюцинаций у MiniMax M3.1 Flash — 93%: модель пытается ответить почти на каждый вопрос, а не признаёт незнание.
Что это значит: профессия и доверие. Юристу, финансисту и HR такая модель годится на черновик и пересказ, но не на факты, даты и цифры — она почти никогда не скажет «не знаю». Экономия $0,04 на задаче против DeepSeek не окупает проверку каждого ответа.
Источники: MiniMax · Artificial Analysis · r/LocalLLaMA
Итан Моллик: 180 моделей сильнее GPT-4, ответ подешевел в 750 раз
Итан Моллик в эссе к выходу книги Co-Existence 20 октября 2026 года подсчитал, что 180 ИИ-моделей превосходят GPT-4 образца его релиза, и девятнадцать из них запускаются на современном смартфоне.
По бенчмарку METR Long Horizon объём работы, который ИИ выполняет с одного промпта с успехом не ниже 50%, со времён GPT-4 удвоился восемь раз: в 2024 году — задача на 4 минуты, к апрелю 2026 года — 17 часов человеческой работы, после чего METR признала, что мерить больше не может. Правильный ответ на экзамене GPQA, по Моллику, подешевел с 30 центов до четырёх сотых цента: 30 / 0,04 = 750 раз.
Что это значит: бизнес. Задачу на многие часы работы сотрудника уже можно отдать ИИ одним промптом, но мерка METR — успех в половине случаев. Отдавать долгие задачи можно, проверку результата стоит оставить за человеком.
Источники: One Useful Thing
Google Harness²: агент сам правит свой харнес и даёт +8,4 пункта Gemini 3.5 Flash
Google Research открыла код Harness² под Apache 2.0 — фреймворка, в котором агент редактирует собственный харнес, пока веса модели остаются замороженными; Gemini 3.5 Flash прибавила 8,4 пункта в WorkBuddy-Bench и 7,5 в JobBench.
Около 50% правок пришлись на скиллы и скрипты. В Harness² агент-редактор предлагает правки, композитор сравнивает траектории с базовой версией, а рефлектор сохраняет уроки на будущие задачи; отдельный оценщик не нужен.
Харнес — это обвязка вокруг модели: системный промпт, скиллы, хуки, память и инструменты, через которые агент действует. Как кухня вокруг повара: повар тот же, а блюда лучше. Скептики на Reddit предупреждают, что самоулучшающийся харнес может подгоняться под бенчмарк и съедать контекст локальных моделей.
Что это значит: для технаря. Прибавку дала не новая модель, а переписанная обвязка, и половина её — в скиллах. Прежде чем менять модель, стоит пересобрать скиллы и инструкции агента.
Источники: akshay_pachaar · _philschmid · google-research/harness2 · r/LocalLLaMA · гид по скиллам Claude Code
Anthropic OSS Scanner: 77 критических уязвимостей в открытом коде за первую неделю
Anthropic запустила OSS Scanner — бесплатное регулярное сканирование критичных open-source проектов на уязвимости с доказательствами эксплуатации и патчами; за первую неделю модель оценила 77 находок как критические и 803 как высокие, среди исправлений — патч для curl.
Запуск совпал с инцидентом: команда OpenCode сообщила о непрерывной 48-часовой атаке роёв агентов. Посреди инцидента передовые модели отказывались помогать разбирать атаку, потому что вредоносные нагрузки срабатывали на их защитные фильтры. Ситуация, по сообщениям, улучшилась после того, как OpenCode получила доступ к Daybreak Blue.
Защитный фильтр — это правило модели, по которому она отказывается работать с опасным содержимым; в инциденте OpenCode фильтры не отличили разбор атаки от опасного запроса.
Что это значит: для технаря. Модель-защитник должна уметь читать вредоносный код, иначе в момент атаки она бесполезна. Если ваш проект на открытых библиотеках, проверьте, какие из них уже попали в сканирование.
Источники: ClaudeDevs · thdxr · AndrewCurran_ · kimmonismus
Muse Glimmer 30B и Nemotron 3.5 Bolt: открытые модели на одной видеокарте в 24 ГБ
Meta выпустила Muse Glimmer — открытую агентную модель на 30 млрд параметров, рассчитанную на запуск в 4 битах на одной потребительской видеокарте.
NVIDIA Nemotron 3.5 Bolt (74B всего / 9B активных) помещается примерно в 23,75 ГБ видеопамяти вместе с визуальным модулем. LiquidAI LFM2.5-24B-A2B участники Reddit хвалят как сильную локальную модель для кода.
Запуск в 4 битах — это квантование: веса модели хранятся грубее, поэтому она занимает в несколько раз меньше памяти ценой небольшой потери точности.
Что это значит: бизнес. Клиника или юридическая контора, которой нельзя отправлять документы во внешний сервис, получает модели, которые работают на одном компьютере с одной видеокартой — данные не уходят наружу.
Источники: AIatMeta · r/LocalLLaMA · LFM2.5-24B-A2B · Open Source на AI SKILLS
Цифры и факты
Собственная сводка: дешёвые модели недели по данным Artificial Analysis и заявлениям разработчиков на 21 октября 2026 года.
| Модель | Цена за 1 млн токенов (вход/выход) | Индекс AA | Цена задачи | Веса |
|---|---|---|---|---|
| DeepSeek V4.1 Flash 1017 | $0,30 / $1,20 | 45 | $0,26 | открыты, MIT |
| MiniMax M3.1 Flash | $0,15 / $0,60 | 42 | ~$0,22 | обещаны на 23.10.2026 |
- +43–85% запросов в секунду — прирост от многопроцессных API-воркеров в vLLM v0.32.0, релизе из 814 коммитов (vllm_project).
- +50 ГВт мощностей дата-центров в 2027 году прогнозирует SemiAnalysis; ещё 60 ГВт строится, аренд подписано на $1,3 трлн (SemiAnalysis).
- Около $1 млрд вычислений на обучение теперь свободно скачивается с Hugging Face Hub — против менее $40 млн в конце 2023 года (Thom_Wolf).
- 60 из 65 проверенных задач Terminal-Bench содержали проблемы, 44 можно было пройти жульничеством (chem_safety).
Разные точки зрения: дистилляция ли объясняет близость китайских моделей к лидерам?
Китайские открытые модели вроде DeepSeek V4.1 Flash 1017 отстают от закрытых лидеров на считаные пункты при цене задачи в разы ниже, и спор идёт о том, насколько этот разрыв сокращён дистилляцией — обучением на ответах чужих, более сильных моделей.
- За. Дин Болл, ныне сотрудник OpenAI, пишет, что дистилляция играет в бенчмарковой близости Китая большую роль, чем он думал (deanwball).
- Нейтрально. Часть исследователей просит лаборатории опубликовать доказательства, на которых строятся обвинения в дистилляции (ziv_ravid).
- Против. Скептики отвечают, что тяжёлое дообучение на чужих трассах обычно повышает галлюцинации, а у DeepSeek V4.1 Flash 1017 они, наоборот, резко упали в AA-Omniscience (teortaxesTex).
Инструменты и приёмы
- Кладите ограничение в рассуждение, а не в запрос. Модели с рассуждением заметно лучше соблюдают условие, если оно записано в цепочке рассуждений как самоинструкция, а не в пользовательском промпте (dair_ai). Что получится: меньше ответов, которые нарушают ваше условие по объёму, тону или формату; готовые формулировки — в библиотеке промптов AI SKILLS.
- Запустите DeepSeek V4.1 Flash 1017 локально. Unsloth выложила динамические GGUF-кванты и рекомендует свою ветку llama.cpp; в обсуждении на Reddit пользователь запустил 366-гигабайтную сборку ds4 GGUF на MacBook с M5 Max и 128 ГБ памяти со скоростью около 15 токенов в секунду (Hugging Face, r/LocalLLaMA). Что получится: модель уровня второго места среди открытых весов без оплаты API.
Коротко
- Mercury 3: Inception выпустила диффузионную языковую модель со скоростью более 1000 токенов в секунду и контекстом 1 млн токенов на Baseten (StefanoErmon, Baseten).
- Muse Wonder Full (Max): модель Meta дебютировала на 6-м месте Code Arena WebDev с 1726 очками (Arena).
- Indra OCR 1.1: модель на 1 млн параметров распознаёт 44 страницы в секунду на CPU (VikParuchuri).
- Anthropic Public Benefit Fund: фонд стартует с 5% акций Anthropic, с обещаниями основателей и сотрудников на общее благо направлено около 20% капитала (AnthropicAI).
- Запрет DeepSeek в госведомствах США: приказ DHS 2026-01 требует убрать продукты DeepSeek из систем гражданских агентств, на запросы исключений дано 60 дней (r/LocalLLM).
- Экспорт весов из Китая: проект правил требует разрешения властей на вывоз весов моделей больше 2 трлн параметров или 10^26 FLOPs (kimmonismus).
- Замена git в Anthropic: семь человек за пять месяцев сделали внутреннюю замену git, когда число слияний выросло с 2500 до более чем 30 000 в день (dl_weekly).
- Busy Beaver: агент DeepMind на Gemini нашёл и проверил в Lean правила ускорения для 11 нерешённых машин BB(6) (omarsar0).
Хотите понимать, сколько на самом деле стоит запрос к модели? Напишите боту слово ТОКЕН — пришлю разбор цен на API нейросетей в 2026 году: как устроена токен-экономика и сколько стоит запрос: https://t.me/consultant_ai_skills_bot?start=TOKEN_blog