Mistral Voxtral 3: $13 за 1М знаков — AI-дайджест
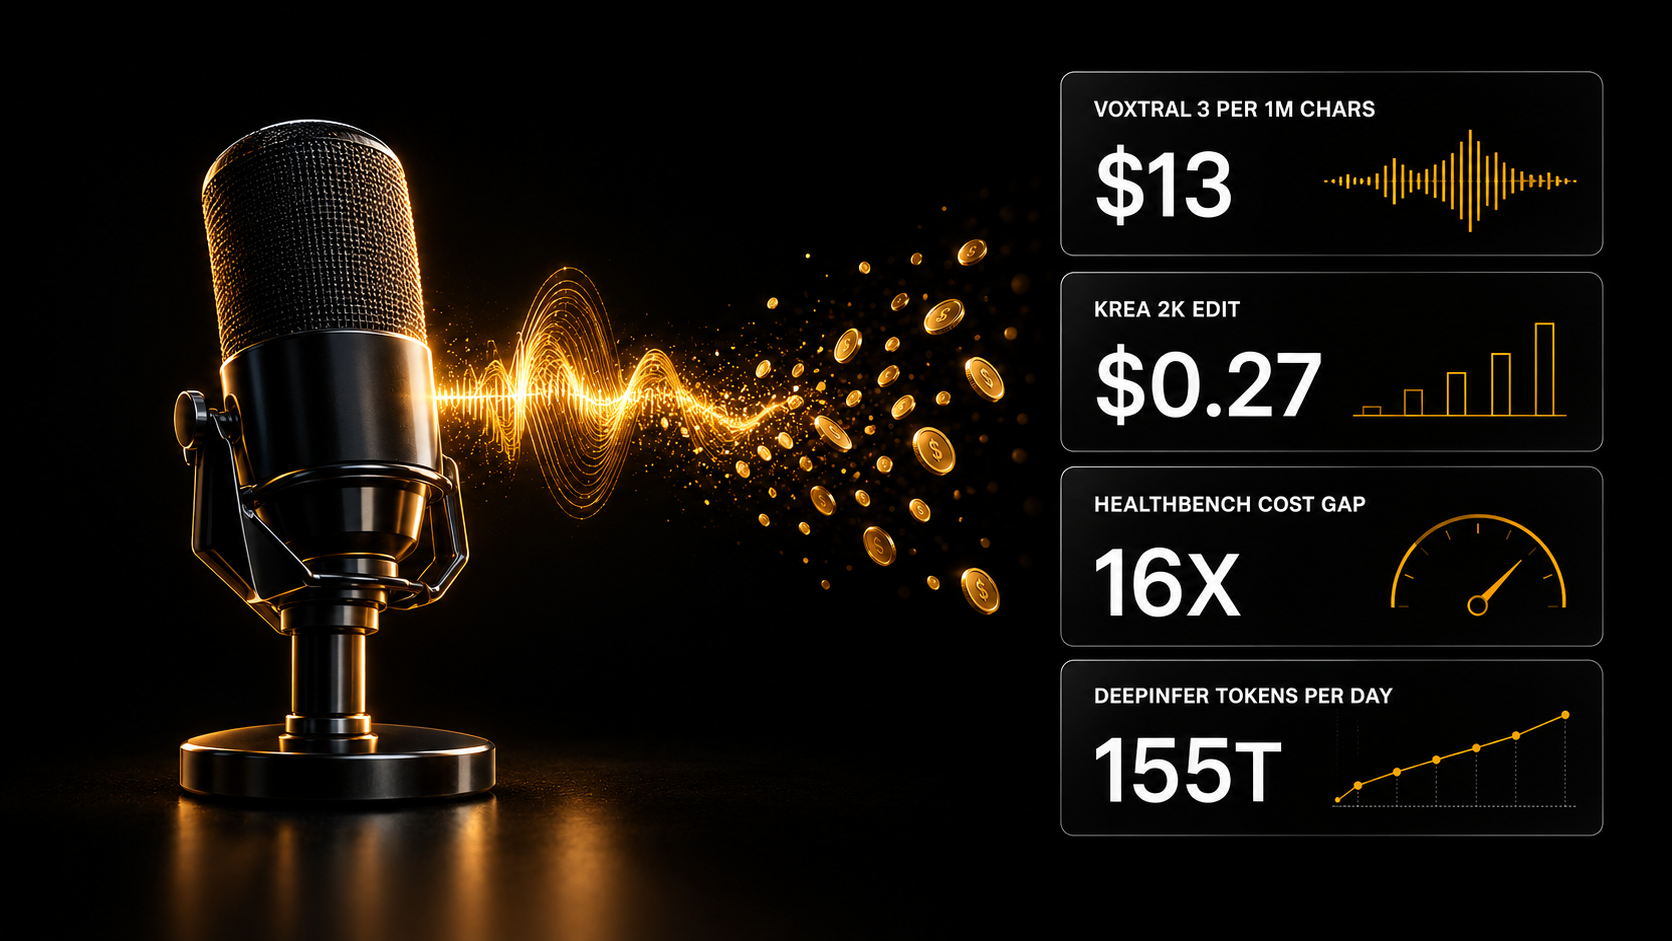
Mistral Voxtral 3 озвучивает минуту речи примерно за цент, Krea правит картинку в 2K за $0,27, DeepSeek V4.1 Flash почти догнал Sonnet 5.5 в медицинском тесте при цене в 16 раз ниже, а Perplexity Computer заработал локально на Mac.
Главное для вас сегодня: 20 октября 2026 года голос и картинка подешевели до центов — минута синтезированной речи у Mistral стоит около цента, правка изображения в 2K у Krea — 27 центов. Деньги в заказе теперь не за генерацию, а за сценарий, отбор и сдачу результата.
Главное сегодня
Mistral Voxtral 3: озвучка по $13 за миллион знаков — минута речи около цента
Mistral выпустила Voxtral 3 — набор моделей для расшифровки, многоязычного синтеза речи и голосовых агентов; синтез стоит $13 за миллион знаков, по замеру Artificial Analysis.
Модель синтеза выдаёт 112,3 знака в секунду и вошла в топ-12 обеих голосовых арен. Small Transcribe 3 заняла третье место по точности расшифровки с 2,1% ошибок в словах. Модели доступны через API Mistral или на собственных серверах заказчика, к ним прилагается SDK для голосового агента с вызовом инструментов.
Синтез речи (TTS) — это превращение текста в голос. Я посчитал: минута речи — примерно 1 000 знаков, $13 / 1 000 000 × 1 000 ≈ $0,013 за минуту озвучки.
Что это значит: работа на заказ. По ленте заказов (5 986 заказов за 4 месяца) короткий ролик стоит $18–45, монтаж — $12–35. Озвучка в такой цене — уже не статья расходов: платят за текст, темп и сведение со звуком.
Источники: Mistral · Guillaume Lample · Artificial Analysis · замер скорости · прайс-лист исполнителя
Krea 3 Ultra и Bria Fibo 2.0: правка картинки в 2K за $0,27, генерация за 3 цента
Krea выпустила Krea 3 Ultra: правка изображения в 2K с одним референсом стоит $0,27; Bria открыла семейство Fibo 2.0 на 8 млрд параметров с ценой API $32 за 1 000 изображений.
$32 / 1 000 = $0,032 за картинку у Fibo 2.0. Krea 3 Ultra работает только в 2K, быстрая версия стоит $0,03 за выходное изображение в 1K плюс $0,02 за каждый референс в 1K. По Artificial Analysis Fibo 2.0 лидирует среди открытых моделей в редактировании, Krea 3 Ultra — пятая, на Arena — четвёртая в правке по нескольким картинкам.
Открытые веса — это модель, которую можно скачать и запустить у себя. У Fibo 2.0 веса некоммерческие: продавать работу на них без отдельного договора с Bria нельзя.
Что это значит: работа на заказ. Изображение на рынке стоит $12–35 при себестоимости правки около $0,27 — платят за отбор и доводку. Для коммерческих заказов берите API Bria, а не скачанные веса.
Источники: Artificial Analysis о Fibo 2.0 · Artificial Analysis о Krea 3 · Arena · генератор промптов для изображений
HealthBench: DeepSeek V4.1 Flash отвечает на медицинские вопросы в 16 раз дешевле Sonnet 5.5
Artificial Analysis запустила рейтинги HealthBench — 5 000 бытовых медицинских диалогов и 525 диалогов с врачами; DeepSeek V4.1 Flash набрала 60,9% по $0,005 за задачу, Claude Sonnet 5.5 — 62,1% по $0,08.
$0,08 / $0,005 = 16: разница в качестве — 1,2 пункта, в цене — в 16 раз. В профессиональной части GPT-6 Astra лидирует с 66,0% после поправки на длину ответа. Opus 5.5 набрала больше всех без поправки — 71,4%, но с поправкой опустилась до 59,9%.
Поправка на длину — это пересчёт баллов, при котором модель не может выиграть одним объёмом ответа. Оценивают ответы модели OpenAI, как в исходном тесте.
Что это значит: профессия и доверие. Врачу и клинике длинный ответ модели кажется полным, но в рейтинге он теряет до 11,5 пункта. Решение по пациенту остаётся за врачом.
Источники: Artificial Analysis · нейросети в медицине: что можно отдать
Perplexity Computer: агент работает на Mac целиком, без интернета и без оплаты кредитами
Perplexity перенесла Perplexity Computer на компьютеры Mac с Apple silicon: модель и агент работают локально, в том числе без интернета, с приложениями и файлами на диске.
Локальные задачи выполняет PPLX Pro — дообученная версия Qwen 3.8; кредиты Computer на них не тратятся. Режим доступен подписчикам Pro, Max и Enterprise, рекомендуют 36 ГБ общей памяти. Есть и гибридный режим, где работа делится между локальной и облачной моделью.
Локальный запуск — это работа модели на вашем компьютере: документы не уходят на чужие серверы. В гибридном режиме это обещание уже не действует целиком — часть данных уходит в облако.
Что это значит: бизнес. Юридической конторе или клинике, которой нельзя отправлять документы во внешний сервис, подойдёт только полностью локальный режим: Mac с 36 ГБ памяти и подписка Pro — без оплаты за каждую задачу.
Источники: Perplexity · модель · требования · Open Source на AI SKILLS
DeepSeek DeepInfer: открытый движок, который обслуживает 155 трлн токенов в сутки
DeepSeek открыла DeepInfer — движок, на котором работает DeepSeek V4.1 Flash; по отчёту компании, один кластер обслуживает 155 трлн токенов в сутки с 96% попаданий во входной кэш и приносит $38 выручки на ускоритель в час по ценам вне пика.
Первый токен приходит в среднем через 400 мс, генерация идёт со скоростью 230 токенов в секунду, на коде — до 300. Кэш промптов хранится в отдельном кластере на 100 ПиБ: три дня для агентов, семь дней для чата. Команда vLLM повторила декодирование в той же конфигурации на GB200 с отставанием не больше 6%.
Кэш промптов — это сохранённое начало запроса: агент повторно шлёт ту же историю, а модель не пересчитывает её заново. Поэтому 155 трлн — не новые токены, а в основном повторы из кэша.
Что это значит: для технаря. Управление кэшем и балансировка нагрузки пока не открыты — повторить сервис целиком нельзя, но vLLM уже выложила рецепты, которые повторяют скорость декодирования.
Источники: DeepSeek · технический разбор · vLLM · GitHub · цены на API нейросетей
Vals Router Index: все пять роутеров проиграли отдельным моделям и по качеству, и по цене
Vals проверила пять роутеров — сервисов, которые сами выбирают модель под запрос, — на 1 250 задачах; каждый проиграл хотя бы одной отдельной модели и по баллам, и по цене.
Если бы выбор модели под каждую задачу делался задним числом в том же бюджете, баллы выросли бы на 8–27 пунктов: потенциал у маршрутизации есть, но нынешние роутеры его не используют. В узкой задаче картина другая: на ClaimBench, классификации финансовых документов, Decider V1.2 сам обработал 99,7% заявок и передал остальное в Haiku 5.5 — 99,9% точности за $0,11 на 1 000 заявок против $1,19 у одной Haiku.
$1,19 / $0,11 ≈ 10,8 раза.
Что это значит: бизнес. Бухгалтерии или страховой, которая разбирает поток однотипных документов, каскад «дешёвая модель + сильная на сложные случаи» обходится в десять раз дешевле. Для разнородных задач роутер пока лучше заменить одной хорошей моделью.
Источники: Vals Router Index · сравнение с оптимумом · ClaimBench · каскад · шаблоны автоматизаций
PyTorch 2.15 на Mac: MoE-модели декодируют в 5–6,5 раза быстрее
PyTorch 2.15 заменил часть путей MPSGraph на ядра Metal: декодирование MoE-моделей на Apple silicon ускорилось в 5–6,5 раза, Qwen3.6-35B-A3B на M3 Ultra — с 9,4 до 61,3 токена в секунду.
Появилась поддержка FP8 на MPS, а пиковая память драйвера у VAE модели Wan2.2 упала примерно с 270 ГиБ до 8 ГиБ. Улучшения вошли в сам PyTorch, а не в отдельную программу для запуска моделей.
MoE-модель — это модель, у которой на каждый запрос работает только часть параметров: у Qwen3.6-35B-A3B активны около 3 млрд из 35 млрд.
Что это значит: для технаря. На M3 Ultra открытая MoE-модель теперь отвечает со скоростью, при которой с ней можно работать в чате, — 61 токен в секунду против 9 раньше.
Источники: LysandreJik · гид по открытым LLM
Цифры и факты
Собственная сводка: сколько стоят голос и картинка по данным на 20 октября 2026 года.
| Что делаем | Модель | Цена | В задаче |
|---|---|---|---|
| Озвучка текста | Mistral Voxtral 3 | $13 за 1 млн знаков | ≈ $0,013 за минуту речи |
| Картинка по описанию | Bria Fibo 2.0 (API) | $32 за 1 000 изображений | $0,032 за картинку |
| Правка картинки в 2K | Krea 3 Ultra | $0,27 с одним референсом | $0,27 за правку |
| Медицинский ответ | DeepSeek V4.1 Flash | $0,005 за задачу | 60,9% в HealthBench |
- $0,20 — медианная цена задачи у DeepSeek V4.1 Flash 20261017 Max в Agent Arena; модель первая среди открытых и 11-я в общем зачёте по 7 500+ реальным сессиям (Arena).
- Около 1 000 токенов в секунду на пользователя на GB300 NVL72 дала поддержка мегаядер в SGLang по замеру SemiAnalysis (SemiAnalysis).
- С 178,8 до 64,6 секунды Zyphra сократила время до первого токена у GLM-5.3 на контексте 512 тыс. токенов на AMD MI355X (Zyphra).
- 1,9 млн параметров у самой маленькой Pocket TTS от Kyutai — по заявлению разработчиков, в 103 раза быстрее реального времени на одном ядре процессора (Kyutai).
- На 6,4% выше в среднем лаборатории публикуют баллы своих моделей, чем независимые тестировщики, по 611 сопоставлениям 180 моделей (r/LocalLLaMA).
Разные точки зрения: зарабатывает ли DeepSeek 80% на каждом ответе модели?
DeepSeek раскрыла выручку $38 на ускоритель в час по ценам вне пика, но не назвала ни модель видеокарты, ни её стоимость; расчёты маржи от 74% до 96% зависят от цены аренды и не включают кластер SSD для кэша, процессоры, сеть и простой.
- За. Автор самой популярной оценки после поправки на фактические $38 в час вместо идеальных $49 насчитал маржу 84,2–96,1% (zephyr_z9).
- Нейтрально. Юйчэнь Цзинь получает около 81,6% при аренде за $7 в час, но подчёркивает, что DeepSeek не раскрыла, на каком железе получена выручка (Yuchenj_UW); при $5–10 в час диапазон — 73,7–86,8% (swyx).
- Против. Скептики напоминают, что цены на токены падают, а вычисления дорожают, и такая доходность со временем сожмётся (teortaxesTex).
Инструменты и приёмы
- Не давайте агенту доступ к почте и диску без подтверждения каждого действия. Пользователи Dots предупреждают: агент, подключённый к Gmail и Google Drive, может выполнить инструкцию из чужого письма или вложения (r/ChatGPT). Промпт-инъекция — это скрытая команда в тексте, который агент читает как свою задачу (OWASP). Что получится: агент читает и пишет черновики, а отправляет и удаляет только после вашего «да».
- Отдайте ИИ проверку своих расчётов, а не сами расчёты. Физик Э. О. Кахья разбил аудит своей старой работы по квантовой гравитации на 18 задач в 9 этапов; Claude прогнал выкладки через SymPy и mpmath, нашёл ошибку знака, пропущенное слагаемое и 23 опечатки, а главный вывод работы остался в силе (GitHub, r/singularity). Что получится: юрист, финансист или инженер проверяет длинный документ за вечер, а не за неделю.
- Включите 12-часовой кэш промптов в API OpenAI для долгих агентов. Его можно смешивать со стандартным 30-минутным в одном запросе; хранение дольше стоит дороже, но окупается, если агент возвращается к одному контексту через часы (OpenAIDevs, настройка). Что получится: агент, которого вы оставили на обед, не пересчитывает заново всю историю.
Коротко
- Лимиты OpenAI: компания нашла около 40 000 аккаунтов, у которых действующие лимиты не совпадали с выбранным тарифом, исправила ошибку и пообещала компенсацию кредитами (thsottiaux).
- Связыватели токсина скорпиона: Anthropic и Citrini получили 17 связывающих белков из 211 проверенных дизайнов; ни один не проверяли на нейтрализацию токсина, это не противоядие (AnthropicAI, оговорка).
- Opus 5.5 прошёл Baldur's Gate 3: за 39 часов, $712 и 20 809 вызовов инструментов модель сама закончила игру (r/ClaudeCode, разбор автора).
- Arda: бывший руководитель исследований OpenAI Боб МакГрю запустил софт для производства, раунд A — $160 млн при оценке $1,5 млрд (bobmcgrewai).
- Orchestra Bio: OpenAI покупает платформу координации разработки лекарств, условия сделки не раскрыты (OpenAI).
- Holon-S1: модель Sophont предсказывает активность генов по обычным гистологическим снимкам, проверена на 16 типах органов и более чем 15 сканерах (iScienceLuvr).
- Научные статьи от ИИ: GPT-6 Astra и Claude Fable 5.1 получили по $10 000 на исследование, но авторы исходных работ отклонили обе статьи (sayashk).
- Проспект Anthropic: по данным WSJ, выручка за первое полугодие — $16,3 млрд, расходы на вычисления — почти $9 млрд (kimmonismus).
Хотите озвучивать ролики без диктора? Напишите боту слово ГОЛОС — пришлю разбор, как клон голоса помогает перестать платить диктору за каждый ролик: https://t.me/consultant_ai_skills_bot?start=GOLOS_blog