PHP2Shell: дыра 9,2 из 10 в WordPress и Drupal — AI-дайджест
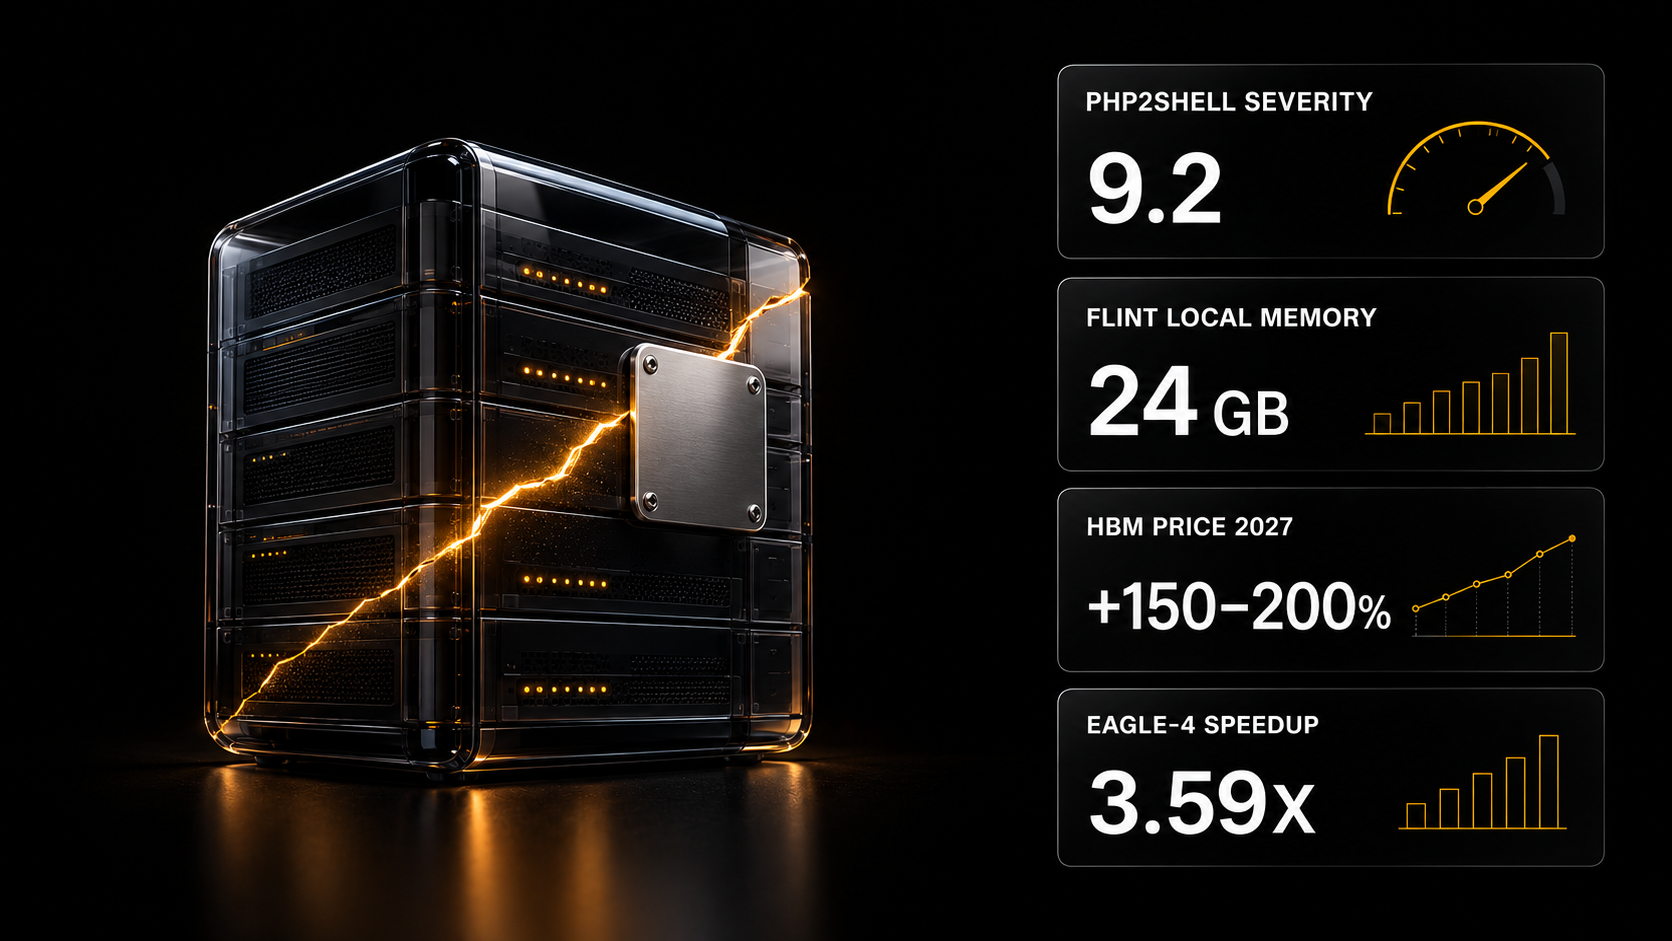
В ядре PHP нашли две уязвимости с оценкой 9,2 из 10 — под ударом сайты на WordPress, Drupal и Joomla. Ещё: модель для кода Recursive Flint на 24 ГБ памяти, рост цен на HBM на 150–200% и Kling 4.0 в API.
Главное для вас сегодня: 21 октября 2026 года в ядре PHP нашли две уязвимости с оценкой 9,2 из 10 — под ударом сайты на WordPress, Drupal и Joomla, то есть большая часть сайтов малого бизнеса. Если у вас или у ваших клиентов сайт на PHP, обновление на этой неделе важнее любой новой модели.
Главное сегодня
PHP2Shell: две уязвимости с оценкой 9,2 из 10 открывают сайты на WordPress, Drupal и Joomla
Исследователи раскрыли PHP2Shell — две ошибки работы с памятью в обработке ошибок самого PHP; по их данным, они дают взломать сайт на WordPress, Drupal или Joomla без пароля.
Wiz оценила уязвимости в 9,2 балла по шкале CVSS. OpenAI сообщает, что её модели помогли найти дыры в рамках программы Patch the Planet, а исправление два месяца готовили вместе с разработчиками PHP. Wiz пришла к той же находке независимо, с помощью Gemini 4 Argon. Cloudflare включила временные правила защиты для всех клиентов, включая бесплатный тариф, и уже видит первые атаки. АНБ США советует готовить обновления, а если защититься нельзя — отключать системы.
Удалённое выполнение кода (RCE) — это когда атакующий запускает свои команды на вашем сервере, не зная пароля.
Что это значит: бизнес. Сайт салона или магазина на WordPress — первая цель. Правила Cloudflare — заплатка на время: в Cloudflare прямо говорят, что обновление PHP они не заменяют. OpenAI выпустила скилл для Codex, который проверяет, задет ли ваш сайт.
Источники: раскрытие · масштаб · Wiz · OpenAI · Cloudflare · АНБ · скилл для проверки
Recursive Flint: модель для кода, которой хватает 24 ГБ памяти
Recursive выпустила Flint — открытую модель для программирования на 40 млрд параметров, из которых на каждый токен работают 2,5 млрд; по данным LM Studio, для запуска нужно около 24 ГБ памяти.
Лицензия Apache 2.0 разрешает коммерческое использование. Окно контекста — 262 тыс. токенов. Компания заявляет 54,9% в Terminal-Bench 2.1 и 74,2% в SWE-bench Verified; независимой проверки этих цифр пока нет. Пользователь намерил 114–132 токена в секунду на M5 Max. На OpenRouter модель на старте доступна бесплатно.
MoE-модель — это модель, у которой на каждый запрос работает только часть параметров. Поэтому Flint с 40 млрд параметров отвечает со скоростью маленькой модели.
Что это значит: кошелёк. Для вайбкодинга и правок в коде клиента у вас появляется помощник, за которого не платят за каждый запрос, а код не уходит на чужой сервер. С облачными агентами на сложных задачах я бы его пока не сравнивал — Recursive сама называет Flint дополнением к ним.
Источники: Recursive · LM Studio · результаты · замер скорости · OpenRouter · гид по открытым LLM
Samsung продала всю память HBM на 2027 год: цены вырастут на 150–200%
Samsung, по данным GSMArena, заранее продала около 70% обычной памяти DRAM и 100% памяти HBM на следующий год; HBM, по оценкам, подорожает на 150–200%, DRAM — на двузначный процент в первом квартале 2027 года.
HBM — это быстрая память, которая стоит в видеокартах для нейросетей. Спрос на неё растёт и без того: по данным Reuters, ByteDance, Alibaba и Tencent заказали у Nvidia чипов больше чем на $35 млрд. Технический директор Intel рассказал Дваркешу Пателу, что вычисления для ИИ десять лет росли втрое в год, а нынешних станков в мире хватит, чтобы только удвоить выпуск самых передовых пластин.
Что это значит: кошелёк. Компьютер под локальную модель в 2027 году будет дороже. Если покупка всё равно нужна — например, для клиники, где данные нельзя отдавать наружу, — откладывать её смысла нет. Остальным выгоднее облако: на облачных сервисах одну видеокарту делят многие пользователи.
Источники: GSMArena · r/LocalLLaMA о памяти · Reuters · Dwarkesh Podcast
Kling 4.0 вышел в API: сложные движения и один герой через все кадры
Kling открыла API для модели видео Kling 4.0; заявленные улучшения — стабильность сложных движений, постоянство героя по референсу и управление камерой.
Сначала модель появилась в интерфейсе и агенте fal с пометкой «API скоро», затем Kling объявила официальный запуск API. Цен в анонсах нет. Постоянство по референсу — это когда лицо и одежда героя не меняются от кадра к кадру: раньше именно на этом разваливались серии роликов с одним персонажем.
Что это значит: работа на заказ. Короткий ролик на рынке стоит $18–45 (лента заказов, 5 986 заказов за 4 месяца; наш прайс-лист исполнителя). Серию роликов с одним героем Kling 4.0 обещает делать без расползания лица от кадра к кадру. Цену генерации я бы посчитал на пробном ролике до того, как называть сумму клиенту.
Источники: fal · Kling · генератор промптов для видео
OO-Harness и Agent S4: та же модель решает на 16 пунктов больше задач, если сменить обвязку
Две новые работы показывают, что обвязка вокруг агента меняет результат сильнее, чем кажется: OO-Harness подняла AutomationBench с 61,6% до 77,4% при той же модели Gemini 3.5 Flash.
Харнес — это кухня вокруг повара: инструменты, правила и порядок шагов, в которых работает модель. В OO-Harness это специализированные подклассы, уроки из прошлых запусков и маршрутизация; на Workspace-Bench результат вырос с 25,5% до 39,5%. Agent S4 строит инструменты сам по прошлым попыткам, без разметки успеха: открытая модель на 27 млрд параметров набрала 21,3% в OSWorld V2 — в 3,8 раза больше, чем с интерфейсами, собранными вручную.
Что это значит: для технаря. Все сравнивают модели — считать надо обвязку. Прежде чем платить за модель дороже, проверьте, что даст перестройка инструментов вокруг нынешней.
Источники: OO-Harness · Agent S4 · шаблоны автоматизаций
EAGLE-4: ответы модели в 3,6 раза быстрее без смены модели
Вышел EAGLE-4 — стек спекулятивного декодирования, который ускоряет Qwen3.8-27B в 3,59 раза против обычного вывода; у конкурентов DFlash 2 и DSpark — 2,80 и 2,57 раза.
Спекулятивное декодирование — это когда маленькая модель-черновик угадывает несколько слов вперёд, а большая только проверяет их, и ответ идёт быстрее. На четырёх NVIDIA B300 при одном запросе ускорение составило 3,42 раза в SGLang, 2,83 — в vLLM и 3,09 — в TokenSpeed. При большом числе одновременных запросов выигрыш, по данным авторов, меньше. Черновая модель EAGLE-4 примерно на 3 ГБ больше, чем у DFlash 2.
Что это значит: для технаря. Для чат-бота с небольшим потоком запросов это втрое более быстрые ответы на том же железе. Если видеопамять уже занята под завязку, лишние 3 ГБ могут не влезть.
Источники: r/LocalLLaMA · EAGLE-4
Cohere Rerank 5: поиск по документам тратит до 41% меньше токенов
Cohere выпустила Rerank 5 в версиях Pro и Fast; режим Context Focus возвращает модели оценённые фрагменты, а не документы целиком, и, по данным компании, сокращает расход токенов до 41% без потери точности.
Реранкер — это модель, которая из найденных документов выбирает самые подходящие к вопросу, прежде чем их прочитает основная модель. В тот же день NVIDIA Nemotron 3.5 Parse — модель для разбора документов меньше чем на 1 млрд параметров — заняла первое место в тесте ParseBench.
Что это значит: для технаря. Бот, который отвечает по базе документов компании, платит в основном за то, что читает. Подача фрагментов вместо целых файлов сокращает этот счёт почти на 40%, если заявленные цифры подтвердятся на ваших документах.
Источники: Cohere · доступность · ParseBench
Цифры и факты
Собственная сводка: сколько стоит железо под нейросети по данным на 21 октября 2026 года.
| Что | Цена или требование | Откуда |
|---|---|---|
| Recursive Flint локально | около 24 ГБ памяти | LM Studio |
| NVIDIA RTX PRO 5500 | около $11 400 за карту | r/LocalLLaMA |
| NVIDIA RTX 6000 Pro | $16 000 | r/LocalLLaMA |
| Память HBM в 2027 году | +150–200% к цене | GSMArena |
- 41,7% — у Claude Sonnet 5.5 и GPT-6 Astra в обновлённом медицинском тесте MLCR-AA; ни одна модель не превысила 42% при требовании полноты и точности одновременно (Artificial Analysis). Ответы Claude в среднем в 4–6 раз длиннее, чем у OpenAI (сравнение).
- 5–10% запрошенного Nvidia может отгрузить китайским покупателям: по словам источника, в 2027 году компания выпустит не больше 3 млн RTX PRO 5500 при заказах больше 6 млн (r/LocalLLaMA).
- 1,5 млн против 60 тыс. входных токенов в секунду на ускоритель — так отличается пропускная способность DeepInfer с попаданиями в кэш и без них при 96% попаданий (ZhihuFrontier).
- 770 токенов в секунду — заявленная скорость Muse Spark Open на TPU через плагин SGLang для открытого Google TorchTPU (Google, SGLang).
- 19 узлов вместо 16 — столько серверов HGX B200 Lambda уместила в прежний лимит мощности с DSX MaxLPS (Lambda).
- В 6,5 раза меньше токенов обучения нужно методу JOLT от Perplexity и NVIDIA, чтобы сравняться с GRPO на MATH (Аравинд Шринивас).
Разные точки зрения: стоит ли брать б/у RTX 3090 под локальные модели после «разблокировки»?
Автор поста в X заявил, что модуль ядра «gpu-unlock» поднимает скорость BF16 на RTX 3090 с 82 до 155 TFLOPS; на реальных задачах, по замерам участников обсуждения, выигрыш составляет около 10–12% на обработке запроса.
- За. Если заявленные цифры подтвердятся, старая карта с 24 ГБ памяти станет заметно быстрее в обучении и обработке длинных запросов (r/LocalLLaMA).
- Нейтрально. Вычисления BF16 занимают лишь часть времени ответа модели, а остальное упирается в память; кроме того, неясно, переживёт ли модификация обновления драйверов и CUDA (r/LocalLLaMA).
- Против. Главное опровержение в прошлом обсуждении: практических ускорений на реальных нагрузках пока не показано, а прогнозы, что б/у 3090 станет дороже 5090, комментаторы называют фантазией (опровержение).
Инструменты и приёмы
- Попросите агента проверить ваши проекты на PHP2Shell одной фразой. Бен Тосселл из Ben's Bites написал Codex: «Проверь, используют ли мои проекты PHP или Railway, оцени риски и устрани их» (Ben's Bites). Для сайтов OpenAI выпустила отдельный скилл проверки (OpenAI). Что получится: список проектов под угрозой и план обновления без ручного обхода каждого сайта.
- Проверьте код на Claude API перед обновлением SDK. Версия API
2026-10-21убрала из Messages параметрыtemperature,top_pиtop_k; новые мажорные версии SDK используют её по умолчанию, версия2023-06-01по-прежнему поддерживается (ClaudeDevs, SDK). Что получится: бот, который вы сдали клиенту, не сломается после планового обновления зависимостей. - Соберите моушн-графику из описания сцены кодом. psychopomp превращает сцену, описанную кодом, в ролик с моушн-графикой (Ben's Bites). Что получится: заставки и инфографика для роликов клиента без ручной анимации в редакторе.
Коротко
- Claude Duet: Anthropic открыла лист ожидания проактивного помощника на Opus 5.5 — первыми доступ получают пользователи Pro и Max в США; покупки идут через кошелёк Link от Stripe (Майк Кригер, доступ, Stripe).
- Ядро Linux: коммит 14c8977 Линуса Торвальдса убрал требование помечать код, написанный с помощью ИИ, строкой «Assisted-by» (r/singularity).
- Waymo: 0,01 серьёзной аварии на миллион миль против 0,21 у людей на 271,3 млн миль без водителя; компания хочет вырасти до 20 000 машин к концу 2027 года (r/singularity, данные).
- Railway: после инцидента безопасности клиенты 17 часов не могли обновить свои сервисы (Railway, Тео).
- GitLab: уязвимость с оценкой 10 из 10 позволяет выполнить код на самостоятельно размещённых серверах без входа, исправления уже вышли (отчёт).
- GPT-Rosalind: тысячи агентов OpenAI за 32 минуты связали данные по миллионам клеток мозга мыши с публикациями и предложили гипотезы для проверки (OpenAI).
- Mirendil: базовую модель, по словам компании, собрал один исследователь за 3,5 месяца и меньше чем за $10 млн на вычисления (Бехнам Нейшабур).
- SuperMimic: обучение гуманоида на 129 514 движениях заняло 3 часа на одной видеокарте против 7 дней на 128 в прежнем подходе (результаты).
- Ornith-1.5-122B: открытая модель на 122 млрд параметров для рассуждений и кода с контекстом 262 тыс. токенов (Hugging Face).
- Kill My SaaS: Latent Space предложила разработчикам заменить сервис для управления спикерами конференции, за который просили $43 000 в год (Latent Space).
- Anthropic: в Long-Term Benefit Trust вошёл физик-экспериментатор Кристофер Стаббс, бывший декан по науке в Гарварде (Anthropic).
Ведёте сайты клиентам или хотите продавать услуги малому бизнесу? Напишите боту слово КЛИЕНТ — пришлю разбор, что продать салону, кофейне, автосервису и сколько это стоит: https://t.me/consultant_ai_skills_bot?start=KLIENT_blog