DeepSeek V4.1 Flash: уязвимость за $2,40 — AI-дайджест
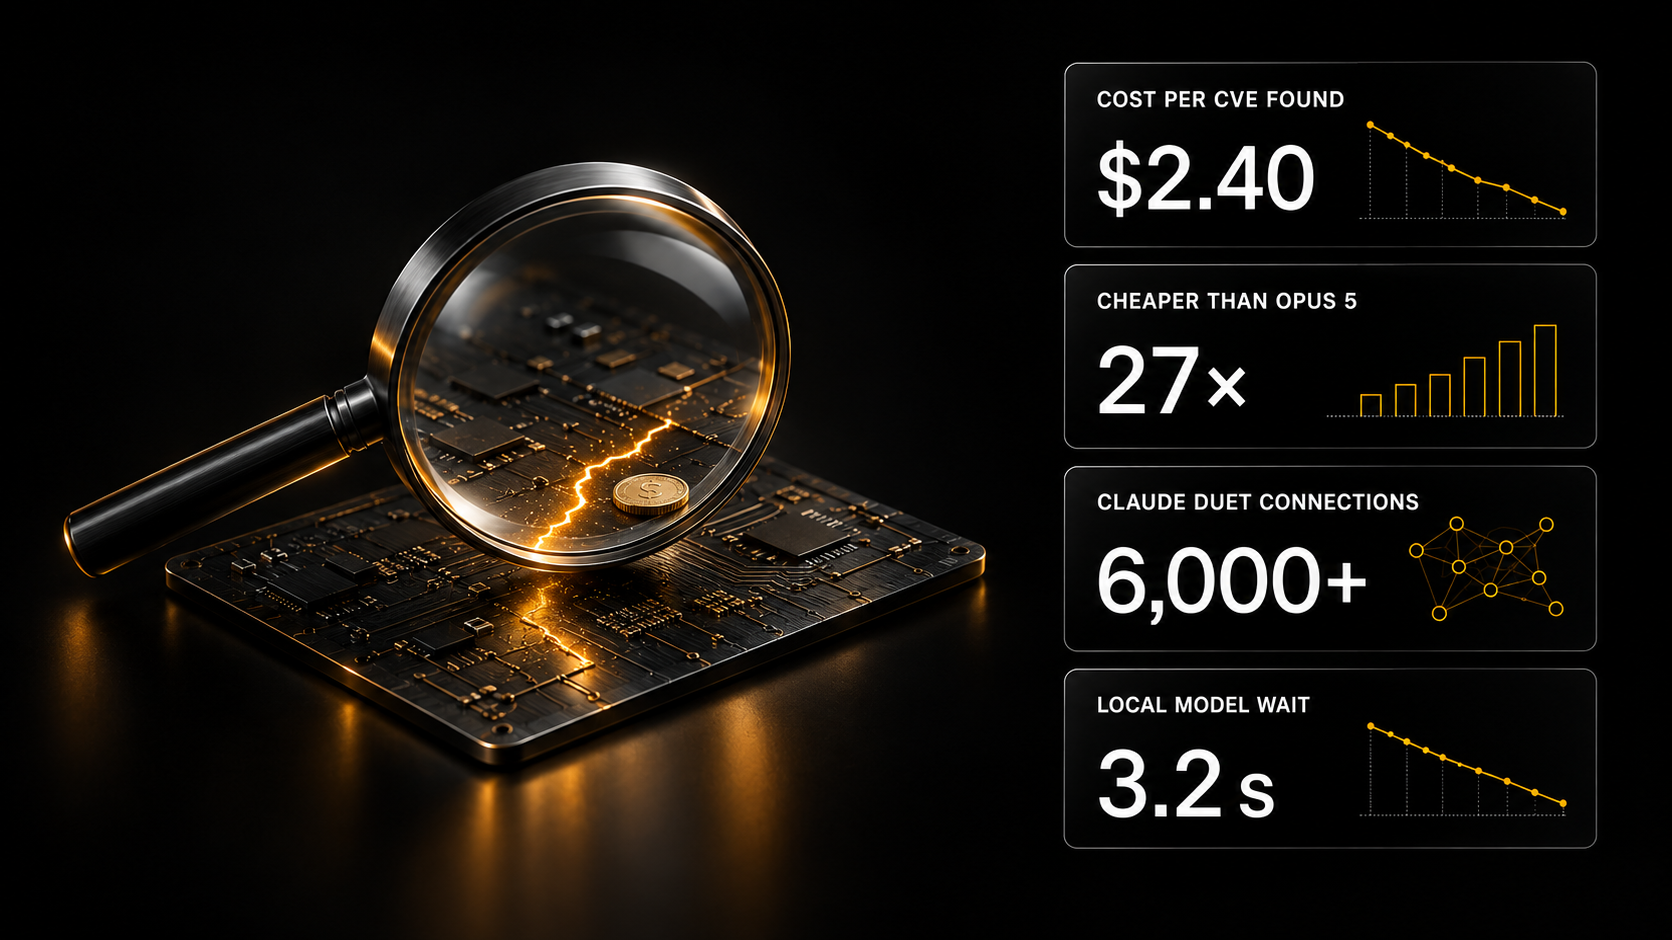
DeepSeek V4.1 Flash находит 87,5% известных уязвимостей теста по $2,40 за находку — в 27 раз дешевле Opus 5. Ещё: что внутри Claude Duet, локальная модель без долгого ожидания и почему 5 из 9 моделей не заработали на бирже.
Главное для вас сегодня: проверка кода на известные уязвимости подешевела до $2,40 за находку — столько, по независимому замеру, тратит DeepSeek V4.1 Flash против $64,96 у Opus 5. Если вы сдаёте клиентам сайты или ботов, такую проверку уже можно делать регулярно, но помнить границу: найти известную дыру и найти новую — разные задачи, и вторую модели пока решают плохо.
Главное сегодня
DeepSeek V4.1 Flash: известная уязвимость за $2,40 — в 27 раз дешевле Opus 5
DeepSeek V4.1 Flash нашла 87,5% известных уязвимостей тестового набора и потратила $2,40 на каждую находку — по замеру, опубликованному 22 октября 2026 года.
Лучше результат только у GPT-6 Astra — 90,6%, но находка там стоит $135,23. У Opus 5 одна найденная уязвимость обходится в $64,96. Я посчитал: DeepSeek V4.1 Flash дешевле Opus 5 в 27 раз и дешевле GPT-6 Astra в 56 раз при разнице в доле находок 3,1 пункта.
CVE — это публичный номер уже известной уязвимости в общем реестре. Результат засчитан по правилу pass@3: модель получила три попытки, и хватало одной удачной.
Что это значит: кошелёк. Прогнать свой или клиентский код по известным уязвимостям теперь стоит единицы долларов, а не десятки. Это поиск известного, а не аудит безопасности — так и называйте услугу в договоре.
Источники: замер
Claude Duet: 6 000 подключений и подтверждение перед каждым платежом
Claude Duet — проактивный агент Anthropic на Opus 5.5: он сам следит за подключёнными сервисами, собирает сводку приоритетов и ведёт фоновые задачи в собственной виртуальной машине и браузере.
У Claude Duet больше 6 000 подключений, среди них Gmail, Slack, QuickBooks, Stripe, Shopify, Docusign и HubSpot. Отправку сообщений, платежи, подписи и удаление агент выполняет только после подтверждения человеком; пароли изолированы от модели. Доступ пока по листу ожидания для подписчиков Pro и Max в США. 25 октября 2026 года ведущий The AI Daily Brief сравнил Claude Duet с ChatGPT Dots и объяснил, почему проактивные агенты, возможно, наконец находят место в его работе.
Рядом появились две защиты: 1Password for Agents подставляет пароль, не показывая его агенту, а Composio Firewall проверяет каждое действие агента и каждый ответ сервиса.
Что это значит: бизнес. Магазин или салон получает агента, который ведёт почту, оплату и витрину, но платёж подтверждает человек. Я бы начинал с доступа только на чтение и расширял по одному сервису.
Источники: Anthropic · r/singularity · The AI Daily Brief · 1Password for Agents · Composio Firewall
MAFDET: локальная модель думает, пока вы печатаете — ожидание с 12,2 до 3,2 секунды
MAFDET — открытая оболочка для локальных моделей на llama.cpp, которая начинает считать ещё до нажатия Enter и сокращает ожидание ответа почти вчетверо.
На видеокарте RTX 2060 с 6 ГБ памяти среднее ожидание после Enter у Qwen3-4B упало с 12,2 до 3,2 секунды, все 24 текстовые задачи решены верно. У Qwen3-14B, которая помещается в память только наполовину, — со 108 до 47 секунд. Установку под CUDA или процессор программа делает сама.
KV-кэш — это память модели о прочитанном тексте: заполнил заранее — после Enter пересчитывать нечего. MAFDET заполняет его по ходу набора, а для Qwen3 ещё и заранее набрасывает рассуждение. Комментаторы предупреждают: если исправить число в уже набранном вопросе, модель может ответить по черновику.
Что это значит: работа на заказ. Ассистент под отдел, где документы не должны уходить наружу, на рынке стоит $240–1 200, и главная жалоба на него — «долго думает». Теперь ждать заметно меньше даже на старой видеокарте.
Источники: r/LocalLLM · репозиторий · гид по открытым моделям
Quant-Arena: только 4 из 9 моделей заработали на закрытом годе торгов
Quant-Arena, запущенная 22 октября 2026 года, дала 9 моделям торговать на целом годе данных китайских акций, скрытом от них заранее, — в плюс вышли только 4.
A-акции — это акции компаний материкового Китая, которые торгуются в юанях. Скрытый год означает, что подсмотреть исход в обучающих данных модель не могла.
В тот же день Latent Space выпустил разговор с Анекой Сохал, бывшим трейдером энергетических деривативов. Её компания Moshi строит рекомендательную систему, которая связывает поток рыночной информации с позициями конкретного трейдера; сама она описывает продукт как смесь Bloomberg, Claude и Netflix.
Что это значит: профессия и доверие. Финансисту ИИ уже годится, чтобы разбирать новости под свой портфель. Решение о сделке ему отдавать рано: на честном тесте больше половины моделей не заработали.
Источники: Quant-Arena · Latent Space
Agent Relay и Handoff: один рабочий контекст для Claude Code, Codex и Cursor
Agent Relay — открытый инструмент, вышедший 23 октября 2026 года, через который агенты читают сессии друг друга, задают вопросы и передают работу между Codex, Claude и Conductor.
Новой модели в Agent Relay нет: он решает координацию агентов из разных программ. Соседний открытый проект Handoff делает то же через файл: состояние работы сохраняется один раз, и его подхватывает любой агент — Claude Code, Codex, Cursor, Copilot или Gemini CLI.
Харнес — это обвязка вокруг модели: инструменты, память, правила. Если модель — повар, харнес — кухня, и обе находки чинят кухню, а не повара.
Что это значит: для технаря. Проект, который вы ведёте в двух агентах, больше не нужно пересказывать с нуля каждой новой сессии: контекст переезжает вместе с работой.
Источники: Agent Relay · Handoff
Agent4Sci: три скилла удвоили прирост Opus — с 10,4% до 20,1%
В исследовании Anthropic Agent4Sci агенты превзошли лучший опубликованный результат на всех 20 научных ML-бенчмарках, а три скилла-обвязки подняли средний прирост Opus с 10,4% до 20,1%.
Скилл — это файл с инструкциями и приёмами, который агент подгружает под задачу. Отдельное исследование World of SWECraft потратило больше 10 000 агент-часов на связанные между собой программные пакеты и получило до 1,31 раза выигрыша в эффективности. Авторы заметили, что часть передовых моделей прекращает искать улучшения, хотя возможности ещё есть: упорство — отдельное качество, не равное силе модели.
Что это значит: для технаря. Прежде чем платить за модель дороже, допишите текущей скиллы: в Agent4Sci это дало вдвое больший прирост без смены модели.
Источники: Agent4Sci · World of SWECraft · гид по скиллам Claude Code
DeepSeek и MiniMax прошли экспортную регистрацию в Китае: открытые веса продолжат выходить
DeepSeek и MiniMax завершили регистрацию в Министерстве коммерции Китая, которую требуют новые временные правила экспортного контроля ИИ, — об этом 22 октября 2026 года сообщило китайское издание Yuyuan Tantian.
По данным издания, регистрация позволяет обеим компаниям и дальше выкладывать открытые веса за рубежом, заключать международные партнёрства и выпускать обновления моделей. Проект поправок к экспортному контролю Китая мы разбирали в выпуске 17 октября. Участники обсуждения ждут, что Zhipu и Alibaba пройдут ту же процедуру.
Открытые веса — это файлы обученной модели, которые можно скачать и запустить у себя; код обучения и данные к ним обычно не прилагаются.
Что это значит: для технаря. Кто строит на DeepSeek V4.1 Flash или MiniMax M3.1 Flash у себя, получил меньше риска, что следующую версию не выложат.
Источники: r/LocalLLaMA · Yuyuan Tantian · Open Source на AI SKILLS
Цифры и факты
Наша сводка: сколько стоит одна найденная известная уязвимость у разных моделей, по замеру от 22 октября 2026 года.
| Модель | Доля найденных (pass@3) | Цена одной находки | Во сколько раз дороже DeepSeek V4.1 Flash |
|---|---|---|---|
| DeepSeek V4.1 Flash | 87,5% | $2,40 | — |
| Opus 5 | нет данных | $64,96 | в 27 раз |
| GPT-6 Astra | 90,6% | $135,23 | в 56 раз |
Источник цифр — замер; колонку кратности посчитал я.
- $0,04 за миллион входных токенов — цена SubQ Snap 1.1 с контекстом 384 тыс. токенов; на Decision Index от Artificial Analysis модель набрала 65 баллов, как d1-ultra и Elephant 9B (Artificial Analysis).
- $0,21 за 1 000 заявлений — столько стоит d1-ultra на ClaimBench, где она разобрала все заявления без ошибок (Vals).
- 0,5 млрд параметров у Ming-3.0-tts от Ant — синтез речи под лицензией MIT попал в верхний эшелон рейтинга Artificial Analysis (Artificial Analysis).
- 41,5% против 36,2% — Qwen3 на 8 млрд параметров, дообученная Meta, выбирает нужный инструмент из каталога в 10 000+ позиций на ToolBench G3 после дообучения с подкреплением против обычного дообучения (разбор).
- 325 TFLOPS в BF16 при 600 Вт у ускорителя Huawei Ascend 950PR — около 44% от H100 (замер).
- На 12% выросла скорость генерации DeepSeek V4.1 Flash на четырёх RTX 6000 Pro после замены ядер обмена данными между картами (ядра).
Разные точки зрения: успеет ли защита за ИИ, который находит дыры?
DeepSeek V4.1 Flash находит 87,5% известных уязвимостей тестового набора по $2,40 за находку, но новые ошибки модели находят намного хуже: по замеру SWE-sweep даже GPT-6 Astra находит меньше 10% реальных ошибок.
- За. Джошуа Сакс считает, что рост возможностей не даёт сразу такого же роста ущерба: внедрение в компаниях, кадры, доступ к моделям и полиция сдерживают злоумышленников, и у защитников есть временное окно — это не значит, что возможности безвредны (Джошуа Сакс).
- Нейтрально. По SWE-sweep модели OpenAI и Anthropic стали находить вдвое больше ошибок за половину прежней цены, но доля найденных реальных ошибок пока ниже 10% (SWE-sweep).
- Против. На Reddit разошлось видео, где Сэм Альтман, по словам автора поста, говорит: «Я больше не думаю, что мы сможем закрыть все уязвимости»; само видео проверить не удалось. А аудиторы METR и Redwood Research, проверявшие надзор за агентами внутри OpenAI, нашли, что после сжатия контекста около 10% подходящего внутреннего трафика Codex оставалось без мониторинга (r/OpenAI, разбор).
Инструменты и приёмы
- Следите за уязвимостями без технических бюллетеней. cve.now собирает четыре ленты CVE и объясняет каждую запись простым языком (cve.now). Что получится: за минуту понять, касается ли новая дыра сайта или бота, которые вы сдали клиенту.
- Дайте агенту не только найти, но и починить. Cognition открыла код плагина для исправления уязвимостей агентом (Cognition). Что получится: после проверки кода — готовая правка на ревью, а не список проблем.
- Соберите библиотеку промптов для команды у себя. prompts.chat — открытая коллекция промптов со 174,5 тыс. звёзд на GitHub, которую можно развернуть на своём сервере для всей организации (prompts.chat). Что получится: общая база запросов без передачи данных наружу; готовые шаблоны есть и в библиотеке промптов AI SKILLS.
Коротко
- Лимиты Claude: по утверждению SemiAnalysis, Anthropic проверяет новые лимиты на части пользователей — месячный объём в пересчёте на цены API меньше примерно на 20%, а пятичасовые лимиты выше (SemiAnalysis).
- ClinePass: Kimi K3.1 Pro доступна в Cline по подписке за $9,99 в месяц со скидкой на открытые модели (Cline).
- Datadog: компания, по данным The Information, предложила почти $4 млрд за Upwind Security (The Information).
- OpenAI: по данным WSJ, три исследователя, уволенные в сентябре 2026 года, добивались, чтобы цепочка рассуждений моделей оставалась видимой (Максвелл Зефф).
- Джон Бэррон: нашёл 2 численные ошибки в стандартной реализации softmax и cross-entropy; первую обнаружила Gemini Flash (исследование).
- Математика: Latent Space разбирает, почему модели стали сильны в математике, — от контрпримера внутренней модели OpenAI к гипотезе Эрдёша о единичных расстояниях, открытой с 1946 года (Latent Space).
Хотите знать, сколько брать за такую работу? Напишите боту слово ПРАЙС — пришлю прайс-лист исполнителя на ИИ: девять видов работ и вилку по каждому: https://t.me/consultant_ai_skills_bot?start=PRAIS_blog